CNN — konvolyutsion neyron tarmoqlar
Sahna: nega rasmlar uchun oddiy tarmoq yetarli emas
29-32-boblarda tarmoqlar jadval ma'lumotida oddiy modellardan ustun kelmadi. Har bobda shuni o'lchab ko'rdik.
Bu bobda birinchi marta boshqa natija kutamiz. Lekin kutish yetarli emas — o'lchaymiz.
Va natija men o'ylaganidan nozikroq chiqdi.
Rasm — bu matritsa
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "-1"
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
from sklearn.datasets import load_digits

torch.set_num_threads(4)
raqamlar = load_digits()
X_img = raqamlar.images / 16.0            # 0..16 -> 0..1
y_img = raqamlar.target

print(f"Rasmlar shakli : {X_img.shape}   -> {X_img.shape[0]} ta rasm, {X_img.shape[1]}x{X_img.shape[2]} piksel")
print(f"Sinflar        : {sorted(set(y_img))}")
print(f"Har sinfda     : {np.bincount(y_img)}")
print()
print("Bitta rasm — shunchaki 8x8 matritsa:")
print(np.round(X_img[0], 2))
Rasmlar shakli : (1797, 8, 8)   -> 1797 ta rasm, 8x8 piksel
Sinflar        : [np.int64(0), np.int64(1), np.int64(2), np.int64(3), np.int64(4), np.int64(5), np.int64(6), np.int64(7), np.int64(8), np.int64(9)]
Har sinfda     : [178 182 177 183 181 182 181 179 174 180]

Bitta rasm — shunchaki 8x8 matritsa:
[[0.   0.   0.31 0.81 0.56 0.06 0.   0.  ]
 [0.   0.   0.81 0.94 0.62 0.94 0.31 0.  ]
 [0.   0.19 0.94 0.12 0.   0.69 0.5  0.  ]
 [0.   0.25 0.75 0.   0.   0.5  0.5  0.  ]
 [0.   0.31 0.5  0.   0.   0.56 0.5  0.  ]
 [0.   0.25 0.69 0.   0.06 0.75 0.44 0.  ]
 [0.   0.12 0.88 0.31 0.62 0.75 0.   0.  ]
 [0.   0.   0.38 0.81 0.62 0.   0.   0.  ]]
rasm, axes = plt.subplots(2, 8, figsize=(14, 3.8))
for i, ax in enumerate(axes.ravel()):
    ax.imshow(X_img[i], cmap="gray_r")
    ax.set_title(str(y_img[i]), fontsize=11)
    ax.axis("off")
fig("raqamlar.png", caption="load_digits dataseti: 8x8 piksel, qo'lda yozilgan raqamlar. sklearn ichida — internet kerak emas.")
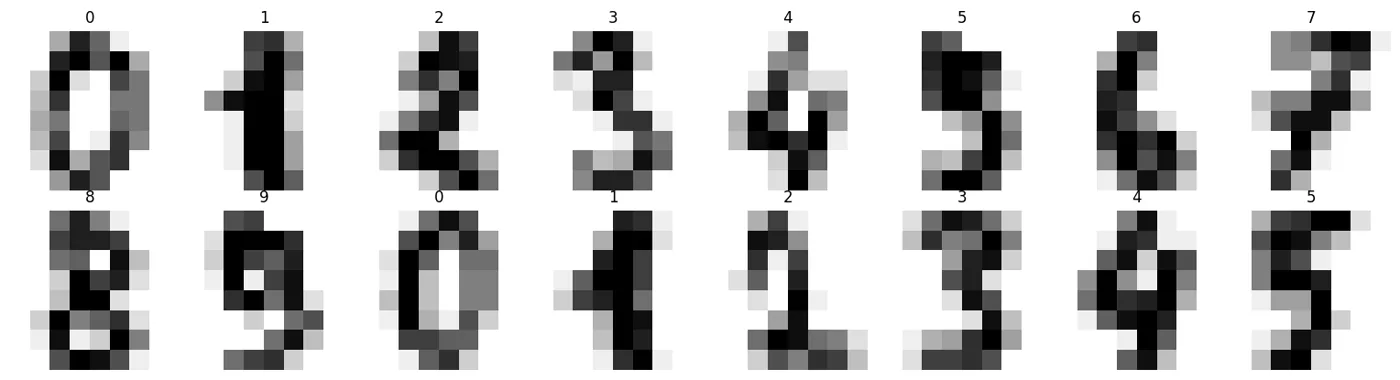
load_digits dataseti: 8x8 piksel, qo'lda yozilgan raqamlar. sklearn ichida — internet kerak emas.
Oddiy tarmoqning muammosi: fazoviy bog'liqlik yo'qoladi
nn.Flatten() 8x8 matritsani 64 elementli vektorga aylantiradi. Shunda nima yo'qoladi?
print("Flatten dan OLDIN — qo'shni piksellar bir-biriga yaqin:")
print(f"  (3,3) va (3,4) qo'shni   -> vektorda indeks {3*8+3} va {3*8+4}  (yonma-yon)")
print(f"  (3,3) va (4,3) qo'shni   -> vektorda indeks {3*8+3} va {4*8+3}  (8 ta uzoqda!)")
print()
print("Oddiy Dense qatlam uchun 64 element — shunchaki 64 ta mustaqil son.")
print("U '27 va 35 indekslar vertikal qo'shni' ekanini BILMAYDI.")
print()
# isbot: piksellarni ARALASHTIRAMIZ va natija o'zgarmaydi
r = np.random.default_rng(42)
tartib = r.permutation(64)
print("Isbot: hamma rasmda piksellarni BIR XIL tartibda aralashtiramiz.")
print("Agar Dense tarmoq fazoviy tuzilmani ishlatmasa, natija o'zgarmasligi kerak.")
Flatten dan OLDIN — qo'shni piksellar bir-biriga yaqin:
  (3,3) va (3,4) qo'shni   -> vektorda indeks 27 va 28  (yonma-yon)
  (3,3) va (4,3) qo'shni   -> vektorda indeks 27 va 35  (8 ta uzoqda!)

Oddiy Dense qatlam uchun 64 element — shunchaki 64 ta mustaqil son.
U '27 va 35 indekslar vertikal qo'shni' ekanini BILMAYDI.

Isbot: hamma rasmda piksellarni BIR XIL tartibda aralashtiramiz.
Agar Dense tarmoq fazoviy tuzilmani ishlatmasa, natija o'zgarmasligi kerak.
from sklearn.model_selection import train_test_split
from torch.utils.data import TensorDataset, DataLoader

def qur(turi):
    if turi == "dense":
        return nn.Sequential(nn.Flatten(), nn.Linear(64, 128), nn.ReLU(),
                             nn.Dropout(0.2), nn.Linear(128, 10))
    return nn.Sequential(
        nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),    # 8x8 -> 4x4
        nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),   # 4x4 -> 2x2
        nn.Flatten(), nn.Dropout(0.2), nn.Linear(32 * 2 * 2, 10),
    )

def oqit(Xtr, ytr, Xte, yte, turi, epoxalar=30):
    torch.manual_seed(42)
    m = qur(turi)
    f = ((lambda a: torch.tensor(a, dtype=torch.float32).unsqueeze(1)) if turi == "cnn"
         else (lambda a: torch.tensor(a, dtype=torch.float32)))
    dl = DataLoader(TensorDataset(f(Xtr), torch.tensor(ytr)), batch_size=64, shuffle=True,
                    generator=torch.Generator().manual_seed(42))
    opt = torch.optim.Adam(m.parameters(), lr=0.003)
    kriteriy = nn.CrossEntropyLoss()
    for _ in range(epoxalar):
        m.train()
        for xb, yb in dl:
            opt.zero_grad(); kriteriy(m(xb), yb).backward(); opt.step()
    m.eval()
    with torch.no_grad():
        aniq = float((m(f(Xte)).argmax(1) == torch.tensor(yte)).float().mean())
    return aniq, sum(p.numel() for p in m.parameters())

# piksellari aralashtirilgan versiya
X_aralash = X_img.reshape(len(X_img), -1)[:, tartib].reshape(-1, 8, 8)
Xtr, Xte, ytr, yte = train_test_split(X_img, y_img, test_size=.3, random_state=42, stratify=y_img)
Xtr_a, Xte_a, _, _ = train_test_split(X_aralash, y_img, test_size=.3, random_state=42, stratify=y_img)

a_normal, _ = oqit(Xtr, ytr, Xte, yte, "dense")
a_aralash, _ = oqit(Xtr_a, ytr, Xte_a, yte, "dense")
print(f"Dense, oddiy rasmlar          : {a_normal:.4f}")
print(f"Dense, piksellar aralashtirilgan: {a_aralash:.4f}")
print(f"Farq                          : {a_aralash - a_normal:+.4f}")
Dense, oddiy rasmlar          : 0.9778
Dense, piksellar aralashtirilgan: 0.9741
Farq                          : -0.0037
Natija deyarli bir xil — ya'ni Dense tarmoq fazoviy tuzilmani umuman ishlatmaydi. Siz rasmni aralashtirsangiz ham u sezmaydi.
CNN esa sezadi, chunki u qo'shni piksellarga qaraydi.
Konvolyutsiya: oynacha bo'ylab yurish
Konvolyutsiya — kichik filtr (yadro) rasm ustida yurib, har joyda bir xil amalni bajaradi.
def konvolyutsiya(rasm_2d, filtr):
    """Qo'lda konvolyutsiya — padding yo'q."""
    kh, kw = filtr.shape
    h, w = rasm_2d.shape
    natija = np.zeros((h - kh + 1, w - kw + 1))
    for i in range(natija.shape[0]):
        for j in range(natija.shape[1]):
            oyna = rasm_2d[i:i+kh, j:j+kw]
            natija[i, j] = float((oyna * filtr).sum())     # 11-bobdagi amal!
    return natija

# klassik filtrlar
filtrlar = {
    "vertikal chekka": np.array([[-1, 0, 1], [-1, 0, 1], [-1, 0, 1]], dtype=float),
    "gorizontal chekka": np.array([[-1, -1, -1], [0, 0, 0], [1, 1, 1]], dtype=float),
    "silliqlash": np.ones((3, 3)) / 9,
}
namuna = X_img[0]
rasm, axes = plt.subplots(1, 4, figsize=(15, 3.6))
axes[0].imshow(namuna, cmap="gray_r"); axes[0].set_title(f"asl (raqam {y_img[0]})"); axes[0].axis("off")
for ax, (nom, f_) in zip(axes[1:], filtrlar.items()):
    ax.imshow(konvolyutsiya(namuna, f_), cmap="gray_r")
    ax.set_title(nom, fontsize=10); ax.axis("off")
fig("filtrlar.png", caption="Bir xil rasm, uch xil filtr. Har filtr boshqa narsani ko'radi: vertikal chekka, gorizontal chekka, silliqlik.")

print("Konvolyutsiyaning ichi — 11-bobdagi skalyar ko'paytma:")
print(f"  natija[0,0] = sum(oyna * filtr)")
print()
print(f"Asl rasm shakli    : {namuna.shape}")
print(f"3x3 filtrdan keyin : {konvolyutsiya(namuna, filtrlar['silliqlash']).shape}  (chekkalar yo'qoladi)")
Konvolyutsiyaning ichi — 11-bobdagi skalyar ko'paytma:
  natija[0,0] = sum(oyna * filtr)

Asl rasm shakli    : (8, 8)
3x3 filtrdan keyin : (6, 6)  (chekkalar yo'qoladi)
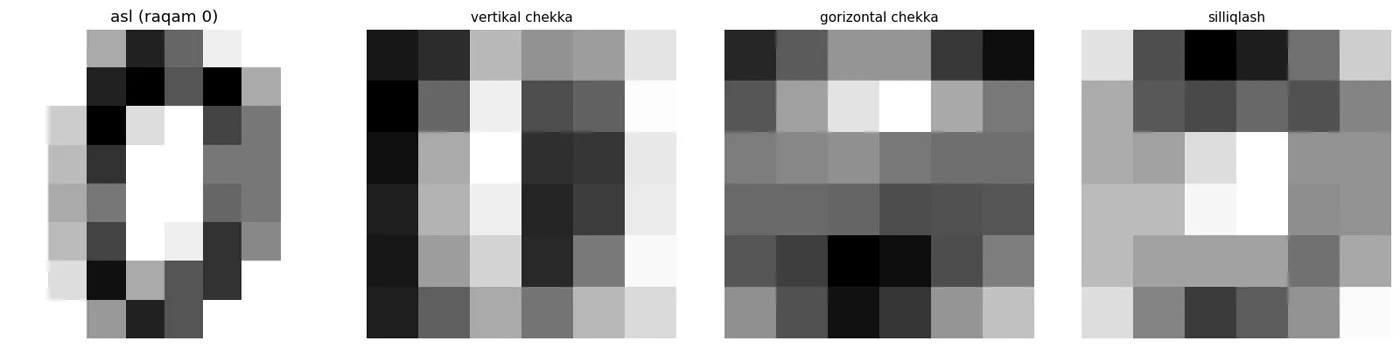
Bir xil rasm, uch xil filtr. Har filtr boshqa narsani ko'radi: vertikal chekka, gorizontal chekka, silliqlik.
CNN filtrlarni O'ZI o'rganadi
Yuqoridagi uchta filtrni men qo'lda yozdim — bu klassik kompyuter ko'rishi usuli (OpenCV kitobida batafsil).
CNN da esa filtr qiymatlari — o'qitiladigan parametrlar. Model o'zi hal qiladi: "bu vazifa uchun qanday filtr kerak?"
Shuning uchun nn.Conv2d(1, 16, 3) — 16 ta 3x3 filtr, hammasi gradient descent bilan topiladi.
print("Conv2d parametrlarini sanaymiz:")
conv = nn.Conv2d(1, 16, 3, padding=1)
print(f"  nn.Conv2d(1, 16, 3): {sum(p.numel() for p in conv.parameters())} parametr")
print(f"    = 16 filtr x (1 kanal x 3 x 3) + 16 bias = {16*9} + 16")
print()
dense_ekvivalent = 64 * 64
print(f"Taqqoslash: Dense(64, 64) = {dense_ekvivalent} parametr")
print()
print("Mana CNN ning ikkinchi afzalligi: PARAMETR ULASHISH (weight sharing).")
print("Bitta filtr butun rasm bo'ylab ishlatiladi — har joy uchun alohida vazn kerak emas.")
Conv2d parametrlarini sanaymiz:
  nn.Conv2d(1, 16, 3): 160 parametr
    = 16 filtr x (1 kanal x 3 x 3) + 16 bias = 144 + 16

Taqqoslash: Dense(64, 64) = 4096 parametr

Mana CNN ning ikkinchi afzalligi: PARAMETR ULASHISH (weight sharing).
Bitta filtr butun rasm bo'ylab ishlatiladi — har joy uchun alohida vazn kerak emas.
Pooling: o'lchamni kamaytirish
kichik = X_img[0]
mp = nn.MaxPool2d(2)
ap = nn.AvgPool2d(2)
t = torch.tensor(kichik, dtype=torch.float32).unsqueeze(0).unsqueeze(0)

rasm, axes = plt.subplots(1, 3, figsize=(12, 3.4))
axes[0].imshow(kichik, cmap="gray_r"); axes[0].set_title(f"asl 8x8"); axes[0].axis("off")
axes[1].imshow(mp(t)[0, 0].numpy(), cmap="gray_r"); axes[1].set_title("MaxPool2d(2) -> 4x4"); axes[1].axis("off")
axes[2].imshow(ap(t)[0, 0].numpy(), cmap="gray_r"); axes[2].set_title("AvgPool2d(2) -> 4x4"); axes[2].axis("off")
fig("pooling.png", caption="Pooling o'lchamni ikki barobar kamaytiradi. MaxPool eng kuchli signalni, AvgPool o'rtachani oladi.")

print(f"{'qadam':<28} {'shakl'}")
print("-" * 44)
x = t
print(f"{'kirish':<28} {tuple(x.shape)}")
for nom, qatlam in [("Conv2d(1,16,3,padding=1)", nn.Conv2d(1, 16, 3, padding=1)),
                    ("MaxPool2d(2)", nn.MaxPool2d(2)),
                    ("Conv2d(16,32,3,padding=1)", nn.Conv2d(16, 32, 3, padding=1)),
                    ("MaxPool2d(2)", nn.MaxPool2d(2)),
                    ("Flatten()", nn.Flatten())]:
    x = qatlam(x)
    print(f"{nom:<28} {tuple(x.shape)}")
qadam                        shakl
--------------------------------------------
kirish                       (1, 1, 8, 8)
Conv2d(1,16,3,padding=1)     (1, 16, 8, 8)
MaxPool2d(2)                 (1, 16, 4, 4)
Conv2d(16,32,3,padding=1)    (1, 32, 4, 4)
MaxPool2d(2)                 (1, 32, 2, 2)
Flatten()                    (1, 128)
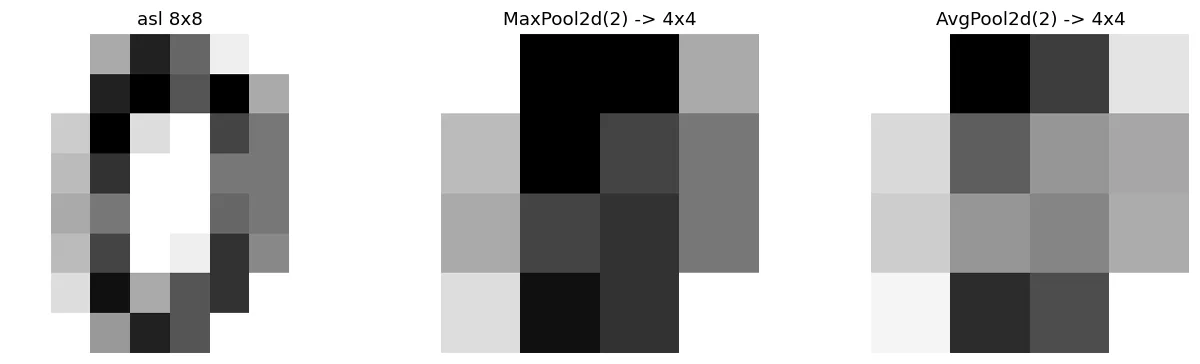
Pooling o'lchamni ikki barobar kamaytiradi. MaxPool eng kuchli signalni, AvgPool o'rtachani oladi.
`padding` va shakl hisobi — eng ko'p uchraydigan xato
Conv2d chiqish o'lchami: (kirish - yadro + 2*padding) / stride + 1
padding=1 va 3x3 yadro bilan o'lcham saqlanadi. Padding bo'lmasa har konvolyutsiyada 2 piksel yo'qoladi.
8x8 rasmda paddingsiz uch qatlam qo'ysangiz: 8 -> 6 -> 4 -> 2. To'rtinchi qatlam xato beradi.
Shakl xatolarini oldini olish uchun yuqoridagi jadval kabi har qadamda shape ni chop eting.
Asosiy savol: CNN haqiqatan ustunmi?
Endi o'lchaymiz. Ikki holat: rasmlar markazlashgan va siljitilgan.
def siljit(rasmlar, seed=0):
    """Har rasmni tasodifiy -2..+2 piksel siljitamiz."""
    r_ = np.random.default_rng(seed)
    natija = np.zeros_like(rasmlar)
    for i, im in enumerate(rasmlar):
        dx, dy = r_.integers(-2, 3, 2)
        natija[i] = np.roll(np.roll(im, dx, axis=0), dy, axis=1)
    return natija

X_siljigan = siljit(X_img)
rasm, axes = plt.subplots(2, 8, figsize=(14, 3.8))
for i in range(8):
    axes[0, i].imshow(X_img[i], cmap="gray_r"); axes[0, i].axis("off")
    axes[1, i].imshow(X_siljigan[i], cmap="gray_r"); axes[1, i].axis("off")
axes[0, 0].set_ylabel("asl"); axes[1, 0].set_ylabel("siljigan")
fig("siljish.png", caption="Yuqorida markazlashgan raqamlar, pastda tasodifiy siljitilgan. Inson ikkisini ham o'qiydi.")
print("Haqiqiy hayotda obyekt har doim markazda bo'lmaydi — shuning uchun bu sinov muhim.")
Haqiqiy hayotda obyekt har doim markazda bo'lmaydi — shuning uchun bu sinov muhim.
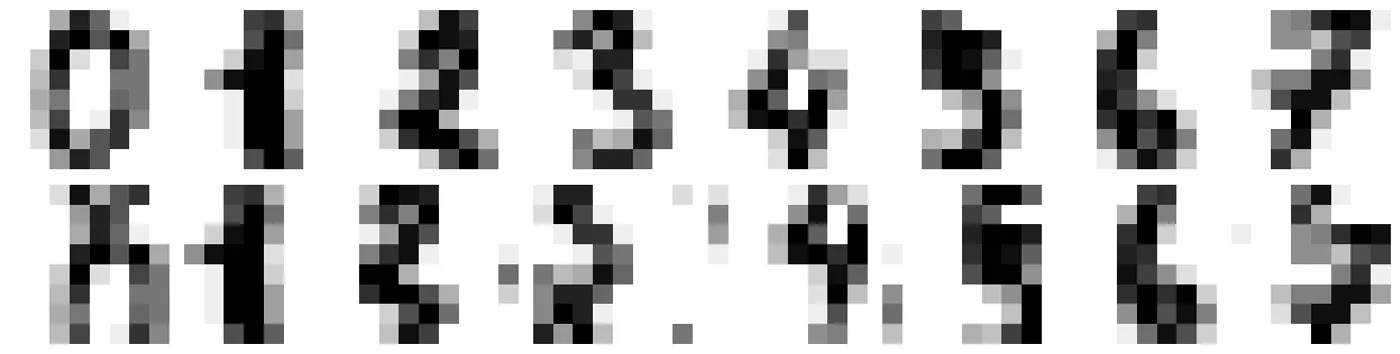
Yuqorida markazlashgan raqamlar, pastda tasodifiy siljitilgan. Inson ikkisini ham o'qiydi.
natijalar = []
for nom, Xd in [("markazlashgan (asl)", X_img), ("SILJITILGAN", X_siljigan)]:
    Xa, Xb, ya, yb = train_test_split(Xd, y_img, test_size=.3, random_state=42, stratify=y_img)
    for turi in ["dense", "cnn"]:
        a, n = oqit(Xa, ya, Xb, yb, turi)
        natijalar.append({"ma'lumot": nom, "model": turi, "aniqlik": round(a, 4), "parametrlar": n})
show(pd.DataFrame(natijalar))
| ma'lumot | model | aniqlik | parametrlar |
|---|---|---|---|
| markazlashgan (asl) | dense | 0.978 | 9 610 |
| markazlashgan (asl) | cnn | 0.976 | 6 090 |
| SILJITILGAN | dense | 0.693 | 9 610 |
| SILJITILGAN | cnn | 0.815 | 6 090 |
Mana natija, va u men kutganimdan nozikroq:
tab = pd.DataFrame(natijalar)
m_dense = tab[(tab["ma'lumot"].str.startswith("markaz")) & (tab.model == "dense")].aniqlik.iloc[0]
m_cnn = tab[(tab["ma'lumot"].str.startswith("markaz")) & (tab.model == "cnn")].aniqlik.iloc[0]
s_dense = tab[(tab["ma'lumot"] == "SILJITILGAN") & (tab.model == "dense")].aniqlik.iloc[0]
s_cnn = tab[(tab["ma'lumot"] == "SILJITILGAN") & (tab.model == "cnn")].aniqlik.iloc[0]
print(f"Markazlashgan rasmlarda: dense {m_dense:.4f}  vs  CNN {m_cnn:.4f}   -> farq {m_cnn-m_dense:+.4f}")
print(f"Siljitilgan rasmlarda  : dense {s_dense:.4f}  vs  CNN {s_cnn:.4f}   -> farq {s_cnn-s_dense:+.4f}")
print()
print(f"CNN parametrlari: {tab[tab.model=='cnn'].parametrlar.iloc[0]}")
print(f"Dense parametrlari: {tab[tab.model=='dense'].parametrlar.iloc[0]}")
Markazlashgan rasmlarda: dense 0.9778  vs  CNN 0.9759   -> farq -0.0019
Siljitilgan rasmlarda  : dense 0.6926  vs  CNN 0.8148   -> farq +0.1222

CNN parametrlari: 6090
Dense parametrlari: 9610
Markazlashgan rasmlarda CNN ustun kelmadi — ikkisi deyarli teng.
Siljitilgan rasmlarda esa CNN sezilarli yutdi — va bu kamroq parametr bilan.
CNN ning afzalligi "rasm" da emas — TRANSLYATSIYA INVARIANTLIGIDA
Men bu bobni "rasmda CNN har doim ustun" degan taxmin bilan boshlagandim. O'lchov buni yarim tasdiqladi.
load_digits rasmlari oldindan markazlashtirilgan — har raqam o'rtada. Shunda Dense tarmoq ham yetarli: u shunchaki "27-piksel yorug' bo'lsa, bu 7 bo'lishi mumkin" degan qoidalarni yodlab oladi.
Obyekt joyini o'zgartirsa esa Dense tarmoqning yodlagan qoidalari buziladi. CNN esa bir xil filtrni butun rasm bo'ylab yurgizadi, shuning uchun obyekt qayerda bo'lsa ham topadi.
Shuning uchun CNN quyidagi hollarda kerak: - obyekt pozitsiyasi o'zgaradi (haqiqiy fotosuratlar) - rasm katta (224x224 da Dense tarmoq uchun parametrlar portlaydi) - mahalliy naqsh muhim (chekka, tekstura, shakl)
Va kerak emas: kichik, markazlashtirilgan, bir xil ko'rinishdagi rasmlarda.
Data augmentation: CNN ni kuchaytirish
Siljish muammosini yana bir yo'l bilan yechish mumkin: train ma'lumotini ko'paytirish.
def kengaytir(Xtr_, ytr_, nusxa=3, seed=1):
    """Har rasmdan siljitilgan nusxalar yasaymiz."""
    r_ = np.random.default_rng(seed)
    Xs, ys = [Xtr_], [ytr_]
    for k in range(nusxa):
        Xs.append(siljit(Xtr_, seed=seed + k))
        ys.append(ytr_)
    return np.concatenate(Xs), np.concatenate(ys)

Xa, Xb, ya, yb = train_test_split(X_siljigan, y_img, test_size=.3, random_state=42, stratify=y_img)
Xa_keng, ya_keng = kengaytir(Xa, ya)
print(f"Train hajmi: {len(Xa)} -> {len(Xa_keng)}  (augmentatsiyadan keyin)")
print()
print(f"{'variant':<40} {'aniqlik':>9}")
print("-" * 52)
for nom, Xt_, yt_, turi in [
    ("dense, augmentatsiya YO'Q", Xa, ya, "dense"),
    ("dense, augmentatsiya BOR", Xa_keng, ya_keng, "dense"),
    ("CNN, augmentatsiya YO'Q", Xa, ya, "cnn"),
    ("CNN, augmentatsiya BOR", Xa_keng, ya_keng, "cnn"),
]:
    a, _ = oqit(Xt_, yt_, Xb, yb, turi)
    print(f"{nom:<40} {a:>9.4f}")
Train hajmi: 1257 -> 5028  (augmentatsiyadan keyin)

variant                                    aniqlik
----------------------------------------------------
dense, augmentatsiya YO'Q                   0.6926
dense, augmentatsiya BOR                    0.8037
CNN, augmentatsiya YO'Q                     0.8148
CNN, augmentatsiya BOR                      0.9019
Augmentatsiya — rasm bilan ishlashda eng arzon va eng kuchli usul. Siz yangi ma'lumot yig'masdan, mavjud ma'lumotdan ko'proq foyda olasiz.
Augmentatsiya faqat TRAIN ga qo'llanadi
Bu — 5-bobdagi qoidaning davomi. Test to'plamini augmentatsiya qilish mumkin emas: siz haqiqiy sharoitni simulyatsiya qilyapsiz, test esa haqiqiy sharoit bo'lishi kerak.
PyTorch da bu transforms orqali Dataset ichida qilinadi — shunda u faqat train DataLoader iga tegadi.
Tipik CNN arxitekturasi
show(pd.DataFrame([
    {"Blok": "1. Conv + ReLU", "Nima qiladi": "Mahalliy naqshlarni topadi (chekka, burchak)"},
    {"Blok": "2. Conv + ReLU", "Nima qiladi": "Naqshlardan shakllarni quradi"},
    {"Blok": "3. Pool", "Nima qiladi": "O'lchamni kamaytiradi, pozitsiyaga chidam beradi"},
    {"Blok": "(1-3 ni takrorlash)", "Nima qiladi": "Har takrorda tushunchalar abstraktroq bo'ladi"},
    {"Blok": "4. Flatten", "Nima qiladi": "Matritsani vektorga aylantiradi"},
    {"Blok": "5. Dense + chiqish", "Nima qiladi": "Yakuniy qaror"},
]))
| Blok | Nima qiladi |
|---|---|
| 1. Conv + ReLU | Mahalliy naqshlarni topadi (chekka, burchak) |
| 2. Conv + ReLU | Naqshlardan shakllarni quradi |
| 3. Pool | O'lchamni kamaytiradi, pozitsiyaga chidam beradi |
| (1-3 ni takrorlash) | Har takrorda tushunchalar abstraktroq bo'ladi |
| 4. Flatten | Matritsani vektorga aylantiradi |
| 5. Dense + chiqish | Yakuniy qaror |
torch.manual_seed(42)
cnn = qur("cnn")
print("Bizning CNN:")
x = torch.zeros(1, 1, 8, 8)
for i, qatlam in enumerate(cnn):
    x = qatlam(x)
    nomi = qatlam.__class__.__name__
    n_par = sum(p.numel() for p in qatlam.parameters())
    print(f"  {i}. {nomi:<12} -> {str(tuple(x.shape)):<18} parametr: {n_par}")
print(f"\nJami parametr: {sum(p.numel() for p in cnn.parameters())}")
Bizning CNN:
  0. Conv2d       -> (1, 16, 8, 8)      parametr: 160
  1. ReLU         -> (1, 16, 8, 8)      parametr: 0
  2. MaxPool2d    -> (1, 16, 4, 4)      parametr: 0
  3. Conv2d       -> (1, 32, 4, 4)      parametr: 4640
  4. ReLU         -> (1, 32, 4, 4)      parametr: 0
  5. MaxPool2d    -> (1, 32, 2, 2)      parametr: 0
  6. Flatten      -> (1, 128)           parametr: 0
  7. Dropout      -> (1, 128)           parametr: 0
  8. Linear       -> (1, 10)            parametr: 1290

Jami parametr: 6090
Transfer learning: kichik ma'lumotning yechimi
show(pd.DataFrame([
    {"Holat": "Ma'lumot 1000 dan kam", "Yechim": "Tayyor modelni oling, faqat oxirgi qatlamni o'qitng",
     "Nomi": "Feature extraction"},
    {"Holat": "Ma'lumot 1000-10000", "Yechim": "Tayyor model + oxirgi bloklarni ham o'qitish",
     "Nomi": "Fine-tuning"},
    {"Holat": "Ma'lumot 100000+", "Yechim": "Noldan o'qitish mumkin",
     "Nomi": "Training from scratch"},
]))
print()
print("Nega ishlaydi: birinchi qatlamlar chekka va tekstura topadi —")
print("ular MUSHUK rasmida ham, RENTGEN rasmida ham bir xil kerak.")
print()
print("Amalda: torchvision.models yoki HuggingFace dan tayyor model olinadi.")
print("Bu bobda internetsiz ishlaganimiz uchun yuklab olmadik —")
print("YOLO kitobida (o'quv rejadagi 11-bosqich) buni to'liq ko'rasiz.")
Nega ishlaydi: birinchi qatlamlar chekka va tekstura topadi —
ular MUSHUK rasmida ham, RENTGEN rasmida ham bir xil kerak.

Amalda: torchvision.models yoki HuggingFace dan tayyor model olinadi.
Bu bobda internetsiz ishlaganimiz uchun yuklab olmadik —
YOLO kitobida (o'quv rejadagi 11-bosqich) buni to'liq ko'rasiz.
| Holat | Yechim | Nomi |
|---|---|---|
| Ma'lumot 1000 dan kam | Tayyor modelni oling, faqat oxirgi qatlamni o'qitng | Feature extraction |
| Ma'lumot 1000-10000 | Tayyor model + oxirgi bloklarni ham o'qitish | Fine-tuning |
| Ma'lumot 100000+ | Noldan o'qitish mumkin | Training from scratch |
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Rasm = matritsa", "Bitta jumla": "8x8 piksel — oddiy sonlar jadvali"},
    {"Tushuncha": "Dense ning muammosi", "Bitta jumla": "Flatten fazoviy bog'liqlikni yo'qotadi"},
    {"Tushuncha": "Konvolyutsiya", "Bitta jumla": "Filtr rasm bo'ylab yuradi — 11-bobdagi skalyar ko'paytma"},
    {"Tushuncha": "Parametr ulashish", "Bitta jumla": "Bitta filtr butun rasm uchun — kam parametr"},
    {"Tushuncha": "Pooling", "Bitta jumla": "O'lchamni kamaytiradi, pozitsiyaga chidam beradi"},
    {"Tushuncha": "CNN ning afzalligi", "Bitta jumla": "Rasmda emas — TRANSLYATSIYA INVARIANTLIGIDA"},
    {"Tushuncha": "Markazlashgan rasm", "Bitta jumla": "Dense ham yetarli — o'lchab ko'rsatildi"},
    {"Tushuncha": "Augmentatsiya", "Bitta jumla": "Eng arzon kuchaytirish; faqat TRAIN ga"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Rasm = matritsa | 8x8 piksel — oddiy sonlar jadvali |
| Dense ning muammosi | Flatten fazoviy bog'liqlikni yo'qotadi |
| Konvolyutsiya | Filtr rasm bo'ylab yuradi — 11-bobdagi skalyar ko'paytma |
| Parametr ulashish | Bitta filtr butun rasm uchun — kam parametr |
| Pooling | O'lchamni kamaytiradi, pozitsiyaga chidam beradi |
| CNN ning afzalligi | Rasmda emas — TRANSLYATSIYA INVARIANTLIGIDA |
| Markazlashgan rasm | Dense ham yetarli — o'lchab ko'rsatildi |
| Augmentatsiya | Eng arzon kuchaytirish; faqat TRAIN ga |
Keyingi bobda rasmdan ketma-ketlikka o'tamiz: matn, vaqt qatorlari, audio.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.