Attention va Transformer
Sahna: 34-bob bizni muammo bilan qoldirdi
O'tgan bobda o'lchadik: T=60 uzunlikdagi ketma-ketlikda birinchi qadamga yetib boradigan gradient oxirgi qadamdagidan milliardlarcha marta kichik. Shuning uchun RNN ham, LSTM ham "birinchi element muhim" degan xulosaga ishonchli yetib bormadi.
Muammoning ildizi — yo'l uzunligi. RNN da 1-qadamdan 60-qadamga borish uchun 59 ta ko'paytirish kerak. Har ko'paytirish signalni kichraytiradi.
Yechim g'oyasi juda oddiy: yurmaslik. Har qadamga to'g'ridan-to'g'ri qarash.
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "-1"
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
from torch.utils.data import TensorDataset, DataLoader

torch.set_num_threads(4)

diagramma(
    {
        "1-qadam": (0.2, 0.2, 1.3, 0.7, "manba"),
        "...": (1.9, 0.2, 1.3, 0.7, "manba"),
        "60-qadam": (3.6, 0.2, 1.3, 0.7, "manba"),
        "RNN: 59 ta qadam\\nbosib o'tiladi": (0.2, 1.5, 4.7, 0.8, "xizmat"),
        "Attention: har qadamga\\nTO'G'RIDAN-TO'G'RI yo'l": (0.2, 2.7, 4.7, 0.8, "qayta"),
    },
    [("1-qadam", "RNN: 59 ta qadam\\nbosib o'tiladi"),
     ("60-qadam", "RNN: 59 ta qadam\\nbosib o'tiladi"),
     ("RNN: 59 ta qadam\\nbosib o'tiladi", "Attention: har qadamga\\nTO'G'RIDAN-TO'G'RI yo'l")],
    nom="yol_uzunligi.png",
    izoh="RNN da ma'lumot zanjir bo'ylab yuradi va yo'lda kuchsizlanadi. "
         "Attention da har pozitsiya orasidagi masofa — bitta qadam.",
)
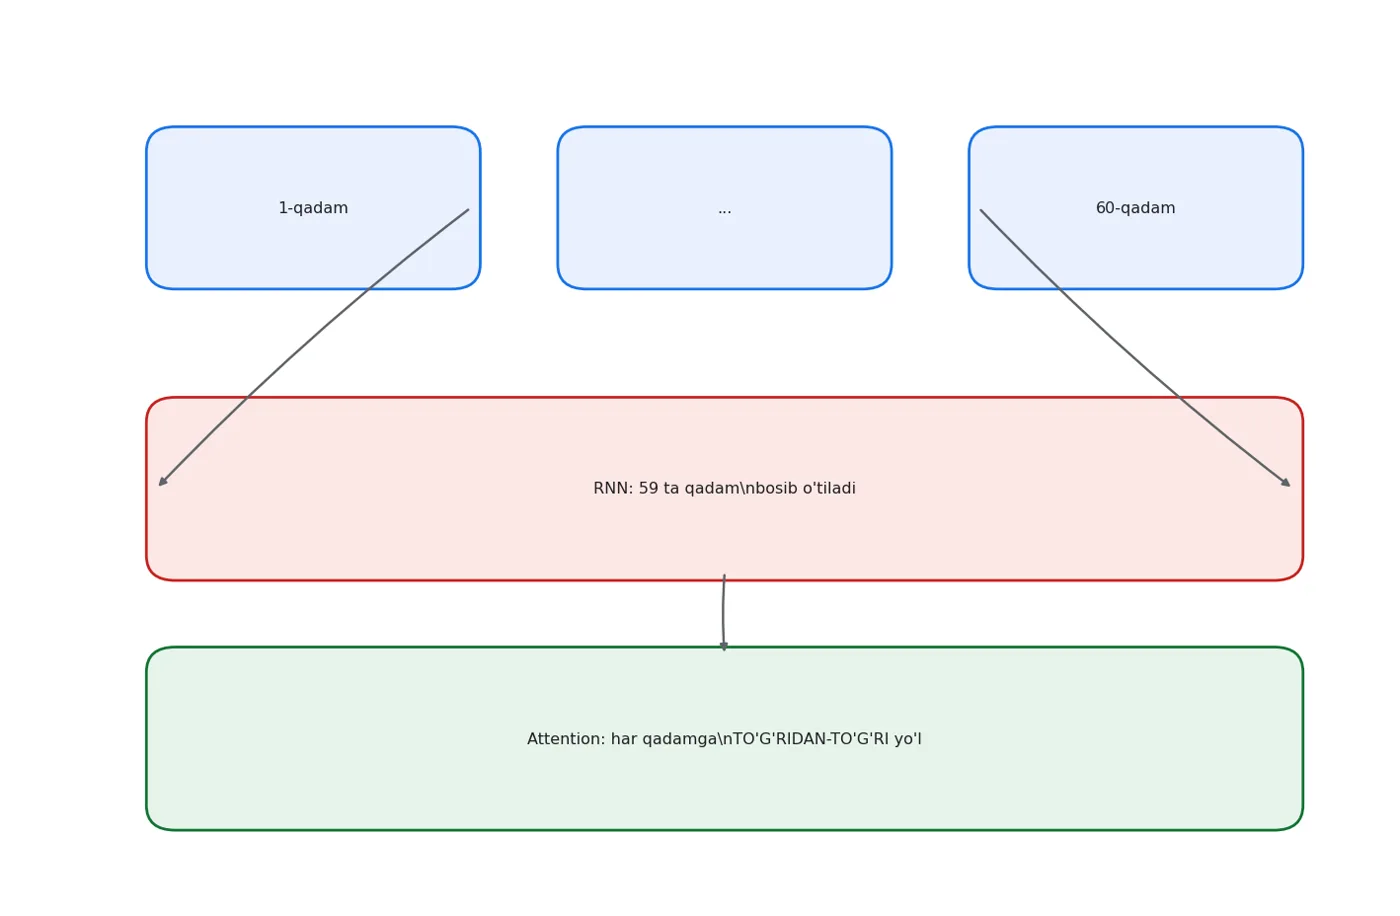
RNN da ma'lumot zanjir bo'ylab yuradi va yo'lda kuchsizlanadi. Attention da har pozitsiya orasidagi masofa — bitta qadam.
Attention qo'lda: uchta matritsa
Attention ning butun mohiyati bitta formulada. Va u formuladagi hamma amal 11-bobda ko'rilgan.
Har pozitsiya uchta vektor yasaydi:
- Q (query, so'rov) — "men nimani qidiryapman?"
- K (key, kalit) — "menda nima bor?"
- V (value, qiymat) — "olsangiz, mana shuni olasiz"
torch.manual_seed(0)
T_kichik, d = 4, 8
h = torch.randn(1, T_kichik, d)

Wq, Wk, Wv = (nn.Linear(d, d, bias=False) for _ in range(3))
Q, K, V = Wq(h), Wk(h), Wv(h)
print(f"Kirish h: {tuple(h.shape)}   -> {T_kichik} pozitsiya, har biri {d} o'lchamli vektor")
print(f"Q, K, V : {tuple(Q.shape)}")
print()

ball = Q @ K.transpose(1, 2)
print("1-qadam: har Q ni har K bilan skalyar ko'paytirish (o'xshashlik balli)")
print(f"  ball shakli: {tuple(ball.shape)}  -> har pozitsiya har pozitsiyaga ball qo'yadi")
print(np.round(ball[0].detach().numpy(), 2))
print()

ball_normal = ball / d ** 0.5
print(f"2-qadam: sqrt(d) ga bo'lish (d={d}, sqrt={d**0.5:.3f})")
print("  Nega: d katta bo'lsa ballar ham katta bo'ladi, softmax esa 0 va 1 ga yopishib qoladi.")
print()

ogirlik = torch.softmax(ball_normal, dim=-1)
print("3-qadam: softmax — ballarni og'irlikka aylantirish")
print(np.round(ogirlik[0].detach().numpy(), 3))
print(f"  har qator yig'indisi: {ogirlik[0].sum(dim=-1).detach().numpy().round(4)}")
print()

chiqish = ogirlik @ V
print(f"4-qadam: og'irliklar bilan V ning o'rtachasi -> {tuple(chiqish.shape)}")
print()
print("Hammasi bitta qatorda:")
print("  softmax(Q @ K.T / sqrt(d)) @ V")
Kirish h: (1, 4, 8)   -> 4 pozitsiya, har biri 8 o'lchamli vektor
Q, K, V : (1, 4, 8)

1-qadam: har Q ni har K bilan skalyar ko'paytirish (o'xshashlik balli)
  ball shakli: (1, 4, 4)  -> har pozitsiya har pozitsiyaga ball qo'yadi
[[ 0.47 -0.97 -0.27 -1.25]
 [-0.46 -0.39 -0.89 -0.09]
 [-0.63 -0.73 -0.3  -0.52]
 [-0.41 -0.08 -0.66 -0.24]]

2-qadam: sqrt(d) ga bo'lish (d=8, sqrt=2.828)
  Nega: d katta bo'lsa ballar ham katta bo'ladi, softmax esa 0 va 1 ga yopishib qoladi.

3-qadam: softmax — ballarni og'irlikka aylantirish
[[0.343 0.207 0.264 0.187]
 [0.249 0.255 0.213 0.283]
 [0.242 0.234 0.272 0.252]
 [0.244 0.274 0.223 0.259]]
  har qator yig'indisi: [1. 1. 1. 1.]

4-qadam: og'irliklar bilan V ning o'rtachasi -> (1, 4, 8)

Hammasi bitta qatorda:
  softmax(Q @ K.T / sqrt(d)) @ V
Attention — bu o'rganiladigan o'rtachalash
Agar formulani bir jumlada aytish kerak bo'lsa: attention — og'irliklari ma'lumotga qarab hisoblangan o'rtacha.
Oddiy o'rtachada hamma element teng og'irlik oladi. Attention da og'irliklar softmax(QK/sqrt(d)) dan keladi, ya'ni modelning o'zi har safar hal qiladi: "bu holatda qaysi pozitsiyaga qarashim kerak?"
Shuning uchun u "e'tibor" deb ataladi.
Gradient oqimini o'lchaymiz
34-bobda RNN va LSTM uchun gradient o'lchagandik. Endi attention ni shu o'lchovga qo'yamiz.
def vazifa(n, T, seed=0):
    """Faqat BIRINCHI element javobni belgilaydi. Qolgani shovqin."""
    rr = np.random.default_rng(seed)
    Xs = rr.normal(0, 1, (n, T, 1)).astype(np.float32)
    return torch.tensor(Xs), torch.tensor((Xs[:, 0, 0] > 0).astype(np.int64))

class Ketma(nn.Module):
    def __init__(self, turi, h=32):
        super().__init__()
        self.rnn = nn.RNN(1, h, batch_first=True) if turi == "rnn" else nn.LSTM(1, h, batch_first=True)
        self.fc = nn.Linear(h, 2)
    def forward(self, x):
        o, _ = self.rnn(x)
        return self.fc(o[:, -1])

class Attention(nn.Module):
    def __init__(self, T, d=32, pozitsiya=True):
        super().__init__()
        self.inp = nn.Linear(1, d)
        self.poz = nn.Parameter(torch.randn(1, T, d) * 0.02) if pozitsiya else None
        self.q, self.k, self.v = (nn.Linear(d, d) for _ in range(3))
        self.fc = nn.Linear(d, 2)
        self.ogirlik = None
    def forward(self, x):
        hh = self.inp(x)
        if self.poz is not None:
            hh = hh + self.poz
        Qx, Kx, Vx = self.q(hh), self.k(hh), self.v(hh)
        w = torch.softmax(Qx @ Kx.transpose(1, 2) / Kx.shape[-1] ** 0.5, dim=-1)
        self.ogirlik = w.detach()
        return self.fc((w @ Vx).mean(1))

T = 60
print(f"Kirishning birinchi va oxirgi qadamiga yetib boradigan gradient (T={T}):")
print()
grad_jadval = []
for nom, yasa in [("RNN", lambda: Ketma("rnn")), ("LSTM", lambda: Ketma("lstm")),
                  ("attention", lambda: Attention(T))]:
    torch.manual_seed(0)
    Xg, yg = vazifa(256, T, 1)
    Xg.requires_grad_(True)
    m = yasa()
    nn.CrossEntropyLoss()(m(Xg), yg).backward()
    g = Xg.grad.abs().mean(dim=(0, 2))
    grad_jadval.append({"model": nom, "qadam 0": f"{g[0]:.3e}", "qadam 59": f"{g[59]:.3e}",
                        "qadam59 / qadam0": f"{g[59] / g[0]:.2e}"})
show(pd.DataFrame(grad_jadval))
Kirishning birinchi va oxirgi qadamiga yetib boradigan gradient (T=60):
| model | qadam 0 | qadam 59 | qadam59 / qadam0 |
|---|---|---|---|
| RNN | 2.427e-17 | 1.129e-05 | 4.65e+11 |
| LSTM | 2.503e-17 | 2.982e-05 | 1.19e+12 |
| attention | 6.268e-06 | 6.604e-06 | 1.05e+00 |
Nisbat ustuniga qarang. RNN va LSTM da u milliardlardan oshadi — ya'ni birinchi qadam deyarli signal olmaydi. Attention da nisbat birga yaqin: gradient hamma pozitsiyaga teng yetib boradi.
Sababi tuzilishda: attention da 1-qadam bilan 60-qadam orasida bitta matritsa ko'paytmasi bor, 59 ta emas.
Sinov: xuddi shu xotira vazifasi
34-bobdagi vazifani takrorlaymiz, lekin raqiblar qatoriga attention ni qo'shamiz. Shart bir xil: 3 seed, bir xil o'qitish budjeti.
def oqit(yasa, T_, seed, epoxalar=60, n=2000, lr=0.005):
    torch.manual_seed(seed)
    Xtr, ytr = vazifa(n, T_, 1)
    Xte, yte = vazifa(600, T_, 2)
    m = yasa()
    opt = torch.optim.Adam(m.parameters(), lr=lr)
    krit = nn.CrossEntropyLoss()
    dl = DataLoader(TensorDataset(Xtr, ytr), batch_size=64, shuffle=True,
                    generator=torch.Generator().manual_seed(seed))
    for _ in range(epoxalar):
        m.train()
        for xb, yb in dl:
            opt.zero_grad(); krit(m(xb), yb).backward(); opt.step()
    m.eval()
    with torch.no_grad():
        return float((m(Xte).argmax(1) == yte).float().mean()), m

print("Tasodifiy javob = 0.50. Har model 3 seed bilan.")
sinov = []
for nom, yasa in [
    ("RNN", lambda: Ketma("rnn")),
    ("LSTM", lambda: Ketma("lstm")),
    ("attention (+ pozitsiya)", lambda: Attention(T)),
    ("attention (pozitsiyaSIZ)", lambda: Attention(T, pozitsiya=False)),
]:
    aniq = [oqit(yasa, T, s)[0] for s in (0, 1, 2)]
    sinov.append({"model": nom, "seedlar": str([round(a, 3) for a in aniq]),
                  "o'rtacha": round(float(np.mean(aniq)), 4),
                  "eng yomon": round(min(aniq), 4),
                  "parametrlar": sum(p.numel() for p in yasa().parameters())})
show(pd.DataFrame(sinov))
Tasodifiy javob = 0.50. Har model 3 seed bilan.
| model | seedlar | o'rtacha | eng yomon | parametrlar |
|---|---|---|---|---|
| RNN | [0.847, 0.98, 0.98] | 0.936 | 0.847 | 1 186 |
| LSTM | [0.542, 0.97, 0.517] | 0.676 | 0.517 | 4 546 |
| attention (+ pozitsiya) | [0.998, 0.995, 0.998] | 0.997 | 0.995 | 5 218 |
| attention (pozitsiyaSIZ) | [0.543, 0.56, 0.562] | 0.555 | 0.543 | 3 298 |
Natija aniq: attention vazifani hamma seedda yechadi. LSTM esa 34-bobda ko'rganimizdek beqaror qoldi.
Lekin jadvalning oxirgi qatoriga qarang — u eng muhim.
Pozitsiya kodlash: attention tartibni BILMAYDI
attention (pozitsiyaSIZ) natijasi tasodifiy javob darajasida. Bu tasodif emas.
torch.manual_seed(0)
m_poz = Attention(T, pozitsiya=False)
Xs, _ = vazifa(8, T, 5)
with torch.no_grad():
    asl = m_poz(Xs)
    aralash = m_poz(Xs[:, torch.randperm(T)])     # pozitsiyalarni ARALASHTIRAMIZ

print("Pozitsiya kodlashsiz attention — kirishni aralashtirib ko'ramiz:")
print(f"  asl chiqish[0]     : {asl[0].numpy().round(5)}")
print(f"  aralash chiqish[0] : {aralash[0].numpy().round(5)}")
print(f"  maksimal farq      : {float((asl - aralash).abs().max()):.2e}")
print()
print("Chiqish o'zgarmadi. Demak model uchun ketma-ketlik — TARTIBSIZ TO'PLAM.")
print("U 'birinchi element' degan tushunchaga ega emas, shuning uchun vazifani yecha olmaydi.")
Pozitsiya kodlashsiz attention — kirishni aralashtirib ko'ramiz:
  asl chiqish[0]     : [-0.18954  0.12116]
  aralash chiqish[0] : [-0.18954  0.12116]
  maksimal farq      : 2.98e-08

Chiqish o'zgarmadi. Demak model uchun ketma-ketlik — TARTIBSIZ TO'PLAM.
U 'birinchi element' degan tushunchaga ega emas, shuning uchun vazifani yecha olmaydi.
Attention o'zi tartibni ko'rmaydi — pozitsiya qo'shilishi kerak
softmax(QK/sqrt(d)) @ V formulasiga qarang: unda pozitsiya indeksi hech qayerda qatnashmaydi. Kirishlarni aralashtirsangiz, chiqish ham shunchaki aralashadi — lekin mazmuni o'zgarmaydi.
Yuqoridagi o'lchov shuni isbotladi: aralashtirilgan kirishda chiqish aynan bir xil qoldi.
Shuning uchun har transformer da pozitsiya haqida ma'lumot qo'lda qo'shiladi:
- o'rganiladigan pozitsiya vektori (biz shuni ishlatdik:
nn.Parameter) - sinus/kosinus kodlash (asl "Attention Is All You Need" maqolasida)
- RoPE (hozirgi LLM larda keng tarqalgan)
Buni unutish — transformer ni noldan yozishda eng ko'p uchraydigan xato. Model o'qiydi, loss tushadi, lekin tartibga bog'liq hamma narsa buziladi.
Model nimaga qaraganini KO'RSATISH
Attention ning amaliy ustunligi yana bittasi: og'irliklarni ochib ko'rish mumkin. 25-bobda SHAP bilan modelni tushuntirganmiz — bu yerda tushuntirish modelning ichida tayyor turadi.
aniqlik, model = oqit(lambda: Attention(T), T, 0)
Xv, _ = vazifa(200, T, 2)
with torch.no_grad():
    model(Xv)
w = model.ogirlik.mean(dim=(0, 1)).numpy()

print(f"O'qitilgan attention modelining aniqligi: {aniqlik:.4f}")
print()
print(f"Qadam 0 ga berilgan o'rtacha e'tibor : {w[0]:.4f}")
print(f"Qolgan 59 qadamning o'rtachasi      : {w[1:].mean():.6f}")
print(f"Eng ko'p e'tibor olgan qadam        : {int(w.argmax())}")
print()
print("Model o'zi topdi: javob BIRINCHI qadamda. Biz bunga hech qanday ko'rsatma bermadik.")
O'qitilgan attention modelining aniqligi: 0.9983

Qadam 0 ga berilgan o'rtacha e'tibor : 0.9975
Qolgan 59 qadamning o'rtachasi      : 0.000042
Eng ko'p e'tibor olgan qadam        : 0

Model o'zi topdi: javob BIRINCHI qadamda. Biz bunga hech qanday ko'rsatma bermadik.
rasm, (b1, b2) = plt.subplots(1, 2, figsize=(14, 4.2),
                              gridspec_kw={"width_ratios": [1.15, 1]})
b1.bar(np.arange(T), w, color="#1a73e8")
b1.set_title("Har qadamga berilgan o'rtacha e'tibor")
b1.set_xlabel("ketma-ketlik qadami"); b1.set_ylabel("og'irlik")
tasvir = b2.imshow(model.ogirlik[0].numpy(), cmap="viridis", aspect="auto")
b2.set_title("Attention matritsasi (bitta namuna)")
b2.set_xlabel("qaralayotgan qadam"); b2.set_ylabel("so'rov qadami")
plt.colorbar(tasvir, ax=b2, fraction=0.046)
plt.tight_layout()
fig("attention_ogirligi.png",
    caption="Chapda: butun e'tibor 0-qadamga to'plangan. O'ngda: attention matritsasining "
            "chap ustuni yorqin — har pozitsiya 0-qadamga qaraydi.")
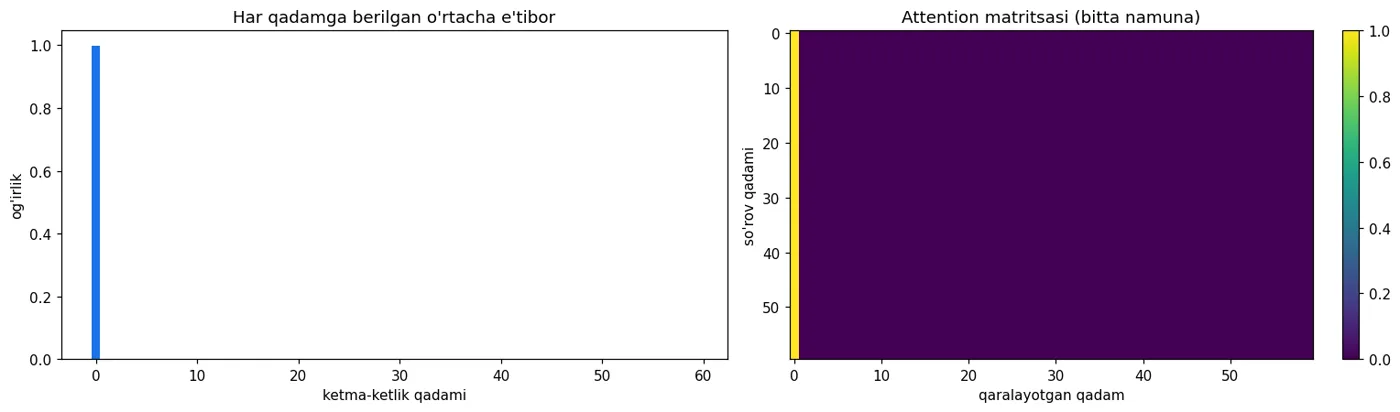
Chapda: butun e'tibor 0-qadamga to'plangan. O'ngda: attention matritsasining chap ustuni yorqin — har pozitsiya 0-qadamga qaraydi.
Narxi: O(T kvadrat)
Attention bepul emas. U har pozitsiyani har pozitsiya bilan taqqoslaydi, ya'ni T x T matritsa yasaydi. Buni o'lchaymiz.
print(f"{'T':>6} {'RNN vaqti (ms)':>16} {'attention (ms)':>16} {'attn matritsa hajmi':>22}")
print("-" * 64)
for Tx in [30, 60, 120, 240]:
    Xb, _ = vazifa(64, Tx, 3)
    r_m, a_m = Ketma("rnn"), Attention(Tx)
    with torch.no_grad():
        r_m(Xb); a_m(Xb)                                   # isitish
        t0 = time.perf_counter(); [r_m(Xb) for _ in range(10)]
        t_rnn = (time.perf_counter() - t0) * 100
        t0 = time.perf_counter(); [a_m(Xb) for _ in range(10)]
        t_attn = (time.perf_counter() - t0) * 100
    print(f"{Tx:>6} {t_rnn:>16.2f} {t_attn:>16.2f} {f'{Tx}x{Tx} = {Tx*Tx}':>22}")
print()
print("Matritsa hajmi ustuni: T ikki barobar oshsa, u ANIQ to'rt barobar o'sadi.")
print("Vaqt ustuni esa boshqa narsani aytadi — pastdagi izohni o'qing.")
     T   RNN vaqti (ms)   attention (ms)    attn matritsa hajmi
----------------------------------------------------------------
    30             0.29             0.17            30x30 = 900
    60             0.57             0.27           60x60 = 3600
   120             1.04             0.68        120x120 = 14400
   240             2.02             3.56        240x240 = 57600

Matritsa hajmi ustuni: T ikki barobar oshsa, u ANIQ to'rt barobar o'sadi.
Vaqt ustuni esa boshqa narsani aytadi — pastdagi izohni o'qing.
O'lchov mening taxminimni yarim rad etdi
Men bu jadvalni "attention qimmat" degan xulosa uchun qo'ygandim. Natija boshqa chiqdi: kichik T da attention RNN dan tezroq ishlaydi.
Sababi — parallellik. RNN T qadamni ketma-ket bosib o'tishi kerak, 240 qadam uchun 240 ta navbatdagi amal. Attention esa hammasini bitta katta matritsa ko'paytmasida bajaradi, va matritsa ko'paytmasi juda yaxshi optimizatsiya qilingan.
Kvadratik o'sish esa faqat T katta bo'lganda ustun chiqadi. Jadvalda kesishish nuqtasi 120 va 240 orasida ko'rinadi.
Shuning uchun to'g'ri xulosa ikki qismli:
- Tezlikda attention g'alaba qozonadi — shuning uchun transformerlar RNN ni almashtirdi. Ularni GPU da parallel o'qitish mumkin, RNN ni esa yo'q.
- Xotirada va uzun kontekstda kvadratik o'sish haqiqiy to'siq: T x T matritsani saqlash kerak. 100 000 tokenli kontekst uchun bu 10 milliard element.
Shu ikkinchi sabab tufayli FlashAttention, sliding window attention va MQA kabi usullar paydo bo'ldi — ular aynan xotira muammosini yechadi, tezlikni emas.
Umumiy saboq: "qimmat" degan so'z o'lchovsiz ma'noga ega emas. Nimaga qimmat — vaqtga, xotiraga, yoki parametrga?
Transformer bloki
Attention — bitta g'isht. Transformer bloki uning atrofiga to'rt narsa qo'shadi.
show(pd.DataFrame([
    {"Qism": "1. Multi-head attention",
     "Vazifasi": "Bir nechta attention parallel — har biri boshqa munosabatga qaraydi"},
    {"Qism": "2. Residual ulanish (x + attn(x))",
     "Vazifasi": "Gradientga to'g'ri yo'l beradi — chuqur tarmoq uchun shart"},
    {"Qism": "3. LayerNorm",
     "Vazifasi": "Har qatlam chiqishini barqarorlashtiradi"},
    {"Qism": "4. Feed-forward (2 qatlamli MLP)",
     "Vazifasi": "Attention yig'gan ma'lumotni qayta ishlaydi"},
]))
print()
print("Shu blok N marta taxlanadi. GPT, BERT, Llama — hammasi shu naqshning variantlari.")
print("Farqlar: blok soni, o'lcham, pozitsiya kodlash turi va attention maskasi.")
Shu blok N marta taxlanadi. GPT, BERT, Llama — hammasi shu naqshning variantlari.
Farqlar: blok soni, o'lcham, pozitsiya kodlash turi va attention maskasi.
| Qism | Vazifasi |
|---|---|
| 1. Multi-head attention | Bir nechta attention parallel — har biri boshqa munosabatga qaraydi |
| 2. Residual ulanish (x + attn(x)) | Gradientga to'g'ri yo'l beradi — chuqur tarmoq uchun shart |
| 3. LayerNorm | Har qatlam chiqishini barqarorlashtiradi |
| 4. Feed-forward (2 qatlamli MLP) | Attention yig'gan ma'lumotni qayta ishlaydi |
class TransformerBlok(nn.Module):
    """Minimal, lekin to'liq: attention + residual + norm + feed-forward."""
    def __init__(self, d=32, boshlar=4):
        super().__init__()
        self.attn = nn.MultiheadAttention(d, boshlar, batch_first=True)
        self.norm1, self.norm2 = nn.LayerNorm(d), nn.LayerNorm(d)
        self.ff = nn.Sequential(nn.Linear(d, 4 * d), nn.GELU(), nn.Linear(4 * d, d))
    def forward(self, x):
        a, _ = self.attn(x, x, x)
        x = self.norm1(x + a)                 # residual + norm
        return self.norm2(x + self.ff(x))     # residual + norm

blok = TransformerBlok()
namuna = torch.randn(2, 10, 32)
print(f"Kirish : {tuple(namuna.shape)}")
print(f"Chiqish: {tuple(blok(namuna).shape)}   (shakl saqlanadi — shuning uchun taxlash mumkin)")
print(f"Parametrlar: {sum(p.numel() for p in blok.parameters())}")
print()
print("nn.MultiheadAttention — biz qo'lda yozgan formulaning tayyor, tezroq versiyasi.")
Kirish : (2, 10, 32)
Chiqish: (2, 10, 32)   (shakl saqlanadi — shuning uchun taxlash mumkin)
Parametrlar: 12704

nn.MultiheadAttention — biz qo'lda yozgan formulaning tayyor, tezroq versiyasi.
Bu bilan nima qilish mumkin
show(pd.DataFrame([
    {"Vazifa": "Matn klassifikatsiya", "Yondashuv": "Tayyor model + oxirgi qatlam (fine-tuning)"},
    {"Vazifa": "Savol-javob o'z hujjatlaringiz ustida", "Yondashuv": "RAG — qidirish + LLM"},
    {"Vazifa": "O'z uslubingizda matn", "Yondashuv": "LoRA fine-tuning"},
    {"Vazifa": "Rasmdan matn (OCR)", "Yondashuv": "Vision transformer + dekoder"},
    {"Vazifa": "Vaqt qatori", "Yondashuv": "Avval 34-bob: differensiyalash va klassik usullar"},
]))
print()
print("Muhim: bu vazifalarning hech birida transformer ni NOLDAN o'qitmaysiz.")
print("Tayyor model olinadi va moslashtiriladi. Buning yo'li — 38-bobda (LoRA, QLoRA).")
Muhim: bu vazifalarning hech birida transformer ni NOLDAN o'qitmaysiz.
Tayyor model olinadi va moslashtiriladi. Buning yo'li — 38-bobda (LoRA, QLoRA).
| Vazifa | Yondashuv |
|---|---|
| Matn klassifikatsiya | Tayyor model + oxirgi qatlam (fine-tuning) |
| Savol-javob o'z hujjatlaringiz ustida | RAG — qidirish + LLM |
| O'z uslubingizda matn | LoRA fine-tuning |
| Rasmdan matn (OCR) | Vision transformer + dekoder |
| Vaqt qatori | Avval 34-bob: differensiyalash va klassik usullar |
Noldan o'qitish — sizning vazifangiz emas
Yuqoridagi o'lchovlarda attention modelimiz 60 uzunlikdagi sun'iy vazifani yechdi. Haqiqiy til modeli esa milliardlab token va minglab GPU-soat talab qiladi.
Amaliy ish: tayyor modelni moslashtirish. Shuning uchun bu kitobda keyingi qism (36-40) aynan shu zanjirni quradi: ma'lumot yig'ish, dataset qurish, fine-tuning, saqlash, xizmatga chiqarish.
Nazariyani bilish esa shuning uchun kerak: kontekst chegarasi nega bor, nega uzun prompt qimmat, nega pozitsiya muhim, nega model ba'zan boshdagi ko'rsatmani "unutadi". Bu savollarning javobi — shu bobdagi formulada.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Attention formulasi", "Bitta jumla": "softmax(Q @ K.T / sqrt(d)) @ V"},
    {"Tushuncha": "Q, K, V", "Bitta jumla": "So'rov, kalit, qiymat — uchtasi ham chiziqli proyeksiya"},
    {"Tushuncha": "Nega sqrt(d)", "Bitta jumla": "Softmax ni to'yinishdan saqlaydi"},
    {"Tushuncha": "Yo'l uzunligi", "Bitta jumla": "Har pozitsiya orasida bitta qadam — 59 emas"},
    {"Tushuncha": "Gradient oqimi", "Bitta jumla": "O'lchandi: nisbat birga yaqin, RNN da milliardlar"},
    {"Tushuncha": "Pozitsiya kodlash", "Bitta jumla": "O'lchandi: busiz model tartibni ko'rmaydi"},
    {"Tushuncha": "Tushuntirish", "Bitta jumla": "Og'irliklar modelning qarashini ko'rsatadi"},
    {"Tushuncha": "O(T kvadrat)", "Bitta jumla": "Matritsa 4 barobar o'sadi — to'siq XOTIRADA, tezlikda emas"},
    {"Tushuncha": "Parallellik", "Bitta jumla": "O'lchandi: kichik T da attention RNN dan tezroq"},
    {"Tushuncha": "Transformer bloki", "Bitta jumla": "Attention + residual + norm + feed-forward"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Attention formulasi | softmax(Q @ K.T / sqrt(d)) @ V |
| Q, K, V | So'rov, kalit, qiymat — uchtasi ham chiziqli proyeksiya |
| Nega sqrt(d) | Softmax ni to'yinishdan saqlaydi |
| Yo'l uzunligi | Har pozitsiya orasida bitta qadam — 59 emas |
| Gradient oqimi | O'lchandi: nisbat birga yaqin, RNN da milliardlar |
| Pozitsiya kodlash | O'lchandi: busiz model tartibni ko'rmaydi |
| Tushuntirish | Og'irliklar modelning qarashini ko'rsatadi |
| O(T kvadrat) | Matritsa 4 barobar o'sadi — to'siq XOTIRADA, tezlikda emas |
| Parallellik | O'lchandi: kichik T da attention RNN dan tezroq |
| Transformer bloki | Attention + residual + norm + feed-forward |
Shu bilan 7-qism tugadi. Keyingi qism — kitobning eng amaliy zanjiri: o'z ma'lumotingizni yig'ishdan boshlab, modelni ishlaydigan xizmatga chiqarishgacha.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.