Backpropagation va optimizerlar
Sahna: 29-bobdagi "orqaga" qismi
29-bobda tarmoqni o'qitdik. Kodda shunday qator bor edi:
dz1 = da1 * (z1 > 0)        # ReLU hosilasi
dW1 = X.T @ dz1
Bu — backpropagation. Va u sehr emas: bu o'rta maktabdagi zanjir qoidasi.
Bu bob shuni ochadi va keyin o'qitishni tezlashtiradigan usullarni ko'radi.
Zanjir qoidasi: bitta misol
Maktabda shunday o'rgatilgan: agar
Neyron tarmoq — bu funksiyalarning uzun zanjiri. Shuning uchun gradient ham ko'paytmalar zanjiri bo'ladi.
import numpy as np
import pandas as pd

# eng oddiy zanjir: x -> z1 = w1*x -> a1 = z1^2 -> z2 = w2*a1 -> L = (z2 - y)^2
x, y_haq, w1, w2 = 2.0, 10.0, 3.0, 0.5

# OLDINGA
z1 = w1 * x
a1 = z1 ** 2
z2 = w2 * a1
L = (z2 - y_haq) ** 2
print(f"OLDINGA: x={x} -> z1={z1} -> a1={a1} -> z2={z2} -> L={L}")
print()

# ORQAGA — zanjir qoidasi bo'yicha
dL_dz2 = 2 * (z2 - y_haq)
dz2_dw2 = a1
dz2_da1 = w2
da1_dz1 = 2 * z1
dz1_dw1 = x

dL_dw2 = dL_dz2 * dz2_dw2
dL_dw1 = dL_dz2 * dz2_da1 * da1_dz1 * dz1_dw1

print("ORQAGA (zanjir qoidasi):")
print(f"  dL/dz2 = 2*(z2-y)        = {dL_dz2}")
print(f"  dL/dw2 = dL/dz2 * a1     = {dL_dw2}")
print(f"  dL/dw1 = dL/dz2 * w2 * 2*z1 * x = {dL_dw1}")
OLDINGA: x=2.0 -> z1=6.0 -> a1=36.0 -> z2=18.0 -> L=64.0

ORQAGA (zanjir qoidasi):
  dL/dz2 = 2*(z2-y)        = 16.0
  dL/dw2 = dL/dz2 * a1     = 576.0
  dL/dw1 = dL/dz2 * w2 * 2*z1 * x = 192.0
Tekshirish: gradientni raqamli usulda ham hisoblash mumkin — bu backpropagation ni tekshirishning klassik usuli.
def yoqotish(w1_, w2_):
    return (w2_ * (w1_ * x) ** 2 - y_haq) ** 2

h = 1e-6
raqamli_w1 = (yoqotish(w1 + h, w2) - yoqotish(w1 - h, w2)) / (2 * h)
raqamli_w2 = (yoqotish(w1, w2 + h) - yoqotish(w1, w2 - h)) / (2 * h)

print(f"{'parametr':>10} {'analitik':>14} {'raqamli':>14} {'farq':>12}")
print("-" * 54)
print(f"{'w1':>10} {dL_dw1:>14.6f} {raqamli_w1:>14.6f} {abs(dL_dw1-raqamli_w1):>12.2e}")
print(f"{'w2':>10} {dL_dw2:>14.6f} {raqamli_w2:>14.6f} {abs(dL_dw2-raqamli_w2):>12.2e}")
  parametr       analitik        raqamli         farq
------------------------------------------------------
        w1     192.000000     192.000000     2.68e-08
        w2     576.000000     576.000000     4.75e-09
Gradient tekshirish — o'z kodingizni sinash usuli
Agar siz backpropagation ni qo'lda yozsangiz, uni shu usulda tekshiring: analitik gradient raqamli gradientga mos kelishi kerak.
Farq 1e-6 dan katta bo'lsa — kodingizda xato bor.
Bu usul torch va tensorflow paydo bo'lishidan oldin majburiy edi. Hozir avtomatik differensiallash bor (32-bob), lekin tekshirish ko'nikmasi foydali.
Gradient yo'qolishi: sigmoid ning jazosi
29-bobda aytganmiz: sigmoid ning hosilasi yassi joyda nolga yaqin. Chuqur tarmoqda bu ko'payadi.
def sigmoid(z):
    return 1 / (1 + np.exp(-np.clip(z, -500, 500)))

print("Zanjir qoidasida hosilalar KO'PAYTIRILADI.")
print("Sigmoid hosilasining maksimumi 0.25 (z=0 da):")
print()
print(f"{'qatlamlar':>10} {'sigmoid (0.25^n)':>20} {'ReLU (1^n)':>14}")
print("-" * 48)
for n in [1, 3, 5, 10, 20]:
    print(f"{n:>10} {0.25**n:>20.2e} {1.0**n:>14.1f}")
Zanjir qoidasida hosilalar KO'PAYTIRILADI.
Sigmoid hosilasining maksimumi 0.25 (z=0 da):

 qatlamlar     sigmoid (0.25^n)     ReLU (1^n)
------------------------------------------------
         1             2.50e-01            1.0
         3             1.56e-02            1.0
         5             9.77e-04            1.0
        10             9.54e-07            1.0
        20             9.09e-13            1.0
20 qatlamli sigmoid tarmog'ida gradient 9e-13 ga tushadi — ya'ni birinchi qatlam umuman o'rganmaydi.
ReLU da esa hosila musbat tomonda aynan 1, shuning uchun gradient zaiflamaydi. Mana nega ReLU inqilob qildi.
import matplotlib.pyplot as plt

# amalda o'lchaymiz: chuqur tarmoqda gradient kattaligi
def gradient_olchash(n_qatlam, activation="sigmoid", seed=42):
    r = np.random.default_rng(seed)
    X = r.normal(size=(200, 20))
    W = [r.normal(0, 1 / np.sqrt(20), (20, 20)) for _ in range(n_qatlam)]
    a = X
    oraliq = [a]
    for Wi in W:
        z = a @ Wi
        a = sigmoid(z) if activation == "sigmoid" else np.maximum(0, z)
        oraliq.append(a)
    # orqaga: oxirgi qatlamdan boshlab gradient kattaligini kuzatamiz
    g = np.ones_like(a)
    kattaliklar = []
    for i in range(n_qatlam - 1, -1, -1):
        if activation == "sigmoid":
            g = g * oraliq[i + 1] * (1 - oraliq[i + 1])
        else:
            g = g * (oraliq[i + 1] > 0)
        g = g @ W[i].T
        kattaliklar.append(float(np.abs(g).mean()))
    return kattaliklar[::-1]

sig_g = gradient_olchash(12, "sigmoid")
relu_g = gradient_olchash(12, "relu")

rasm, ax = plt.subplots(figsize=(9.5, 4.6))
ax.semilogy(range(1, 13), sig_g, "o-", lw=2, label="sigmoid", color="#c5221f")
ax.semilogy(range(1, 13), relu_g, "o-", lw=2, label="ReLU", color="#137333")
ax.set_xlabel("Qatlam (1 = kirishga eng yaqin)")
ax.set_ylabel("Gradient o'rtacha kattaligi (log shkala)")
ax.set_title("Gradient yo'qolishi — 12 qatlamli tarmoqda", fontweight="bold")
ax.legend(); ax.grid(alpha=.3, which="both")
fig("gradient_yoqolishi.png", caption="Sigmoid bilan gradient birinchi qatlamlarga yetib bormaydi. ReLU bilan u saqlanadi.")

print(f"{'qatlam':>8} {'sigmoid gradient':>20} {'ReLU gradient':>16}")
print("-" * 48)
for i in [0, 3, 7, 11]:
    print(f"{i+1:>8} {sig_g[i]:>20.3e} {relu_g[i]:>16.3e}")
print()
print(f"1-qatlamda nisbat: ReLU / sigmoid = {relu_g[0]/sig_g[0]:.0f} barobar")
  qatlam     sigmoid gradient    ReLU gradient
------------------------------------------------
       1            2.317e-08        1.691e-02
       4            2.793e-06        4.642e-02
       8            8.294e-04        2.057e-01
      12            2.429e-01        8.786e-01

1-qatlamda nisbat: ReLU / sigmoid = 729616 barobar
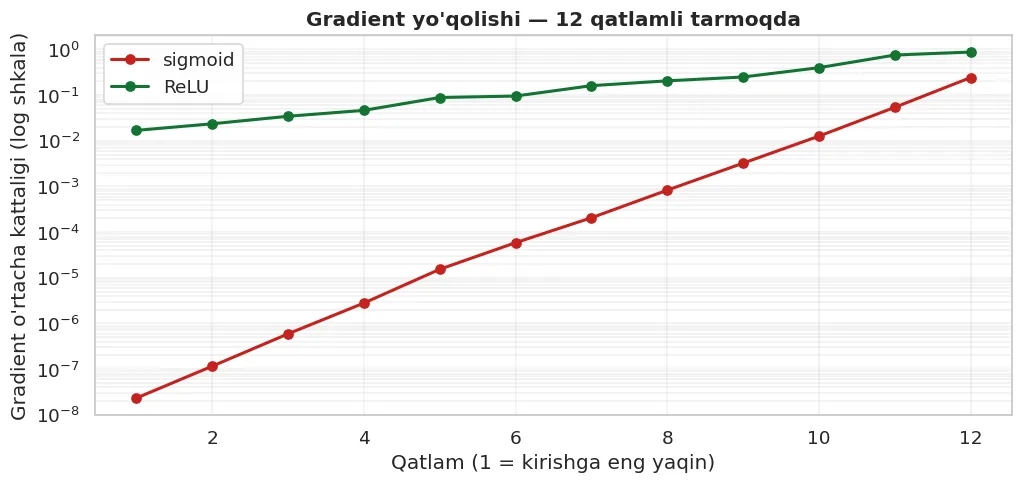
Sigmoid bilan gradient birinchi qatlamlarga yetib bormaydi. ReLU bilan u saqlanadi.
Vaznlarni boshlash (weight initialization)
Vaznlarni noldan boshlash mumkinmi? Yo'q — va sababi oddiy.
print("Hamma vazn NOL bo'lsa:")
W_nol = np.zeros((4, 3))
X_t = np.random.default_rng(0).normal(size=(5, 4))
print(f"  chiqish: {np.unique(np.round(X_t @ W_nol, 6))}  -> hamma neyron BIR XIL")
print("  Hamma neyron bir xil gradient oladi va bir xil o'zgaradi.")
print("  Natijada 100 neyronli qatlam 1 neyronga teng bo'ladi — SIMMETRIYA buzilmaydi.")
print()
print("Juda KATTA vazn bo'lsa:")
r = np.random.default_rng(42)
for std in [0.01, 1.0, 10.0]:
    a = r.normal(size=(500, 50))
    for _ in range(5):
        a = np.tanh(a @ r.normal(0, std, (50, 50)))
    print(f"  std={std:<6} 5 qatlamdan keyin chiqish |o'rtacha| = {np.abs(a).mean():.6f}")
Hamma vazn NOL bo'lsa:
  chiqish: [0.]  -> hamma neyron BIR XIL
  Hamma neyron bir xil gradient oladi va bir xil o'zgaradi.
  Natijada 100 neyronli qatlam 1 neyronga teng bo'ladi — SIMMETRIYA buzilmaydi.

Juda KATTA vazn bo'lsa:
  std=0.01   5 qatlamdan keyin chiqish |o'rtacha| = 0.000001
  std=1.0    5 qatlamdan keyin chiqish |o'rtacha| = 0.915228
  std=10.0   5 qatlamdan keyin chiqish |o'rtacha| = 0.992363
Juda kichik bo'lsa — signal o'ladi. Juda katta bo'lsa — to'yinadi (tanh da ±1 ga yopishadi).
Yechim: qatlam o'lchamiga qarab moslashtirilgan boshlash.
show(pd.DataFrame([
    {"Usul": "Xavier / Glorot", "Formula": "std = sqrt(2 / (n_kirish + n_chiqish))",
     "Qachon": "tanh, sigmoid", "Keras da": "glorot_uniform (SUKUT)"},
    {"Usul": "He / Kaiming", "Formula": "std = sqrt(2 / n_kirish)",
     "Qachon": "ReLU va variantlari", "Keras da": "he_normal"},
    {"Usul": "Nol", "Formula": "0", "Qachon": "FAQAT bias uchun", "Keras da": "zeros"},
]))
| Usul | Formula | Qachon | Keras da |
|---|---|---|---|
| Xavier / Glorot | std = sqrt(2 / (n_kirish + n_chiqish)) | tanh, sigmoid | glorot_uniform (SUKUT) |
| He / Kaiming | std = sqrt(2 / n_kirish) | ReLU va variantlari | he_normal |
| Nol | 0 | FAQAT bias uchun | zeros |
print("He va Xavier amalda — 10 qatlamli ReLU tarmoqda signal saqlanishi:")
print(f"{'boshlash':<22} {'10 qatlamdan keyin |chiqish|':>30}")
print("-" * 54)
n = 100
for nom, std in [("juda kichik (0.01)", 0.01), ("Xavier (sqrt(1/n))", np.sqrt(1/n)),
                 ("He (sqrt(2/n))", np.sqrt(2/n)), ("juda katta (0.5)", 0.5)]:
    a = r.normal(size=(300, n))
    for _ in range(10):
        a = np.maximum(0, a @ r.normal(0, std, (n, n)))
    print(f"{nom:<22} {np.abs(a).mean():>30.6f}")
He va Xavier amalda — 10 qatlamli ReLU tarmoqda signal saqlanishi:
boshlash                 10 qatlamdan keyin |chiqish|
------------------------------------------------------
juda kichik (0.01)                           0.000000
Xavier (sqrt(1/n))                           0.016119
He (sqrt(2/n))                               0.597205
juda katta (0.5)                        120407.435643
He boshlash ReLU uchun signalni barqaror saqlaydi — shuning uchun u ReLU tarmoqlarida standart.
Optimizerlar: gradient descent ning avlodlari
12-bobda eng oddiy qoidani ko'rganmiz:
Amalda bundan yaxshiroq usullar bor.
show(pd.DataFrame([
    {"Optimizer": "SGD", "G'oyasi": "Oddiy gradient descent",
     "Afzalligi": "Oddiy, kam xotira", "Kamchiligi": "Sekin, learning rate nozik"},
    {"Optimizer": "SGD + Momentum", "G'oyasi": "Oldingi yo'nalishni 'tezlik' sifatida saqlaydi",
     "Afzalligi": "Tebranishni kamaytiradi", "Kamchiligi": "Yana bitta parametr"},
    {"Optimizer": "RMSProp", "G'oyasi": "Har parametrga o'z learning rate i",
     "Afzalligi": "Har xil shkalaga moslashadi", "Kamchiligi": "Momentum yo'q"},
    {"Optimizer": "Adam", "G'oyasi": "Momentum + RMSProp birgalikda",
     "Afzalligi": "SUKUT TANLOV — ko'p hollarda ishlaydi", "Kamchiligi": "Ko'proq xotira"},
    {"Optimizer": "AdamW", "G'oyasi": "Adam + to'g'ri weight decay",
     "Afzalligi": "Transformer larda standart", "Kamchiligi": "-"},
]))
| Optimizer | G'oyasi | Afzalligi | Kamchiligi |
|---|---|---|---|
| SGD | Oddiy gradient descent | Oddiy, kam xotira | Sekin, learning rate nozik |
| SGD + Momentum | Oldingi yo'nalishni 'tezlik' sifatida saqlaydi | Tebranishni kamaytiradi | Yana bitta parametr |
| RMSProp | Har parametrga o'z learning rate i | Har xil shkalaga moslashadi | Momentum yo'q |
| Adam | Momentum + RMSProp birgalikda | SUKUT TANLOV — ko'p hollarda ishlaydi | Ko'proq xotira |
| AdamW | Adam + to'g'ri weight decay | Transformer larda standart | - |
Momentum g'oyasini ko'rsataman — jismoniy analogiya bilan: shar tepalikdan pastga dumalaydi va tezlik yig'adi.
def optimize(grad_f, boshlangich, alpha=0.1, qadamlar=60, usul="sgd", beta=0.9):
    w = np.array(boshlangich, dtype=float)
    v = np.zeros_like(w)
    s = np.zeros_like(w)
    yol = [w.copy()]
    for k in range(1, qadamlar + 1):
        g = grad_f(w)
        if usul == "sgd":
            w = w - alpha * g
        elif usul == "momentum":
            v = beta * v + (1 - beta) * g
            w = w - alpha * v / (1 - beta ** k)
        elif usul == "adam":
            v = 0.9 * v + 0.1 * g
            s = 0.999 * s + 0.001 * g ** 2
            v_t = v / (1 - 0.9 ** k)
            s_t = s / (1 - 0.999 ** k)
            w = w - alpha * v_t / (np.sqrt(s_t) + 1e-8)
        yol.append(w.copy())
    return np.array(yol)

# "cho'zilgan kosa" — bitta o'q bo'ylab tik, boshqasi bo'ylab yassi
def grad_choziq(w):
    return np.array([20 * w[0], 1 * w[1]])

yollar = {u: optimize(grad_choziq, [-4.0, -4.0], alpha=0.08, usul=u)
          for u in ["sgd", "momentum", "adam"]}

rasm, ax = plt.subplots(figsize=(9.5, 5))
xx, yy = np.meshgrid(np.linspace(-5, 2, 200), np.linspace(-5, 2, 200))
ax.contour(xx, yy, 10 * xx**2 + 0.5 * yy**2, levels=22, alpha=.3, colors="gray")
for (nom, yol), rang in zip(yollar.items(), ["#c5221f", "#f9ab00", "#137333"]):
    ax.plot(yol[:, 0], yol[:, 1], "o-", ms=3, lw=1.5, label=nom, color=rang, alpha=.85)
ax.plot(0, 0, "k*", ms=16, label="maqsad")
ax.legend(); ax.set_title("Cho'zilgan kosada uch optimizer", fontweight="bold")
ax.grid(alpha=.3)
fig("optimizerlar.png", caption="SGD zigzag qiladi. Momentum silliqroq. Adam har o'qqa o'z qadamini moslashtiradi.")

print(f"{'optimizer':<12} {'60 qadamdan keyin masofa':>26}")
print("-" * 40)
for nom, yol in yollar.items():
    print(f"{nom:<12} {np.linalg.norm(yol[-1]):>26.6f}")
optimizer      60 qadamdan keyin masofa
----------------------------------------
sgd                            0.026874
momentum                       0.055361
adam                           0.548182
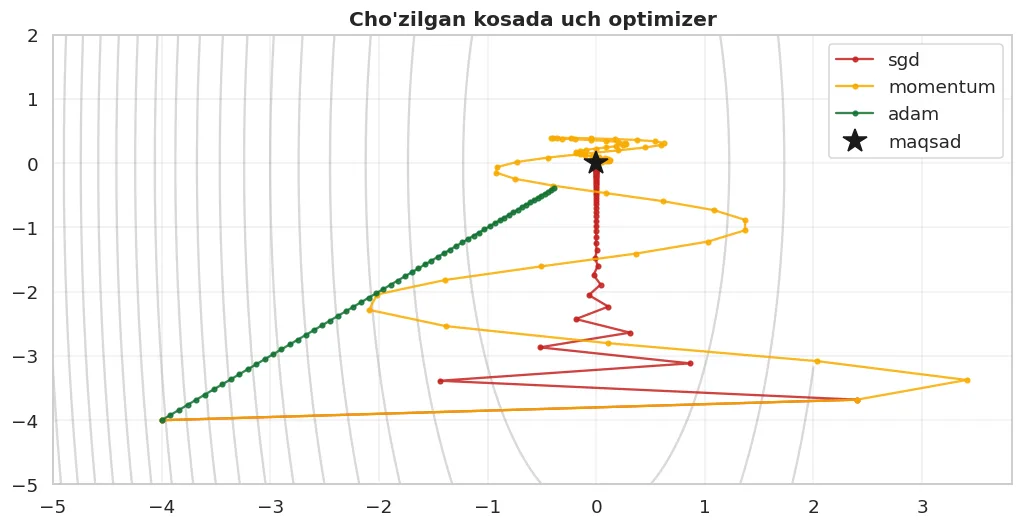
SGD zigzag qiladi. Momentum silliqroq. Adam har o'qqa o'z qadamini moslashtiradi.
Amalda: optimizerlarni taqqoslash
import os
os.environ.setdefault("CUDA_VISIBLE_DEVICES", "-1")   # CPU — takrorlanishi uchun
import torch
import torch.nn as nn
torch.manual_seed(42)
torch.set_num_threads(2)

from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
Xd = SimpleImputer(strategy="median").fit_transform(df[son])
yd = df["ijaraga_berildi_30k"].to_numpy(dtype=np.float32)
X_tr, X_te, y_tr, y_te = train_test_split(Xd, yd, test_size=0.3, random_state=42, stratify=yd)
sc = StandardScaler().fit(X_tr)
Xt = torch.tensor(sc.transform(X_tr), dtype=torch.float32)
Yt = torch.tensor(y_tr).unsqueeze(1)
Xv = torch.tensor(sc.transform(X_te), dtype=torch.float32)
Yv = torch.tensor(y_te).unsqueeze(1)

def oqit(opt_nom, epoxalar=120, lr=0.01):
    torch.manual_seed(42)
    model = nn.Sequential(nn.Linear(Xt.shape[1], 16), nn.ReLU(), nn.Linear(16, 1))
    kriteriy = nn.BCEWithLogitsLoss()
    opt = {"SGD": torch.optim.SGD(model.parameters(), lr=lr),
           "SGD+Momentum": torch.optim.SGD(model.parameters(), lr=lr, momentum=0.9),
           "RMSProp": torch.optim.RMSprop(model.parameters(), lr=lr),
           "Adam": torch.optim.Adam(model.parameters(), lr=lr)}[opt_nom]
    tarix = []
    for _ in range(epoxalar):
        opt.zero_grad()
        yoq = kriteriy(model(Xt), Yt)
        yoq.backward()
        opt.step()
        tarix.append(float(yoq))
    with torch.no_grad():
        val = float(kriteriy(model(Xv), Yv))
        aniq = float(((torch.sigmoid(model(Xv)) > .5).float() == Yv).float().mean())
    return tarix, val, aniq

print(f"{'optimizer':<16} {'train yo`qotish':>17} {'val yo`qotish':>15} {'val aniqlik':>13}")
print("-" * 66)
tarixlar = {}
for nom in ["SGD", "SGD+Momentum", "RMSProp", "Adam"]:
    tr, val, aniq = oqit(nom)
    tarixlar[nom] = tr
    print(f"{nom:<16} {tr[-1]:>17.4f} {val:>15.4f} {aniq:>13.4f}")
optimizer          train yo`qotish   val yo`qotish   val aniqlik
------------------------------------------------------------------
SGD                         0.6855          0.6862        0.5583
SGD+Momentum                0.5794          0.5214        0.7861
RMSProp                     0.5237          0.5020        0.7667
Adam                        0.5460          0.4952        0.7722
rasm, ax = plt.subplots(figsize=(9.5, 4.6))
for (nom, tr), rang in zip(tarixlar.items(), ["#c5221f", "#f9ab00", "#1a73e8", "#137333"]):
    ax.plot(tr, lw=2, label=nom, color=rang)
ax.set_xlabel("Epoxa"); ax.set_ylabel("Train yo'qotish")
ax.set_title("Bir xil tarmoq, to'rt optimizer", fontweight="bold")
ax.legend(); ax.grid(alpha=.3)
fig("optimizer_tarix.png", caption="Adam va RMSProp tezroq tushadi. Oddiy SGD sekinroq — lekin oxirida barchasi yaqinlashadi.")
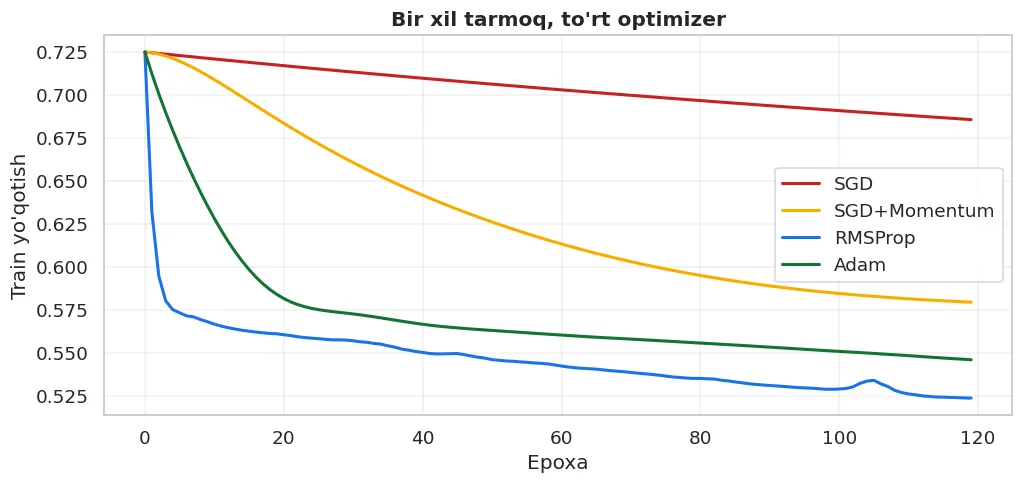
Adam va RMSProp tezroq tushadi. Oddiy SGD sekinroq — lekin oxirida barchasi yaqinlashadi.
Amaliy tanlov
Adam dan boshlang, lr=0.001 bilan (bu Keras va PyTorch da sukut).
Agar natija qoniqarsiz bo'lsa:
- lr ni 3 barobar kamaytiring yoki oshiring (0.0003 yoki 0.003)
- Transformer o'qitsangiz — AdamW
- Juda katta tarmoq va juda ko'p ma'lumot bo'lsa — SGD + momentum ba'zan yaxshiroq umumlashtiradi
Optimizer ni almashtirish — oxirgi variantlardan. Avval arxitektura va ma'lumotni tekshirasiz (10-bob).
Learning rate jadvali (schedule)
epoxalar = 100
jadvallar = {
    "doimiy": np.full(epoxalar, 0.01),
    "step (har 30 da /10)": 0.01 * (0.1 ** (np.arange(epoxalar) // 30)),
    "exponential": 0.01 * 0.97 ** np.arange(epoxalar),
    "cosine": 0.01 * (1 + np.cos(np.pi * np.arange(epoxalar) / epoxalar)) / 2,
}
rasm, ax = plt.subplots(figsize=(9.5, 4.2))
for nom, j in jadvallar.items():
    ax.plot(j, lw=2, label=nom)
ax.set_xlabel("Epoxa"); ax.set_ylabel("Learning rate")
ax.set_title("Learning rate jadvallari", fontweight="bold")
ax.legend(); ax.grid(alpha=.3)
fig("lr_jadval.png", caption="Boshida katta qadam (tez o'rganish), oxirida kichik qadam (aniq sozlash).")
print("G'oya: boshida tez harakat, oxirida ehtiyotkor sozlash.")
G'oya: boshida tez harakat, oxirida ehtiyotkor sozlash.
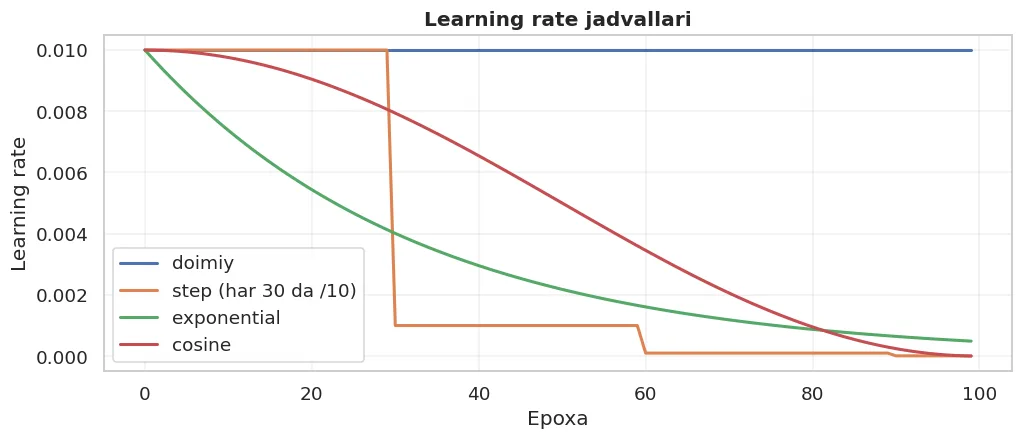
Boshida katta qadam (tez o'rganish), oxirida kichik qadam (aniq sozlash).
def oqit_jadval(jadval_nom, epoxalar=150):
    torch.manual_seed(42)
    model = nn.Sequential(nn.Linear(Xt.shape[1], 16), nn.ReLU(), nn.Linear(16, 1))
    opt = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9)
    sched = {"yo'q": None,
             "StepLR": torch.optim.lr_scheduler.StepLR(opt, step_size=50, gamma=0.1),
             "CosineAnnealing": torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=epoxalar)}[jadval_nom]
    kriteriy = nn.BCEWithLogitsLoss()
    for _ in range(epoxalar):
        opt.zero_grad(); yoq = kriteriy(model(Xt), Yt); yoq.backward(); opt.step()
        if sched: sched.step()
    with torch.no_grad():
        return float(kriteriy(model(Xv), Yv)), float(((torch.sigmoid(model(Xv)) > .5).float() == Yv).float().mean())

print(f"{'jadval':<20} {'val yo`qotish':>15} {'val aniqlik':>13}")
print("-" * 52)
for nom in ["yo'q", "StepLR", "CosineAnnealing"]:
    v, a = oqit_jadval(nom)
    print(f"{nom:<20} {v:>15.4f} {a:>13.4f}")
jadval                 val yo`qotish   val aniqlik
----------------------------------------------------
yo'q                          0.5028        0.7694
StepLR                        0.5024        0.7722
CosineAnnealing               0.5049        0.7694
Batch Normalization va Dropout
show(pd.DataFrame([
    {"Usul": "BatchNorm", "Nima qiladi": "Har qatlam chiqishini normallashtiradi",
     "Foydasi": "Tezroq o'qitish, kattaroq lr ga ruxsat", "Qayerda": "Linear/Conv dan KEYIN"},
    {"Usul": "Dropout", "Nima qiladi": "O'qitishda neyronlarning qismini tasodifiy o'chiradi",
     "Foydasi": "Overfitting ni kamaytiradi", "Qayerda": "Yashirin qatlamlardan keyin"},
]))
| Usul | Nima qiladi | Foydasi | Qayerda |
|---|---|---|---|
| BatchNorm | Har qatlam chiqishini normallashtiradi | Tezroq o'qitish, kattaroq lr ga ruxsat | Linear/Conv dan KEYIN |
| Dropout | O'qitishda neyronlarning qismini tasodifiy o'chiradi | Overfitting ni kamaytiradi | Yashirin qatlamlardan keyin |
def oqit_arxitektura(nom, epoxalar=200):
    torch.manual_seed(42)
    n = Xt.shape[1]
    model = {
        "oddiy": nn.Sequential(nn.Linear(n, 64), nn.ReLU(), nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 1)),
        "+ BatchNorm": nn.Sequential(nn.Linear(n, 64), nn.BatchNorm1d(64), nn.ReLU(),
                                     nn.Linear(64, 32), nn.BatchNorm1d(32), nn.ReLU(), nn.Linear(32, 1)),
        "+ Dropout(0.3)": nn.Sequential(nn.Linear(n, 64), nn.ReLU(), nn.Dropout(0.3),
                                        nn.Linear(64, 32), nn.ReLU(), nn.Dropout(0.3), nn.Linear(32, 1)),
    }[nom]
    opt = torch.optim.Adam(model.parameters(), lr=0.01)
    kriteriy = nn.BCEWithLogitsLoss()
    for _ in range(epoxalar):
        model.train()
        opt.zero_grad(); yoq = kriteriy(model(Xt), Yt); yoq.backward(); opt.step()
    model.eval()
    with torch.no_grad():
        tr_y = float(kriteriy(model(Xt), Yt))
        va_y = float(kriteriy(model(Xv), Yv))
        aniq = float(((torch.sigmoid(model(Xv)) > .5).float() == Yv).float().mean())
    return tr_y, va_y, aniq

print(f"{'arxitektura':<18} {'train yo`q':>12} {'val yo`q':>11} {'farq':>8} {'val aniqlik':>13}")
print("-" * 68)
for nom in ["oddiy", "+ BatchNorm", "+ Dropout(0.3)"]:
    tr_y, va_y, aniq = oqit_arxitektura(nom)
    print(f"{nom:<18} {tr_y:>12.4f} {va_y:>11.4f} {va_y-tr_y:>8.4f} {aniq:>13.4f}")
arxitektura          train yo`q    val yo`q     farq   val aniqlik
--------------------------------------------------------------------
oddiy                    0.1152      1.2849   1.1697        0.6472
+ BatchNorm              0.1498      0.9738   0.8240        0.6500
+ Dropout(0.3)           0.4290      0.5522   0.1232        0.7333
"farq" ustuni — overfitting o'lchovi (1-bobdagi train/test farqi). Dropout uni kamaytirishi kutiladi.
Dropout ni `eval()` rejimida O'CHIRISH kerak
PyTorch da model.train() va model.eval() farqi hayotiy:
train()— Dropout neyronlarni o'chiradi, BatchNorm partiya statistikasini ishlatadieval()— Dropout o'chadi, BatchNorm saqlangan statistikani ishlatadi
Agar eval() ni chaqirmasangiz, bashoratlaringiz har chaqirishda boshqa bo'ladi — chunki Dropout tasodifiy ishlaydi.
Bu — PyTorch da eng ko'p uchraydigan xato. Keras da bu avtomatik.
torch.manual_seed(0)
m_drop = nn.Sequential(nn.Linear(Xt.shape[1], 16), nn.ReLU(), nn.Dropout(0.5), nn.Linear(16, 1))
m_drop.train()
with torch.no_grad():
    uch_marta = [float(m_drop(Xv[:1])) for _ in range(3)]
m_drop.eval()
with torch.no_grad():
    eval_uch = [float(m_drop(Xv[:1])) for _ in range(3)]
print(f"train() rejimida 3 marta: {[round(v, 4) for v in uch_marta]}  <-- HAR XIL")
print(f"eval()  rejimida 3 marta: {[round(v, 4) for v in eval_uch]}  <-- bir xil")
train() rejimida 3 marta: [-0.113, -0.1975, -0.7742]  <-- HAR XIL
eval()  rejimida 3 marta: [-0.4892, -0.4892, -0.4892]  <-- bir xil
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Backpropagation", "Bitta jumla": "Zanjir qoidasi — sehr emas"},
    {"Tushuncha": "Gradient tekshirish", "Bitta jumla": "Analitik va raqamli gradient mos kelishi kerak"},
    {"Tushuncha": "Gradient yo'qolishi", "Bitta jumla": "Sigmoid hosilasi max 0.25 — 20 qatlamda 9e-13"},
    {"Tushuncha": "Vaznni boshlash", "Bitta jumla": "Nol bo'lmaydi (simmetriya); ReLU uchun He"},
    {"Tushuncha": "Adam", "Bitta jumla": "Momentum + RMSProp; sukut tanlov, lr=0.001"},
    {"Tushuncha": "LR jadvali", "Bitta jumla": "Boshida katta qadam, oxirida kichik"},
    {"Tushuncha": "BatchNorm", "Bitta jumla": "Tezroq o'qitish, kattaroq lr"},
    {"Tushuncha": "Dropout", "Bitta jumla": "Overfitting ga qarshi; eval() da o'chadi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Backpropagation | Zanjir qoidasi — sehr emas |
| Gradient tekshirish | Analitik va raqamli gradient mos kelishi kerak |
| Gradient yo'qolishi | Sigmoid hosilasi max 0.25 — 20 qatlamda 9e-13 |
| Vaznni boshlash | Nol bo'lmaydi (simmetriya); ReLU uchun He |
| Adam | Momentum + RMSProp; sukut tanlov, lr=0.001 |
| LR jadvali | Boshida katta qadam, oxirida kichik |
| BatchNorm | Tezroq o'qitish, kattaroq lr |
| Dropout | Overfitting ga qarshi; eval() da o'chadi |
Keyingi bobda: shu tushunchalarni Keras bilan amalda qo'llaymiz — ancha kam kod bilan.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.