RNN, LSTM va vaqt qatorlari
Sahna: ustunlar tartibi muhim bo'lganda
Shu paytgacha har bir qator mustaqil edi. Uy ijarasida 5-qatorni 500-qator bilan almashtirsak, hech narsa o'zgarmaydi.
Endi boshqa ma'lumot turi: vaqt qatori. Toshkentda o'rtacha ijara narxi, oyma-oy.
Bu yerda tartib — ma'lumotning o'zi. Aralashtirsangiz, ma'lumot yo'qoladi.
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "-1"
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
from torch.utils.data import TensorDataset, DataLoader
from sklearn.linear_model import LinearRegression
from sklearn.neighbors import KNeighborsRegressor
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error
from sklearn.model_selection import train_test_split

torch.set_num_threads(4)

r = np.random.default_rng(7)
OYLAR = 400
oy = np.arange(OYLAR)
qator = (420 + 0.9 * oy + 38 * np.sin(2 * np.pi * oy / 12) + r.normal(0, 14, OYLAR)).round(2)
seriya = pd.Series(qator, index=pd.date_range("1993-01-01", periods=OYLAR, freq="MS"))

print(f"Qator uzunligi : {OYLAR} oy")
print(f"Diapazon       : {qator.min():.1f} .. {qator.max():.1f}")
print(f"Birinchi yil   : {qator[:12].mean():.1f}")
print(f"Oxirgi yil     : {qator[-12:].mean():.1f}")
print()
print("Ichida uch narsa bor: TREND (o'sish), SEZONLIK (12 oylik to'lqin), SHOVQIN.")
Qator uzunligi : 400 oy
Diapazon       : 379.3 .. 827.1
Birinchi yil   : 423.6
Oxirgi yil     : 769.7

Ichida uch narsa bor: TREND (o'sish), SEZONLIK (12 oylik to'lqin), SHOVQIN.
rasm, (a1, a2) = plt.subplots(2, 1, figsize=(12, 6.5))
a1.plot(seriya.index, seriya.values, lw=1.1)
a1.set_title("To'liq qator: trend + sezonlik")
a1.set_ylabel("narx")
a2.plot(seriya.index[-48:], seriya.values[-48:], marker="o", ms=3.5, lw=1.2)
a2.set_title("Oxirgi 48 oy — sezonlik yaqindan ko'rinadi")
a2.set_ylabel("narx")
plt.tight_layout()
fig("qator.png", caption="Vaqt qatori: o'sish tendentsiyasi ustiga 12 oylik mavsumiy to'lqin qo'yilgan.")
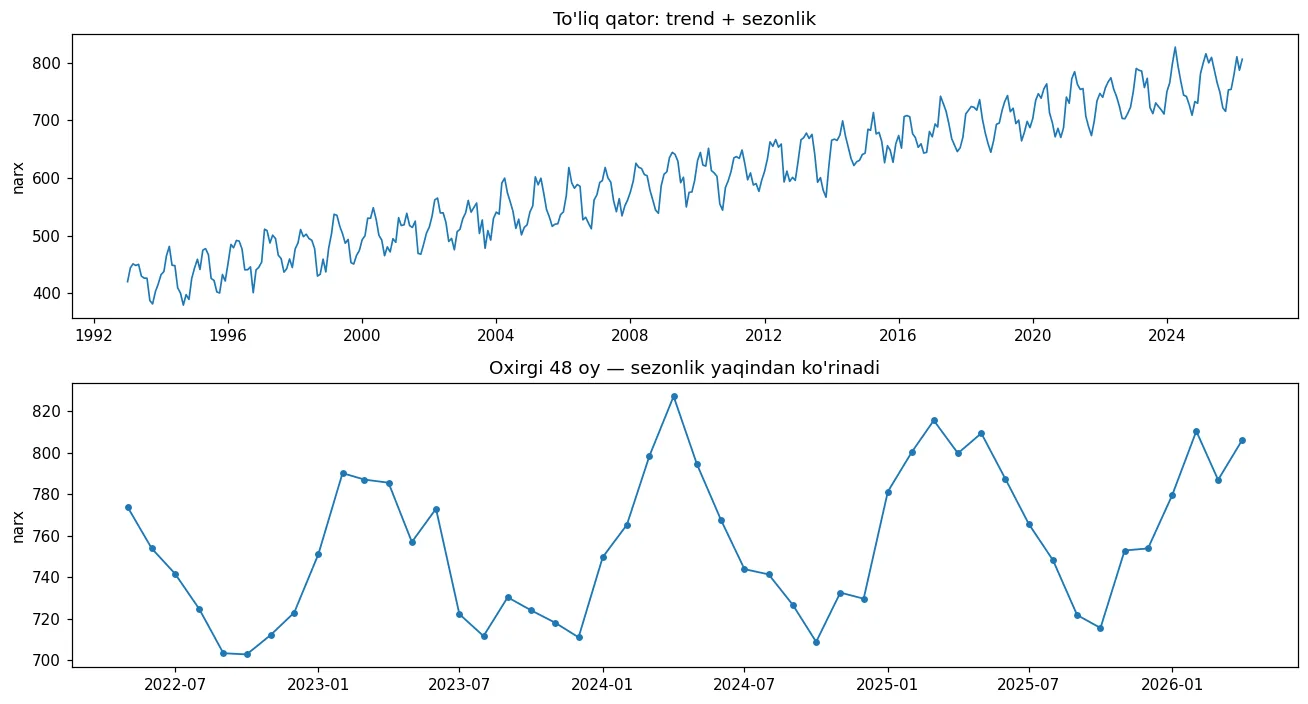
Vaqt qatori: o'sish tendentsiyasi ustiga 12 oylik mavsumiy to'lqin qo'yilgan.
Lag ustunlari: qatorni jadvalga aylantirish
ML modellari jadval kutadi. Vaqt qatorini jadvalga aylantirish usuli — lag oyna: oxirgi L oyga qarab keyingi oyni aytamiz.
L = 12
X = np.stack([qator[i:i + L] for i in range(OYLAR - L)])
y = qator[L:]

print(f"Oyna uzunligi L = {L}")
print(f"X shakli: {X.shape}   y shakli: {y.shape}")
print()
print("Muhim kuzatish — qo'shni oynalar bir-biriga juda o'xshaydi:")
print(f"  oyna 0: {X[0][:5]} ...")
print(f"  oyna 1: {X[1][:5]} ...")
print(f"  umumiy qiymatlar soni: {len(set(X[0]) & set(X[1]))} / {L}")
Oyna uzunligi L = 12
X shakli: (388, 12)   y shakli: (388,)

Muhim kuzatish — qo'shni oynalar bir-biriga juda o'xshaydi:
  oyna 0: [420.02 444.08 450.87 448.23 450.14] ...
  oyna 1: [444.08 450.87 448.23 450.14 429.62] ...
  umumiy qiymatlar soni: 11 / 12
Split: bu yerda tasodifiy bo'linish YOLG'ON gapiradi
5-bobda aytganmiz: split to'g'ri bo'lmasa, hamma metrika ma'nosiz. Vaqt qatorida bu xato boshqa shaklda keladi.
To'g'ri yo'l — xronologik split: avval o'qit, keyingi davrda sinab ko'r. Chunki amalda siz kelasi oyni bashorat qilasiz, o'tgan oyni emas.
Buni o'lchab ko'ramiz.
kesish = int(len(X) * 0.8)
Xtr, Xte, ytr, yte = X[:kesish], X[kesish:], y[:kesish], y[kesish:]
Xa, Xb, ya, yb = train_test_split(X, y, test_size=0.2, random_state=42)

print(f"Xronologik: train {len(Xtr)} oy -> test {len(Xte)} oy (keyingi davr)")
print(f"Tasodifiy : train {len(Xa)} oy -> test {len(Xb)} oy (vaqt bo'ylab aralash)")
print()
print(f"Train target diapazoni (xronologik): {ytr.min():.1f} .. {ytr.max():.1f}")
print(f"Test  target diapazoni (xronologik): {yte.min():.1f} .. {yte.max():.1f}")
print()
print(f"Test ning {float((yte > ytr.max()).mean()):.1%} qismi train dagi ENG KATTA qiymatdan yuqori.")
print("Ya'ni model EKSTRAPOLYATSIYA qilishi kerak — ko'rmagan diapazonga chiqishi kerak.")
Xronologik: train 310 oy -> test 78 oy (keyingi davr)
Tasodifiy : train 310 oy -> test 78 oy (vaqt bo'ylab aralash)

Train target diapazoni (xronologik): 379.3 .. 743.0
Test  target diapazoni (xronologik): 670.2 .. 827.1

Test ning 51.3% qismi train dagi ENG KATTA qiymatdan yuqori.
Ya'ni model EKSTRAPOLYATSIYA qilishi kerak — ko'rmagan diapazonga chiqishi kerak.
modellar = [
    ("linear regression", lambda: LinearRegression()),
    ("KNN (k=3)", lambda: KNeighborsRegressor(3)),
    ("random forest", lambda: RandomForestRegressor(200, random_state=0)),
]
jadval = []
for nom, yasa in modellar:
    xron = mean_absolute_error(yte, yasa().fit(Xtr, ytr).predict(Xte))
    tasod = mean_absolute_error(yb, yasa().fit(Xa, ya).predict(Xb))
    jadval.append({"model": nom, "xronologik MAE": round(xron, 2),
                   "tasodifiy MAE": round(tasod, 2), "farq": round(tasod - xron, 2)})
show(pd.DataFrame(jadval))
| model | xronologik MAE | tasodifiy MAE | farq |
|---|---|---|---|
| linear regression | 12.34 | 11.54 | -0.8 |
| KNN (k=3) | 43.9 | 14.22 | -29.68 |
| random forest | 33.33 | 13.95 | -19.38 |
Jadvalga qarang. Tasodifiy split hamma model uchun "yaxshi" natija beradi. Xronologik split esa haqiqatni aytadi: KNN va random forest bu vazifada ishlamaydi.
Daraxt va KNN EKSTRAPOLYATSIYA QILA OLMAYDI
Men bu bo'limni "qo'shni oynalar bir xil, shuning uchun tasodifiy split leakage beradi" degan taxmin bilan boshlagandim. O'lchov buni rad etdi — sabab boshqa.
Random forest bashorati — train dagi target qiymatlarning o'rtachasi. KNN bashorati — eng yaqin qo'shnilarning o'rtachasi. Ikkisi ham train dagi eng katta qiymatdan yuqoriga chiqa olmaydi. Matematik jihatdan mumkin emas.
Qatorda trend bor, ya'ni kelajak qiymatlari o'tmishdan yuqori. Shuning uchun bu modellar tuzilishiga ko'ra xato qiladi.
Linear regression esa ekstrapolyatsiya qila oladi (u chiziq, chiziqni davom ettirish mumkin) — shuning uchun uning natijasi ikki splitda ham deyarli bir xil.
Tasodifiy split buni yashiradi: test nuqtalari train nuqtalari orasiga aralashib ketadi, hech qanday ekstrapolyatsiya kerak bo'lmaydi. Siz 13-14 MAE ko'rasiz va modelni ishlab chiqarishga chiqarasiz. Amalda esa 33-44 MAE olasiz.
Qoida: vaqt qatorida split har doim xronologik. Va trendli qatorda daraxt modellarini ishlatmoqchi bo'lsangiz, avval trendni ayiring (differensiyalash).
m_knn = KNeighborsRegressor(3).fit(Xtr, ytr)
m_lin = LinearRegression().fit(Xtr, ytr)
rasm, ax = plt.subplots(figsize=(12, 4.2))
ind = np.arange(len(yte))
ax.plot(ind, yte, "k-", lw=2, label="haqiqiy")
ax.plot(ind, m_knn.predict(Xte), "--", lw=1.6, label="KNN bashorati")
ax.plot(ind, m_lin.predict(Xte), "--", lw=1.6, label="linear regression bashorati")
ax.axhline(ytr.max(), color="red", ls=":", lw=1.4, label=f"train dagi maksimum ({ytr.max():.0f})")
ax.set_title("KNN qizil chizidan yuqoriga CHIQA OLMAYDI")
ax.set_xlabel("test oyi"); ax.set_ylabel("narx"); ax.legend(fontsize=9)
fig("ekstrapolyatsiya.png", caption="KNN bashorati train dagi maksimumga urilib qoladi. Linear regression trendni davom ettiradi.")
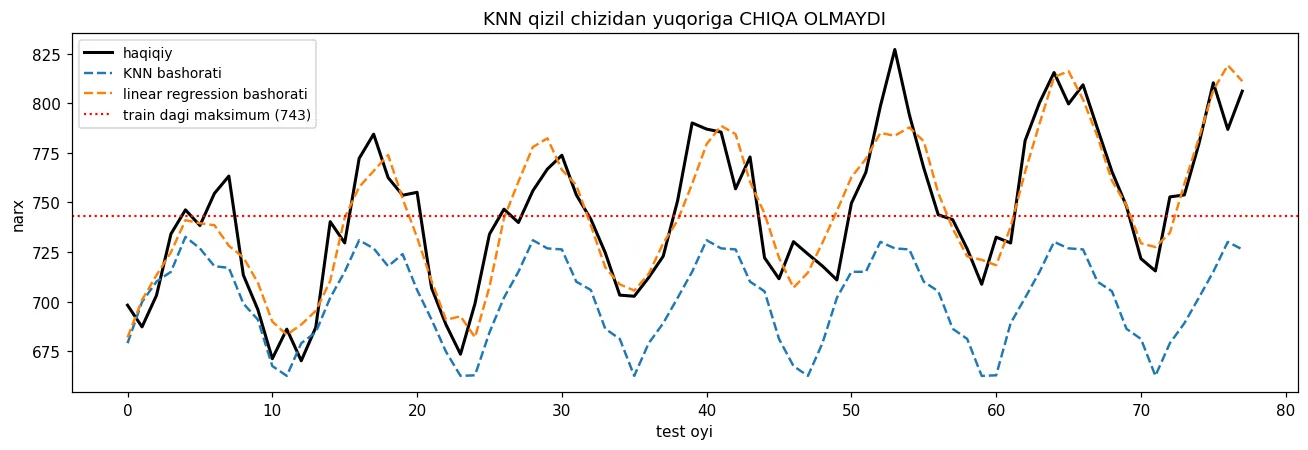
KNN bashorati train dagi maksimumga urilib qoladi. Linear regression trendni davom ettiradi.
Baza: bashorat uchun eng oddiy raqib
6-bobdagi qoida bu yerda ham ishlaydi — avval baza. Vaqt qatorida ikkita klassik baza bor.
bazalar = {
    "naive (oxirgi qiymat)": Xte[:, -1],
    "sezonli naive (12 oy oldin)": Xte[:, 0],
}
natija = [{"usul": k, "MAE": round(mean_absolute_error(yte, v), 2)} for k, v in bazalar.items()]
natija.append({"usul": "linear regression (12 lag)",
               "MAE": round(mean_absolute_error(yte, m_lin.predict(Xte)), 2)})
show(pd.DataFrame(natija))
print("Har qanday murakkab model SHU raqamlardan past MAE bermasa — keraksiz.")
Har qanday murakkab model SHU raqamlardan past MAE bermasa — keraksiz.
| usul | MAE |
|---|---|
| naive (oxirgi qiymat) | 19.47 |
| sezonli naive (12 oy oldin) | 18.25 |
| linear regression (12 lag) | 12.34 |
RNN: xotirali tarmoq
Endi ketma-ketlik uchun maxsus arxitektura. Oddiy tarmoq butun oynani birdan ko'radi. RNN esa qadamba-qadam yuradi va o'zida yashirin holat (hidden state) saqlaydi.
diagramma(
    {
        "x1\n1-oy": (0.2, 2.5, 1.4, 0.7, "manba"),
        "x2\n2-oy": (2.1, 2.5, 1.4, 0.7, "manba"),
        "x3\n3-oy": (4.0, 2.5, 1.4, 0.7, "manba"),
        "h1": (0.2, 1.3, 1.4, 0.7, "qayta"),
        "h2": (2.1, 1.3, 1.4, 0.7, "qayta"),
        "h3": (4.0, 1.3, 1.4, 0.7, "qayta"),
        "javob": (4.0, 0.1, 1.4, 0.7, "xizmat"),
    },
    [("x1\n1-oy", "h1"), ("x2\n2-oy", "h2"), ("x3\n3-oy", "h3"),
     ("h1", "h2", "holat"), ("h2", "h3", "holat"), ("h3", "javob")],
    nom="rnn_sxema.png",
    izoh="RNN qadamba-qadam yuradi. Yashirin holat o'ngga uzatiladi, "
         "oxirgi holat javob beradi. Birinchi oyning ta'siri shu zanjir orqali o'tishi kerak.",
)
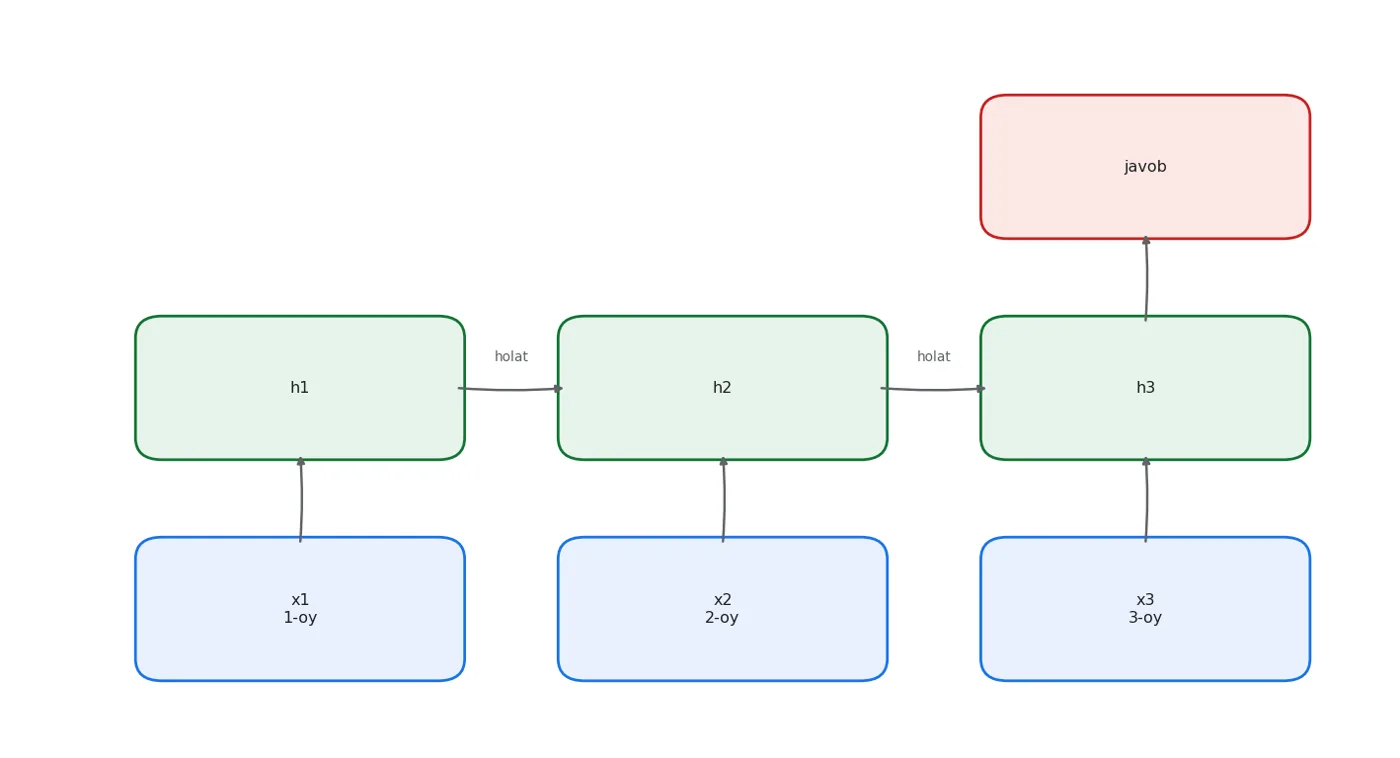
RNN qadamba-qadam yuradi. Yashirin holat o'ngga uzatiladi, oxirgi holat javob beradi. Birinchi oyning ta'siri shu zanjir orqali o'tishi kerak.
h = 32
rnn = nn.RNN(1, h, batch_first=True)
lstm = nn.LSTM(1, h, batch_first=True)
print(f"nn.RNN(1, {h})  parametrlar: {sum(p.numel() for p in rnn.parameters())}")
print(f"nn.LSTM(1, {h}) parametrlar: {sum(p.numel() for p in lstm.parameters())}  (4 barobar — 4 ta darvoza)")
print()
print("LSTM ning 4 darvozasi: unutish, kirish, chiqish va yacheyka yangilanishi.")
print("Nazariy g'oya: darvozalar 'nimani eslab qolish'ni o'rganadi.")
nn.RNN(1, 32)  parametrlar: 1120
nn.LSTM(1, 32) parametrlar: 4480  (4 barobar — 4 ta darvoza)

LSTM ning 4 darvozasi: unutish, kirish, chiqish va yacheyka yangilanishi.
Nazariy g'oya: darvozalar 'nimani eslab qolish'ni o'rganadi.
Sinov: uzoq masofali xotira
Nazariya aytadi: oddiy RNN uzoq ketma-ketlikni eslab qolmaydi, LSTM esa qoladi. O'lchaymiz.
Vazifa ataylab eng sof shaklda: ketma-ketlikning faqat birinchi elementi javobni belgilaydi. Qolgani shovqin. Model T qadam oxirigacha shu bitta faktni eslab turishi kerak.
def xotira_vazifasi(n, T, seed=0):
    rr = np.random.default_rng(seed)
    Xs = rr.normal(0, 1, (n, T, 1)).astype(np.float32)
    return torch.tensor(Xs), torch.tensor((Xs[:, 0, 0] > 0).astype(np.int64))

class Ketma(nn.Module):
    def __init__(self, turi, h=32):
        super().__init__()
        self.rnn = nn.RNN(1, h, batch_first=True) if turi == "rnn" else nn.LSTM(1, h, batch_first=True)
        self.fc = nn.Linear(h, 2)
    def forward(self, x):
        chiqish, _ = self.rnn(x)
        return self.fc(chiqish[:, -1])

def ketma_oqit(turi, T, seed, epoxalar=60, n=2000):
    torch.manual_seed(seed)
    Xtr_, ytr_ = xotira_vazifasi(n, T, 1)
    Xte_, yte_ = xotira_vazifasi(600, T, 2)
    m = Ketma(turi)
    opt = torch.optim.Adam(m.parameters(), lr=0.005)
    krit = nn.CrossEntropyLoss()
    dl = DataLoader(TensorDataset(Xtr_, ytr_), batch_size=64, shuffle=True,
                    generator=torch.Generator().manual_seed(seed))
    for _ in range(epoxalar):
        m.train()
        for xb, yb_ in dl:
            opt.zero_grad(); krit(m(xb), yb_).backward(); opt.step()
    m.eval()
    with torch.no_grad():
        return float((m(Xte_).argmax(1) == yte_).float().mean())

print("Tasodifiy javob = 0.50 aniqlik. Har konfiguratsiya 3 SEED bilan.")
qatorlar = []
for T in [5, 20, 60]:
    for turi in ["rnn", "lstm"]:
        aniq = [ketma_oqit(turi, T, s) for s in (0, 1, 2)]
        qatorlar.append({"uzunlik T": T, "model": turi,
                         "seedlar": str([round(a, 3) for a in aniq]),
                         "o'rtacha": round(float(np.mean(aniq)), 4),
                         "eng yomon": round(min(aniq), 4)})
show(pd.DataFrame(qatorlar))
Tasodifiy javob = 0.50 aniqlik. Har konfiguratsiya 3 SEED bilan.
| uzunlik T | model | seedlar | o'rtacha | eng yomon |
|---|---|---|---|---|
| 5 | rnn | [0.997, 0.995, 0.998] | 0.997 | 0.995 |
| 5 | lstm | [0.998, 0.997, 0.998] | 0.998 | 0.997 |
| 20 | rnn | [0.933, 0.942, 0.838] | 0.904 | 0.838 |
| 20 | lstm | [0.813, 0.493, 0.997] | 0.768 | 0.493 |
| 60 | rnn | [0.847, 0.98, 0.98] | 0.936 | 0.847 |
| 60 | lstm | [0.542, 0.97, 0.517] | 0.676 | 0.517 |
Jadvalni diqqat bilan o'qing. Men bu bo'limga "LSTM uzoq ketma-ketlikda ustun keladi" deb yozmoqchi edim. O'lchov boshqa narsa ko'rsatdi.
Bitta seed bilan chiqarilgan xulosa — xulosa emas
LSTM natijalari ikki qutbli: ba'zi seedlarda vazifani deyarli to'liq yechadi, ba'zilarida tasodifiy javob darajasida qoladi.
Bu — sig'im muammosi emas, optimizatsiya muammosi. Arxitektura yecha oladi (buni muvaffaqiyatli seedlar isbotlaydi), lekin o'qitish har doim shu yechimga yetib bormaydi.
Amaliy xulosa ikkita:
- Neyron tarmoq natijasini bitta seed bilan o'lchash — o'lchamaslik bilan teng. 31-bobda TensorFlow takrorlanmasligini ko'rgandik; bu — shu muammoning jiddiyroq shakli. Kamida 3 seed, va eng yomon natijani ham yozing.
- "Kitobda X yaxshi deyilgan" — bu sizning ma'lumotingizda va sizning o'qitish budjetingizda X yaxshi degani emas.
Men klassik tuzatishni ham sinab ko'rdim: LSTM ning unutish darvozasi bias ini 1 ga qo'yish (adabiyotda tavsiya etiladi). Bu konfiguratsiyada yordam bermadi — natija yaxshilanmadi. Shuning uchun uni kitobga "yechim" sifatida yozmadim.
Nega uzoq masofa qiyin: gradientni o'lchaymiz
30-bobda backpropagation ni ko'rganmiz. Ketma-ketlikda gradient vaqt bo'ylab orqaga qaytadi — va yo'lda kichrayadi.
print("Kirishning har qadami bo'yicha gradient kattaligi (T=60, o'qitishdan oldin):")
print()
for turi in ["rnn", "lstm"]:
    torch.manual_seed(0)
    Xg, yg = xotira_vazifasi(256, 60, 1)
    Xg.requires_grad_(True)
    m = Ketma(turi)
    nn.CrossEntropyLoss()(m(Xg), yg).backward()
    g = Xg.grad.abs().mean(dim=(0, 2))
    print(f"  {turi.upper():>5}: qadam 0 -> {g[0]:.3e} | qadam 30 -> {g[30]:.3e} | "
          f"qadam 59 -> {g[59]:.3e}")
    print(f"         qadam 59 / qadam 0 nisbati: {g[59] / g[0]:.2e}")
Kirishning har qadami bo'yicha gradient kattaligi (T=60, o'qitishdan oldin):

    RNN: qadam 0 -> 2.427e-17 | qadam 30 -> 7.964e-11 | qadam 59 -> 1.129e-05
         qadam 59 / qadam 0 nisbati: 4.65e+11
   LSTM: qadam 0 -> 2.503e-17 | qadam 30 -> 4.343e-11 | qadam 59 -> 2.982e-05
         qadam 59 / qadam 0 nisbati: 1.19e+12
Mana muammoning ildizi: javobni belgilaydigan birinchi qadamga yetib boradigan gradient oxirgi qadamdagidan ko'p marta kichik. Model "birinchi element muhim" degan xulosani chiqarish uchun juda kuchsiz signal oladi.
Shuning uchun amalda uzoq kontekst uchun RNN ham, LSTM ham emas — attention ishlatiladi. U har qadamga to'g'ridan-to'g'ri yo'l beradi. Keyingi bob shu haqda.
LSTM bashorat uchun foydalimi?
Endi asosiy savol: bizning ijara qatorida LSTM linear regression dan ustun keladimi?
def lstm_bashorat(seed, epoxalar, differensiya=False):
    torch.manual_seed(seed)
    if differensiya:
        Xa, Xb = np.diff(Xtr, axis=1), np.diff(Xte, axis=1)
        ya, baza = ytr - Xtr[:, -1], Xte[:, -1]
    else:
        Xa, Xb, ya, baza = Xtr, Xte, ytr, 0.0
    mu_, sd_ = Xa.mean(), Xa.std()
    ymu, ysd = ya.mean(), ya.std()
    yadro = nn.LSTM(1, 32, batch_first=True)
    boshi = nn.Linear(32, 1)
    opt = torch.optim.Adam(nn.ModuleList([yadro, boshi]).parameters(), lr=0.01)
    xt = torch.tensor(((Xa - mu_) / sd_).astype(np.float32)).unsqueeze(-1)
    yt = torch.tensor(((ya - ymu) / ysd).astype(np.float32)).unsqueeze(-1)
    dl = DataLoader(TensorDataset(xt, yt), batch_size=32, shuffle=True,
                    generator=torch.Generator().manual_seed(seed))
    for _ in range(epoxalar):
        for xb, yb_ in dl:
            opt.zero_grad()
            o, _ = yadro(xb)
            nn.MSELoss()(boshi(o[:, -1]), yb_).backward()
            opt.step()
    with torch.no_grad():
        o, _ = yadro(torch.tensor(((Xb - mu_) / sd_).astype(np.float32)).unsqueeze(-1))
        return boshi(o[:, -1]).squeeze(-1).numpy() * ysd + ymu + baza

tajribalar = [
    ("LSTM, xom qator, 120 epoxa", dict(epoxalar=120)),
    ("LSTM, xom qator, 400 epoxa", dict(epoxalar=400)),
    ("LSTM, DIFFERENSIYALANGAN, 400 epoxa", dict(epoxalar=400, differensiya=True)),
]
oxirgi = [
    {"usul": "naive (oxirgi qiymat)", "MAE": round(mean_absolute_error(yte, Xte[:, -1]), 2),
     "seedlar": "-"},
    {"usul": "linear regression (12 lag)",
     "MAE": round(mean_absolute_error(yte, m_lin.predict(Xte)), 2), "seedlar": "-"},
]
for nom, kw in tajribalar:
    xs_ = [mean_absolute_error(yte, lstm_bashorat(s, **kw)) for s in (0, 1, 2)]
    oxirgi.append({"usul": nom, "MAE": round(float(np.mean(xs_)), 2),
                   "seedlar": str([round(v, 1) for v in xs_])})
show(pd.DataFrame(oxirgi))
| usul | MAE | seedlar |
|---|---|---|
| naive (oxirgi qiymat) | 19.47 | - |
| linear regression (12 lag) | 12.34 | - |
| LSTM, xom qator, 120 epoxa | 30.36 | [40.9, 21.5, 28.7] |
| LSTM, xom qator, 400 epoxa | 30.73 | [25.9, 33.7, 32.7] |
| LSTM, DIFFERENSIYALANGAN, 400 epoxa | 17.87 | [19.8, 15.6, 18.2] |
Jadvaldan uchta xulosa chiqadi, va ikkinchisi meni to'xtatdi.
Birinchi: xom qatorda LSTM naive bazadan ham yomon ishlaydi.
Ikkinchi: epoxalarni 120 dan 400 ga oshirish yordam bermadi. Men avval "LSTM ga kam o'qitish berdim, taqqoslash adolatsiz" deb o'yladim va budjetni uch barobar oshirdim. Natija o'zgarmadi. Demak muammo o'qitish budjetida emas — tuzilishda.
Uchinchi: qatorni differensiyalagandan keyin LSTM sezilarli yaxshilandi.
Neyron tarmoq ham trendni ekstrapolyatsiya qila olmaydi
Yuqorida KNN va random forest train maksimumidan yuqoriga chiqa olmasligini ko'rdik. LSTM uchun ham xuddi shu muammo bor, faqat sabab boshqa: biz kirishni train statistikasi bilan normallashtiramiz ((x - mu) / sd). Test qiymatlari train diapazonidan tashqarida bo'lgani uchun model hech qachon ko'rmagan kattalikdagi kirish oladi.
Yechim — target ni o'zgarish sifatida qo'yish: "keyingi oy narxi" emas, "keyingi oy narxi oxirgi oydan qancha farq qiladi". O'zgarishlar trendsiz va barqaror diapazonda bo'ladi.
Kodda shu: ya = ytr - Xtr[:, -1] va bashoratga baza = Xte[:, -1] qaytarib qo'shiladi.
Bu — vaqt qatori bilan ishlashda birinchi qilinadigan amal, model tanlashdan oldin. Statistikada u differensiyalash deb ataladi.
Vaqt qatorida avval klassik usullar
Bu kitobda yana bir marta bir xil naqsh: murakkab model oddiy modeldan ustun kelmadi. Differensiyalashdan keyin ham LSTM 12 ta lag ustiga qurilgan oddiy linear regression dan past qoldi.
Vaqt qatori uchun amaliy tartib: 1. naive va sezonli naive — baza 2. differensiyalash — trendni ayirish 3. lag ustunlari + linear regression / Ridge — ko'pincha shu yetarli 4. ARIMA, Prophet, ETS — statistik usullar (bu kitob qamrovidan tashqari, lekin mavjud) 5. gradient boosting — differensiyalangan qatorda 6. LSTM / Transformer — ko'p qator va ko'p ma'lumot bo'lganda
LSTM ni birinchi urinish qilib tanlash — eng ko'p uchraydigan xato.
Qanday qilib to'g'ri cross-validation
9-bobdagi KFold vaqt qatoriga yaramaydi: u kelajakni train ga, o'tmishni test ga qo'yadi.
from sklearn.model_selection import TimeSeriesSplit

tss = TimeSeriesSplit(n_splits=5)
print("TimeSeriesSplit — train oynasi o'sib boradi, test har doim keyin keladi:")
print()
print(f"{'burma':>6} {'train':>14} {'test':>14}")
print("-" * 38)
for i, (tr, te) in enumerate(tss.split(X), 1):
    print(f"{i:>6} {f'0..{tr[-1]}':>14} {f'{te[0]}..{te[-1]}':>14}")
print()
xs = [mean_absolute_error(y[te], LinearRegression().fit(X[tr], y[tr]).predict(X[te]))
      for tr, te in tss.split(X)]
print(f"MAE har burmada : {[round(v, 2) for v in xs]}")
print(f"O'rtacha        : {np.mean(xs):.2f}  (+/- {np.std(xs):.2f})")
TimeSeriesSplit — train oynasi o'sib boradi, test har doim keyin keladi:

 burma          train           test
--------------------------------------
     1          0..67        68..131
     2         0..131       132..195
     3         0..195       196..259
     4         0..259       260..323
     5         0..323       324..387

MAE har burmada : [13.75, 11.11, 12.28, 11.82, 12.23]
O'rtacha        : 12.24  (+/- 0.86)
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Lag oyna", "Bitta jumla": "Vaqt qatorini jadvalga aylantirish usuli"},
    {"Tushuncha": "Xronologik split", "Bitta jumla": "Majburiy — tasodifiy split natijani yaxshi ko'rsatadi"},
    {"Tushuncha": "Ekstrapolyatsiya", "Bitta jumla": "Daraxt va KNN train maksimumidan yuqoriga chiqa olmaydi"},
    {"Tushuncha": "Differensiyalash", "Bitta jumla": "Trendni ayirish — model tanlashdan OLDIN qilinadi"},
    {"Tushuncha": "TimeSeriesSplit", "Bitta jumla": "Vaqt qatori uchun KFold o'rnini bosadi"},
    {"Tushuncha": "Vaqt qatori bazasi", "Bitta jumla": "naive va sezonli naive — birinchi raqib"},
    {"Tushuncha": "RNN", "Bitta jumla": "Qadamba-qadam yuradi, yashirin holat saqlaydi"},
    {"Tushuncha": "LSTM darvozalari", "Bitta jumla": "4 barobar parametr; nazariyada uzoq xotira"},
    {"Tushuncha": "Seed tarqoqligi", "Bitta jumla": "O'lchandi: bitta seed yetarli emas, eng yomonini yozing"},
    {"Tushuncha": "Vanishing gradient", "Bitta jumla": "O'lchandi: birinchi qadamga signal deyarli yetmaydi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Lag oyna | Vaqt qatorini jadvalga aylantirish usuli |
| Xronologik split | Majburiy — tasodifiy split natijani yaxshi ko'rsatadi |
| Ekstrapolyatsiya | Daraxt va KNN train maksimumidan yuqoriga chiqa olmaydi |
| Differensiyalash | Trendni ayirish — model tanlashdan OLDIN qilinadi |
| TimeSeriesSplit | Vaqt qatori uchun KFold o'rnini bosadi |
| Vaqt qatori bazasi | naive va sezonli naive — birinchi raqib |
| RNN | Qadamba-qadam yuradi, yashirin holat saqlaydi |
| LSTM darvozalari | 4 barobar parametr; nazariyada uzoq xotira |
| Seed tarqoqligi | O'lchandi: bitta seed yetarli emas, eng yomonini yozing |
| Vanishing gradient | O'lchandi: birinchi qadamga signal deyarli yetmaydi |
Keyingi bobda shu muammoning hozirgi yechimini ko'ramiz: attention. U ketma-ketlik bo'ylab yurmaydi — hamma qadamga bir vaqtda qaraydi.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.