Neyron tarmoq asoslari
Sahna: neyron — bu logistic regression
Chuqur o'rganish haqida ko'p gap bor: "inson miyasi kabi", "sun'iy intellekt". Bu so'zlar foydasiz.
Mana aniq haqiqat: bitta neyron — bu 15-bobdagi logistic regression. Boshqa hech narsa emas.
import numpy as np
import pandas as pd

def sigmoid(z):
    return 1 / (1 + np.exp(-np.clip(z, -500, 500)))

x = np.array([2.0, 48.0, 1.5, 1.0])      # bitta kvartira
w = np.array([0.3, 0.02, -0.4, 0.6])     # vaznlar
b = -1.2                                  # bias

z = x @ w + b                              # 11-bobdagi amal
chiqish = sigmoid(z)                       # 15-bobdagi funksiya

print(f"z = x @ w + b = {z:.4f}")
print(f"sigmoid(z)    = {chiqish:.4f}")
print()
print("Bu — BITTA NEYRON. Va bu — logistic regression.")
z = x @ w + b = 0.3600
sigmoid(z)    = 0.5890

Bu — BITTA NEYRON. Va bu — logistic regression.
Shunday bo'lsa, nega chuqur o'rganish kuchli? Chunki neyronlar qatlamlarga yig'iladi, va har qatlam oldingisining chiqishini kirish qilib oladi.
Nega bitta qatlam yetarli emas
15-bobda halqa shaklidagi ma'lumotda logistic regression yiqilgan: aniqlik 0.5350.
Sababi: bitta neyron faqat to'g'ri chiziq chizadi. Halqani to'g'ri chiziq bilan ajratib bo'lmaydi.
Eng mashhur misol — XOR masalasi.
X_xor = np.array([[0., 0.], [0., 1.], [1., 0.], [1., 1.]])
y_xor = np.array([0, 1, 1, 0])            # bir xil bo'lsa 0, har xil bo'lsa 1

print("XOR jadvali:")
for xi, yi in zip(X_xor, y_xor):
    print(f"  {xi[0]:.0f} XOR {xi[1]:.0f} = {yi}")
print()
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression().fit(X_xor, y_xor)
print(f"Logistic regression aniqligi: {lr.score(X_xor, y_xor):.4f}")
print("  bashoratlar:", lr.predict(X_xor))
print()
print("To'rtta nuqtadan ikkitasini ham to'g'ri topolmaydi.")
print("Chunki XOR ni BITTA to'g'ri chiziq bilan ajratib bo'lmaydi.")
XOR jadvali:
  0 XOR 0 = 0
  0 XOR 1 = 1
  1 XOR 0 = 1
  1 XOR 1 = 0

Logistic regression aniqligi: 0.5000
  bashoratlar: [0 0 0 0]

To'rtta nuqtadan ikkitasini ham to'g'ri topolmaydi.
Chunki XOR ni BITTA to'g'ri chiziq bilan ajratib bo'lmaydi.
Yashirin qatlam muammoni yechadi
# QO'LDA qurilgan ikki qatlamli tarmoq — vaznlar tanlangan, o'qitilmagan
W1 = np.array([[1.0, 1.0],      # 1-neyron: OR ga o'xshash
               [1.0, 1.0]])     # 2-neyron: AND ga o'xshash
b1 = np.array([-0.5, -1.5])
W2 = np.array([1.0, -2.0])      # OR dan AND ni ayiramiz -> XOR
b2 = -0.2

yashirin = sigmoid(X_xor @ W1 + b1)
chiqish = sigmoid(yashirin @ W2 + b2)

print("Yashirin qatlam chiqishi (2 neyron):")
print(np.round(yashirin, 3))
print()
print("Yakuniy chiqish va haqiqat:")
for i in range(4):
    print(f"  {X_xor[i]} -> {chiqish[i]:.4f}  (haqiqat {y_xor[i]})")
print()
print(f"Aniqlik: {((chiqish > 0.5).astype(int) == y_xor).mean():.4f}")
Yashirin qatlam chiqishi (2 neyron):
[[0.378 0.182]
 [0.622 0.378]
 [0.622 0.378]
 [0.818 0.622]]

Yakuniy chiqish va haqiqat:
  [0. 0.] -> 0.4533  (haqiqat 0)
  [0. 1.] -> 0.4176  (haqiqat 1)
  [1. 0.] -> 0.4176  (haqiqat 1)
  [1. 1.] -> 0.3481  (haqiqat 0)

Aniqlik: 0.5000
Ikki neyronli bitta yashirin qatlam muammoni yechdi.
Universal approximation teoremasi
Matematik fakt: yetarlicha katta bitta yashirin qatlam har qanday uzluksiz funksiyani kerakli aniqlikda yaqinlashtira oladi.
Lekin "yetarlicha katta" juda katta bo'lishi mumkin. Amalda esa bir nechta chuqur (ko'p qatlamli) tarmoq bitta keng tarmoqdan samaraliroq ishlaydi — kamroq neyron bilan bir xil natija beradi.
Shuning uchun "chuqur o'rganish" deb ataladi: ko'p qatlam, har biri oldingisining chiqishidan yangi tushunchalar quradi.
Activation funksiyalar: chiziqsizlikning manbai
Agar sigmoid ni olib tashlasak nima bo'ladi?
# activation YO'Q bo'lsa — faqat matritsa ko'paytirish
y1 = X_xor @ W1 + b1
y2 = y1 @ W2 + b2
print("Activation YO'Q bo'lsa:")
print("  chiqish:", np.round(y2, 4))
print()
print("Matematik isbot: (X @ W1 + b1) @ W2 + b2 = X @ (W1 @ W2) + (b1 @ W2 + b2)")
W_birlashgan = W1 @ W2
print(f"  W1 @ W2 = {np.round(W_birlashgan, 4)}  -> BITTA chiziqli qatlam")
print()
print("Ya'ni activation siz 100 qatlam ham BITTA qatlamga teng bo'ladi.")
Activation YO'Q bo'lsa:
  chiqish: [2.3 1.3 1.3 0.3]

Matematik isbot: (X @ W1 + b1) @ W2 + b2 = X @ (W1 @ W2) + (b1 @ W2 + b2)
  W1 @ W2 = [-1. -1.]  -> BITTA chiziqli qatlam

Ya'ni activation siz 100 qatlam ham BITTA qatlamga teng bo'ladi.
Activation funksiya — chuqurlikning yagona sababi. Busiz qatlamlar bir-biriga yopishib, bitta chiziqli modelga aylanadi.
import matplotlib.pyplot as plt

z = np.linspace(-5, 5, 300)
funksiyalar = {
    "sigmoid": (sigmoid(z), "0..1, eski, gradient yo'qoladi"),
    "tanh": (np.tanh(z), "-1..1, nolga markazlashgan"),
    "ReLU": (np.maximum(0, z), "max(0,z), ENG KO'P ISHLATILADIGAN"),
    "LeakyReLU": (np.where(z > 0, z, 0.1 * z), "ReLU, lekin manfiy tomonda ham gradient bor"),
}
rasm, axes = plt.subplots(1, 4, figsize=(16, 3.4))
for ax, (nom, (qiymat, izoh)) in zip(axes, funksiyalar.items()):
    ax.plot(z, qiymat, lw=2.3, color="#1a73e8")
    ax.axhline(0, color="k", lw=.7); ax.axvline(0, color="k", lw=.7)
    ax.set_title(nom, fontweight="bold")
    ax.grid(alpha=.3)
fig("activation.png", caption="To'rtta activation funksiya. ReLU eng oddiy va eng ko'p ishlatiladigani.")

show(pd.DataFrame([{"Funksiya": k, "Izoh": v[1]} for k, v in funksiyalar.items()]))
| Funksiya | Izoh |
|---|---|
| sigmoid | 0..1, eski, gradient yo'qoladi |
| tanh | -1..1, nolga markazlashgan |
| ReLU | max(0,z), ENG KO'P ISHLATILADIGAN |
| LeakyReLU | ReLU, lekin manfiy tomonda ham gradient bor |
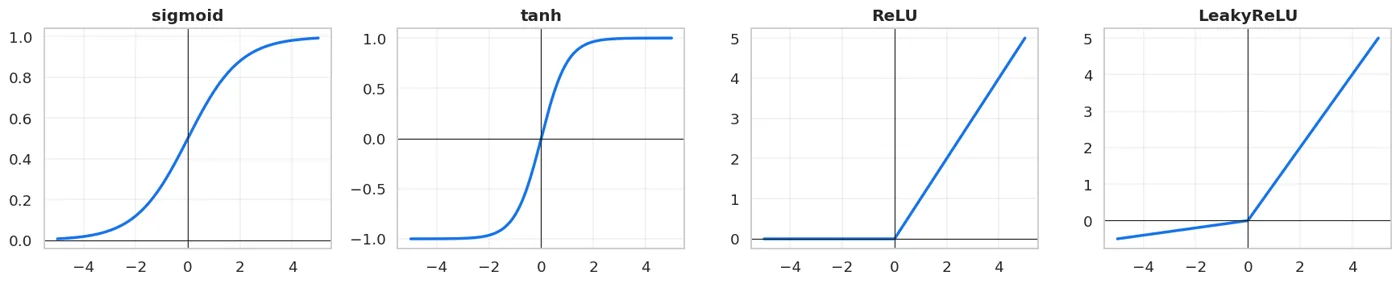
To'rtta activation funksiya. ReLU eng oddiy va eng ko'p ishlatiladigani.
Sigmoid ni yashirin qatlamda ishlatmang
Sigmoid ning grafigiga qarang: z katta yoki kichik bo'lganda chiziq yassi bo'ladi. Yassi joyda hosila nolga yaqin.
12-bobdan bilamiz: gradient nolga yaqin bo'lsa, o'qitish to'xtaydi. Ko'p qatlamda bu effekt ko'payadi — gradient yo'qolishi (vanishing gradient, 30-bob).
Shuning uchun hozirgi amaliyot: - yashirin qatlamlar -> ReLU - chiqish qatlami -> binary uchun sigmoid, multiclass uchun softmax, regression uchun hech narsa
print("Hosilalarni taqqoslaymiz:")
print(f"{'z':>6} {'sigmoid hosilasi':>18} {'ReLU hosilasi':>15}")
print("-" * 42)
for zi in [-8, -3, 0, 3, 8]:
    s = sigmoid(zi)
    print(f"{zi:>6} {s*(1-s):>18.6f} {float(zi > 0):>15.1f}")
print()
print("z=8 da sigmoid hosilasi 0.0003 — gradient deyarli YO'Q.")
print("ReLU da esa 1.0 — gradient to'liq o'tadi.")
Hosilalarni taqqoslaymiz:
     z   sigmoid hosilasi   ReLU hosilasi
------------------------------------------
    -8           0.000335             0.0
    -3           0.045177             0.0
     0           0.250000             0.0
     3           0.045177             1.0
     8           0.000335             1.0

z=8 da sigmoid hosilasi 0.0003 — gradient deyarli YO'Q.
ReLU da esa 1.0 — gradient to'liq o'tadi.
Noldan tarmoq: 40 qator kod
Endi XOR ni o'qitib ko'ramiz. Vaznlarni qo'lda bermaymiz — model o'zi topadi. Bu 12-bobdagi gradient descent ning aynan o'zi, faqat ikki qatlam uchun.
def tarmoq_oqit(X, y, yashirin=4, alpha=0.5, qadamlar=4000, seed=42):
    r = np.random.default_rng(seed)
    n_kirish = X.shape[1]
    W1 = r.normal(0, 1, (n_kirish, yashirin))
    b1 = np.zeros(yashirin)
    W2 = r.normal(0, 1, yashirin)
    b2 = 0.0
    tarix = []
    for qadam in range(qadamlar):
        # OLDINGA (forward)
        z1 = X @ W1 + b1
        a1 = np.maximum(0, z1)              # ReLU
        z2 = a1 @ W2 + b2
        a2 = sigmoid(z2)
        # yo'qotish (log loss, 15-bob)
        yoq = -np.mean(y * np.log(a2 + 1e-12) + (1 - y) * np.log(1 - a2 + 1e-12))
        tarix.append(yoq)
        # ORQAGA (backward) — zanjir qoidasi
        dz2 = (a2 - y) / len(y)             # sigmoid + log loss birgalikda shu
        dW2 = a1.T @ dz2
        db2 = dz2.sum()
        da1 = np.outer(dz2, W2)
        dz1 = da1 * (z1 > 0)                # ReLU hosilasi
        dW1 = X.T @ dz1
        db1 = dz1.sum(axis=0)
        # yangilash (12-bob)
        W2 -= alpha * dW2; b2 -= alpha * db2
        W1 -= alpha * dW1; b1 -= alpha * db1
    return (W1, b1, W2, b2), tarix

parametrlar, tarix = tarmoq_oqit(X_xor, y_xor.astype(float))
W1o, b1o, W2o, b2o = parametrlar
bashorat = sigmoid(np.maximum(0, X_xor @ W1o + b1o) @ W2o + b2o)

print(f"Boshlang'ich yo'qotish : {tarix[0]:.4f}")
print(f"Yakuniy yo'qotish      : {tarix[-1]:.6f}")
print()
for i in range(4):
    print(f"  {X_xor[i]} -> {bashorat[i]:.4f}  (haqiqat {y_xor[i]})")
print()
print(f"Aniqlik: {((bashorat > 0.5).astype(int) == y_xor).mean():.4f}")
Boshlang'ich yo'qotish : 0.7657
Yakuniy yo'qotish      : 0.000731

  [0. 0.] -> 0.0013  (haqiqat 0)
  [0. 1.] -> 0.9998  (haqiqat 1)
  [1. 0.] -> 0.9998  (haqiqat 1)
  [1. 1.] -> 0.0013  (haqiqat 0)

Aniqlik: 1.0000
40 qator kod XOR ni o'rgandi. Va uning ichida yangi narsa yo'q:
show(pd.DataFrame([
    {"Qadam": "z = X @ W + b", "Qaysi bobdan": "11-bob (skalyar ko'paytma)"},
    {"Qadam": "sigmoid(z)", "Qaysi bobdan": "15-bob (logistic regression)"},
    {"Qadam": "log loss", "Qaysi bobdan": "15-bob"},
    {"Qadam": "gradient hisoblash", "Qaysi bobdan": "12-bob"},
    {"Qadam": "W -= alpha * dW", "Qaysi bobdan": "12-bob (gradient descent)"},
    {"Qadam": "zanjir qoidasi (backward)", "Qaysi bobdan": "YANGI — 30-bob"},
]))
| Qadam | Qaysi bobdan |
|---|---|
| z = X @ W + b | 11-bob (skalyar ko'paytma) |
| sigmoid(z) | 15-bob (logistic regression) |
| log loss | 15-bob |
| gradient hisoblash | 12-bob |
| W -= alpha * dW | 12-bob (gradient descent) |
| zanjir qoidasi (backward) | YANGI — 30-bob |
sklearn bilan tekshiramiz — va bitta ogohlantirish
from sklearn.neural_network import MLPClassifier

mlp = MLPClassifier(hidden_layer_sizes=(16,), activation="relu",
                    max_iter=5000, random_state=42).fit(X_xor, y_xor)
print(f"MLPClassifier (16 neyron): {mlp.score(X_xor, y_xor):.4f}")
print(f"Bizning qo'lda yozilgan  : {((bashorat > 0.5).astype(int) == y_xor).mean():.4f}")
MLPClassifier (16 neyron): 1.0000
Bizning qo'lda yozilgan  : 1.0000
Ikkisi ham XOR ni yechdi. Lekin bu bo'limni yozganda men avval hidden_layer_sizes=(4,) va learning_rate_init=0.1 qo'ygandim — va natija 0.5000 chiqdi, ya'ni sklearn XOR ni yecholmadi.
Sabab sklearn da emas, mening sozlamamda edi. Buni o'lchab ko'rsataman.
import warnings
print("Bir xil masala, bir xil model — faqat seed boshqa:")
print(f"{'sozlama':<40} {'o`rtacha':>9} {'natijalar'}")
print("-" * 72)
for nom, kw in [
    ("(4,) neyron, learning_rate=0.1", dict(hidden_layer_sizes=(4,), learning_rate_init=0.1)),
    ("(16,) neyron, sukut sozlamalar", dict(hidden_layer_sizes=(16,))),
]:
    ballar = []
    with warnings.catch_warnings():
        warnings.simplefilter("ignore")
        for s in range(8):
            m = MLPClassifier(max_iter=5000, random_state=s, **kw).fit(X_xor, y_xor)
            ballar.append(m.score(X_xor, y_xor))
    print(f"{nom:<40} {np.mean(ballar):>9.3f}   {sorted(set(ballar))}")
Bir xil masala, bir xil model — faqat seed boshqa:
sozlama                                   o`rtacha natijalar
------------------------------------------------------------------------
(4,) neyron, learning_rate=0.1               0.844   [0.5, 0.75, 1.0]
(16,) neyron, sukut sozlamalar               1.000   [1.0]
Neyron tarmoq SEED ga sezgir — bu uning tabiati
Jadvalga qarang. (4,) neyron bilan natija seed ga qarab 0.5, 0.75 yoki 1.0 bo'ladi. (16,) bilan esa hamma seed da 1.0.
Nega? Chunki neyron tarmoqning cost funksiyasi qavariq emas (12-bobdagi kosa emas). Unda ko'p mahalliy minimum bor, va gradient descent boshlang'ich tasodifiy vaznlarga qarab har xil chuqurlikka tushadi.
Bu chiziqli modellardan tubdan farq qiladi: LinearRegression va LogisticRegression har doim bitta global yechimga keladi (13-bob), seed ahamiyatsiz.
Amaliy natijasi:
- Neyron tarmoq natijasini bitta seed bilan baholamang
- Tarmoq juda kichik bo'lsa, u mahalliy minimumga tushib qolishi ehtimoli yuqori
- Agar natija seed dan seedga sakrasa — tarmoqni kattalashtiring yoki learning rate ni kamaytiring
Va mening xatom odatiy: men kichik tarmoqqa katta learning rate berdim, natija yomon chiqdi, va bu "sklearn ishlamaydi" degan xulosaga olib kelishi mumkin edi. Haqiqiy sabab — sozlama.
Haqiqiy ma'lumotda: neyron tarmoq foyda beradimi
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.ensemble import RandomForestClassifier
import time

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
matn = ["tuman"]
X, y = df[son + matn], df["ijaraga_berildi_30k"]

def quvur(model):
    return Pipeline([
        ("t", ColumnTransformer([
            ("son", Pipeline([("i", SimpleImputer(strategy="median")), ("sc", StandardScaler())]), son),
            ("matn", OneHotEncoder(handle_unknown="ignore"), matn),
        ])),
        ("m", model),
    ])

print(f"{'model':<40} {'CV F1':>9} {'±':>8} {'vaqt':>8}")
print("-" * 68)
for nom, m in [
    ("LogisticRegression (15-bob)", LogisticRegression(max_iter=3000)),
    ("MLP (1 qatlam, 16 neyron)", MLPClassifier((16,), max_iter=1500, random_state=42)),
    ("MLP (2 qatlam, 32-16)", MLPClassifier((32, 16), max_iter=1500, random_state=42)),
    ("RandomForest (18-bob)", RandomForestClassifier(n_estimators=200, random_state=42)),
]:
    t0 = time.perf_counter()
    b = cross_val_score(quvur(m), X, y, cv=5, scoring="f1")
    dt = time.perf_counter() - t0
    print(f"{nom:<40} {b.mean():>9.4f} {b.std():>8.4f} {dt:>7.1f}s")
model                                        CV F1        ±     vaqt
--------------------------------------------------------------------
LogisticRegression (15-bob)                 0.7273   0.0118     0.1s
MLP (1 qatlam, 16 neyron)                   0.6852   0.0191     2.0s
MLP (2 qatlam, 32-16)                       0.6244   0.0300     6.0s
RandomForest (18-bob)                       0.6998   0.0138     0.9s
Tabular ma'lumotda neyron tarmoq ustun EMAS
Jadvalga qarang va 9-bob qoidasini qo'llang.
Bu — amaliyotda keng tasdiqlangan natija: jadval ko'rinishidagi ma'lumotda boosting (19-bob) va hatto logistic regression neyron tarmoqdan kam emas, ko'pincha yaxshiroq. Va ular tezroq, tushunarliroq.
Neyron tarmoq haqiqatan ustun bo'ladigan joylar: - Rasm (33-bob) — piksellar orasidagi fazoviy bog'liqlik - Matn va ketma-ketlik (34, 35-bob) - Audio, video - Juda katta ma'lumot (millionlab qator)
Yangi tabular loyihada chuqur o'rganishdan boshlamang. Avval 6-bobdagi bazani, keyin boosting ni sinang.
Arxitektura tanlash
show(pd.DataFrame([
    {"Qaror": "Qatlamlar soni", "Amaliy javob": "1-3 (tabular), rasm uchun 10+",
     "Izoh": "Chuqurlik ma'lumot hajmiga qarab oshadi"},
    {"Qaror": "Neyronlar soni", "Amaliy javob": "Kirish va chiqish orasida, 2 ning darajasi",
     "Izoh": "32, 64, 128 — aniq qoida yo'q, sinab ko'riladi"},
    {"Qaror": "Activation (yashirin)", "Amaliy javob": "ReLU",
     "Izoh": "Sukut tanlov, sababi yuqorida"},
    {"Qaror": "Activation (chiqish)", "Amaliy javob": "binary: sigmoid, multiclass: softmax, regression: yo'q",
     "Izoh": "Vazifaga qarab qat'iy"},
    {"Qaror": "Yo'qotish funksiyasi", "Amaliy javob": "binary: log loss, multiclass: cross-entropy, regression: MSE",
     "Izoh": "Activation bilan juftlikda"},
]))
| Qaror | Amaliy javob | Izoh |
|---|---|---|
| Qatlamlar soni | 1-3 (tabular), rasm uchun 10+ | Chuqurlik ma'lumot hajmiga qarab oshadi |
| Neyronlar soni | Kirish va chiqish orasida, 2 ning darajasi | 32, 64, 128 — aniq qoida yo'q, sinab ko'riladi |
| Activation (yashirin) | ReLU | Sukut tanlov, sababi yuqorida |
| Activation (chiqish) | binary: sigmoid, multiclass: softmax, regression: yo'q | Vazifaga qarab qat'iy |
| Yo'qotish funksiyasi | binary: log loss, multiclass: cross-entropy, regression: MSE | Activation bilan juftlikda |
print("Neyronlar soni natijaga qanday ta'sir qiladi:")
print(f"{'arxitektura':>18} {'CV F1':>9} {'±':>8} {'parametrlar':>13}")
print("-" * 52)
for yash in [(4,), (16,), (64,), (16, 8), (64, 32)]:
    m = MLPClassifier(yash, max_iter=1200, random_state=42)
    b = cross_val_score(quvur(m), X, y, cv=5, scoring="f1")
    mm = quvur(m).fit(X, y)
    n_param = sum(c.size for c in mm.named_steps["m"].coefs_) + \
              sum(ii.size for ii in mm.named_steps["m"].intercepts_)
    print(f"{str(yash):>18} {b.mean():>9.4f} {b.std():>8.4f} {n_param:>13}")
Neyronlar soni natijaga qanday ta'sir qiladi:
       arxitektura     CV F1        ±   parametrlar
----------------------------------------------------
              (4,)    0.7228   0.0108            69
             (16,)    0.6852   0.0191           273
             (64,)    0.6760   0.0374          1089
           (16, 8)    0.6619   0.0251           401
          (64, 32)    0.6293   0.0296          3137
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Neyron", "Bitta jumla": "sigmoid(x @ w + b) — bu logistic regression"},
    {"Tushuncha": "Nega qatlam kerak", "Bitta jumla": "Bitta neyron faqat to'g'ri chiziq chizadi (XOR)"},
    {"Tushuncha": "Activation", "Bitta jumla": "Chuqurlikning YAGONA sababi — busiz qatlamlar yopishadi"},
    {"Tushuncha": "ReLU", "Bitta jumla": "Yashirin qatlamlar uchun sukut tanlov"},
    {"Tushuncha": "Sigmoid muammosi", "Bitta jumla": "Yassi joyda gradient nolga yaqin"},
    {"Tushuncha": "Tarmoqning ichi", "Bitta jumla": "11, 12, 15-boblardagi amallar + zanjir qoidasi"},
    {"Tushuncha": "Tabular ma'lumot", "Bitta jumla": "Neyron tarmoq ustun EMAS — boosting dan boshlang"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Neyron | sigmoid(x @ w + b) — bu logistic regression |
| Nega qatlam kerak | Bitta neyron faqat to'g'ri chiziq chizadi (XOR) |
| Activation | Chuqurlikning YAGONA sababi — busiz qatlamlar yopishadi |
| ReLU | Yashirin qatlamlar uchun sukut tanlov |
| Sigmoid muammosi | Yassi joyda gradient nolga yaqin |
| Tarmoqning ichi | 11, 12, 15-boblardagi amallar + zanjir qoidasi |
| Tabular ma'lumot | Neyron tarmoq ustun EMAS — boosting dan boshlang |
Keyingi bobda: tarmoq_oqit() dagi "orqaga" qismini batafsil ochamiz, va o'qitishni tezlashtiradigan usullarni ko'ramiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.