Clustering: K-Means, DBSCAN, hierarchical
Sahna: "mijozlarimizni guruhlarga bo'l"
Marketing bo'limi keladi: "Bizda 1200 e'lon bor. Ularni guruhlarga bo'l — har guruhga boshqa reklama yozamiz."
Qanday guruhlar? Ular bilmaydi. Yorliq yo'q. Siz topishingiz kerak.
Bu — clustering. Va u supervised learning dan tubdan farq qiladi: to'g'ri javob yo'q.
Clustering da "aniqlik" degan narsa yo'q
7-bobda accuracy bor edi, chunki haqiqat ma'lum edi. Bu yerda haqiqat yo'q.
Shuning uchun clustering natijasini baholash — eng qiyin qism. Va eng ko'p o'tkazib yuboriladigan.
K-Means: eng ko'p ishlatiladigan usul
G'oya uch qadamda:
Kta tasodifiy markaz tashla- Har nuqtani eng yaqin markazga biriktir
- Markazlarni o'z guruhining o'rtachasiga ko'chir, 2-qadamga qayt
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
X = SimpleImputer(strategy="median").fit_transform(df[son])
Xs = StandardScaler().fit_transform(X)

km = KMeans(n_clusters=4, n_init=10, random_state=42).fit(Xs)
print(f"Guruhlar: {np.bincount(km.labels_)}")
print(f"Iteratsiyalar: {km.n_iter_}")
print(f"Inertia (guruh ichidagi tarqalish): {km.inertia_:.1f}")
Guruhlar: [318 274 313 295]
Iteratsiyalar: 36
Inertia (guruh ichidagi tarqalish): 5304.0
Algoritmni qo'lda ham yozish mumkin — u shunchalik oddiy:
def qolda_kmeans(X, k=4, qadamlar=20, seed=42):
    r = np.random.default_rng(seed)
    markaz = X[r.choice(len(X), k, replace=False)]
    for _ in range(qadamlar):
        masofa = ((X[:, None, :] - markaz[None, :, :]) ** 2).sum(axis=2)
        yorliq = masofa.argmin(axis=1)
        yangi = np.array([X[yorliq == j].mean(axis=0) if (yorliq == j).any() else markaz[j]
                          for j in range(k)])
        if np.allclose(yangi, markaz):
            break
        markaz = yangi
    inertia = sum(((X[yorliq == j] - markaz[j]) ** 2).sum() for j in range(k))
    return yorliq, markaz, inertia

y_q, m_q, in_q = qolda_kmeans(Xs, k=4)
print(f"Qo'lda yozilgan inertia : {in_q:.1f}")
print(f"sklearn inertia         : {km.inertia_:.1f}")
print(f"Guruh hajmlari (qo'lda) : {np.bincount(y_q)}")
Qo'lda yozilgan inertia : 5319.0
sklearn inertia         : 5304.0
Guruh hajmlari (qo'lda) : [294 370 257 279]
Nechta guruh? Elbow usuli
K ni siz tanlaysiz. Model aytmaydi.
inertia = []
K_lar = range(1, 11)
for k in K_lar:
    inertia.append(KMeans(n_clusters=k, n_init=10, random_state=42).fit(Xs).inertia_)

jadval = pd.DataFrame({"K": list(K_lar), "inertia": [round(i, 1) for i in inertia]})
jadval["kamayish"] = [None] + [round(inertia[i-1] - inertia[i], 1) for i in range(1, len(inertia))]
show(jadval)
| K | inertia | kamayish |
|---|---|---|
| 1 | 8 400 | NaN |
| 2 | 6 754.1 | 1 645.9 |
| 3 | 5 866.8 | 887.3 |
| 4 | 5 304 | 562.8 |
| 5 | 4 918.6 | 385.4 |
| 6 | 4 599.5 | 319.1 |
| 7 | 4 344.3 | 255.2 |
| 8 | 4 109.1 | 235.3 |
| 9 | 3 914.2 | 194.9 |
| 10 | 3 739.9 | 174.3 |
from sklearn.metrics import silhouette_score

sil = []
for k in range(2, 11):
    yl = KMeans(n_clusters=k, n_init=10, random_state=42).fit_predict(Xs)
    sil.append(silhouette_score(Xs, yl))

rasm, axes = plt.subplots(1, 2, figsize=(13.5, 4.5))
axes[0].plot(list(K_lar), inertia, "o-", lw=2, color="#1a73e8")
axes[0].set_xlabel("K (guruhlar soni)"); axes[0].set_ylabel("Inertia")
axes[0].set_title("Elbow usuli — 'tirsak' qidiriladi", fontweight="bold")
axes[0].grid(alpha=.3)

axes[1].plot(range(2, 11), sil, "o-", lw=2, color="#137333")
eng_k = int(np.argmax(sil)) + 2
axes[1].axvline(eng_k, ls="--", color="red", lw=1.2, label=f"eng baland: K={eng_k}")
axes[1].set_xlabel("K"); axes[1].set_ylabel("Silhouette ball")
axes[1].set_title("Silhouette — aniqroq mezon", fontweight="bold")
axes[1].legend(); axes[1].grid(alpha=.3)
fig("elbow.png", caption="Chapda elbow — 'tirsak' ko'zga ko'rinmasligi mumkin. O'ngda silhouette — maksimal nuqta aniqroq.")

print(f"{'K':>4} {'silhouette':>12}")
print("-" * 18)
for k, s in zip(range(2, 11), sil):
    belgi = "  <-- eng baland" if k == eng_k else ""
    print(f"{k:>4} {s:>12.4f}{belgi}")
   K   silhouette
------------------
   2       0.1797  <-- eng baland
   3       0.1645
   4       0.1632
   5       0.1658
   6       0.1591
   7       0.1590
   8       0.1610
   9       0.1642
  10       0.1652
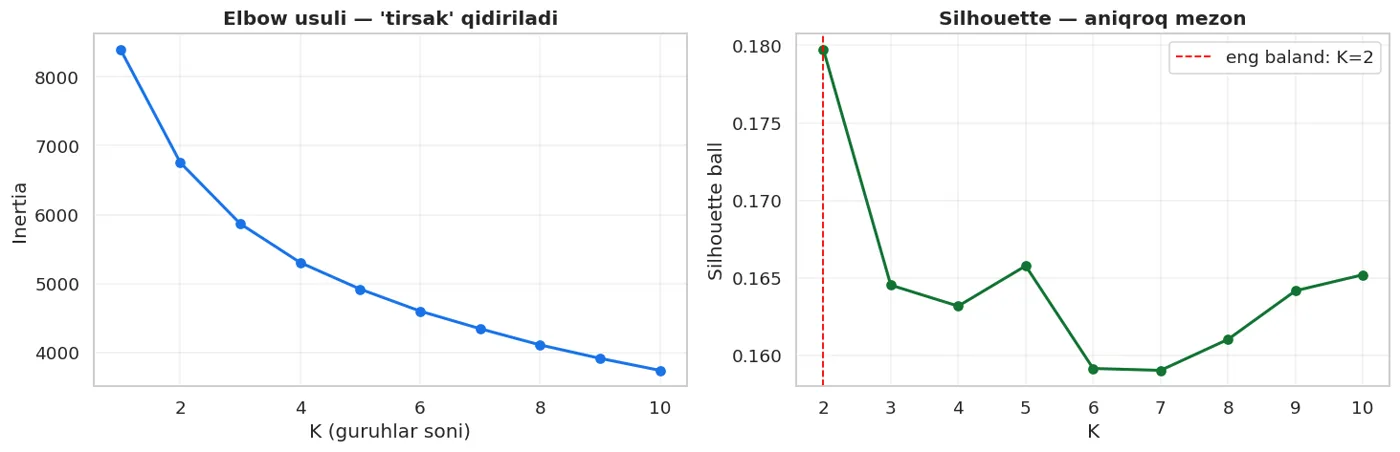
Chapda elbow — 'tirsak' ko'zga ko'rinmasligi mumkin. O'ngda silhouette — maksimal nuqta aniqroq.
Elbow ko'pincha tirsak ko'rsatmaydi
Darsliklarda elbow grafigi chiroyli burchak bilan chiziladi. Haqiqiy ma'lumotda esa egri chiziq silliq bo'ladi va "tirsak" qayerda ekanini aytib bo'lmaydi.
Yuqoridagi grafik ham shunday. Shuning uchun amalda silhouette ishlatiladi: u aniq maksimumga ega.
Lekin eng ishonchli mezon boshqa: guruhlarni ochib o'qish. Agar guruhlar biznes ma'nosiga ega bo'lmasa, silhouette qancha baland bo'lsa ham foydasiz.
Silhouette nimani o'lchaydi
print("Silhouette har bir nuqta uchun hisoblanadi:")
print("  a = o'z guruhidagi nuqtalarga o'rtacha masofa")
print("  b = eng yaqin BOSHQA guruhgacha o'rtacha masofa")
print("  silhouette = (b - a) / max(a, b)")
print()
show(pd.DataFrame([
    {"Qiymat": "+1 ga yaqin", "Ma'nosi": "Nuqta o'z guruhida mahkam, boshqalardan uzoq"},
    {"Qiymat": "0 atrofida", "Ma'nosi": "Ikki guruh chegarasida turibdi"},
    {"Qiymat": "manfiy", "Ma'nosi": "Noto'g'ri guruhga tushgan"},
]))
Silhouette har bir nuqta uchun hisoblanadi:
  a = o'z guruhidagi nuqtalarga o'rtacha masofa
  b = eng yaqin BOSHQA guruhgacha o'rtacha masofa
  silhouette = (b - a) / max(a, b)
| Qiymat | Ma'nosi |
|---|---|
| +1 ga yaqin | Nuqta o'z guruhida mahkam, boshqalardan uzoq |
| 0 atrofida | Ikki guruh chegarasida turibdi |
| manfiy | Noto'g'ri guruhga tushgan |
from sklearn.metrics import silhouette_samples
km_eng = KMeans(n_clusters=eng_k, n_init=10, random_state=42).fit(Xs)  # eng_k — silhouette eng baland bo'lgan K
namunalar = silhouette_samples(Xs, km_eng.labels_)
tah = pd.DataFrame({"guruh": km_eng.labels_, "silhouette": namunalar})
g = tah.groupby("guruh").silhouette.agg(["size", "mean", "min"]).round(4)
g.columns = ["qatorlar", "o'rtacha sil", "eng past sil"]
show(g.reset_index())
print()
print(f"Manfiy silhouette li qatorlar: {int((namunalar < 0).sum())} / {len(namunalar)}")
Manfiy silhouette li qatorlar: 5 / 1200
| guruh | qatorlar | o'rtacha sil | eng past sil |
|---|---|---|---|
| 0 | 564 | 0.16 | -0.013 |
| 1 | 636 | 0.198 | 0.015 |
Guruhlarni O'QISH — eng muhim qadam
Raqamlar yetarli emas. Guruhlar nimani anglatadi?
natija = df[son].copy()
natija["guruh"] = km_eng.labels_
xulosa = natija.groupby("guruh").agg({
    "xonalar": "mean", "maydon_m2": "mean", "metro_km": "mean",
    "mebel": "mean", "qurilgan_yil": "mean",
}).round(2)
xulosa["qatorlar"] = natija.groupby("guruh").size()
show(xulosa.reset_index())
print()
print("Qo'shimcha: guruhlar narx va tez ketish bo'yicha farq qiladimi?")
tekshir = df.assign(guruh=km_eng.labels_).groupby("guruh").agg({
    "narx_usd": "mean", "ijaraga_berildi_30k": "mean"}).round(3)
show(tekshir.reset_index())
Qo'shimcha: guruhlar narx va tez ketish bo'yicha farq qiladimi?
| guruh | xonalar | maydon_m2 | metro_km | mebel | qurilgan_yil | qatorlar |
|---|---|---|---|---|---|---|
| 0 | 3.48 | 74.36 | 2.69 | 0.6 | 1 999.24 | 564 |
| 1 | 1.65 | 41.96 | 2.5 | 0.62 | 1 998.7 | 636 |
| guruh | narx_usd | ijaraga_berildi_30k |
|---|---|---|
| 0 | 955.922 | 0.271 |
| 1 | 616.635 | 0.715 |
Guruhlar o'rtachalari bir-biridan farq qiladi, demak nom berish mumkin: "kichik arzon kvartiralar", "markazdagi mebelli" va shunga o'xshash.
Lekin bu yerda to'xtab, halol baho berishim kerak.
Silhouette ballariga qaraylik: eng baland qiymat 0.1797 (K=2 da), K=4 da esa 0.1632. Bu — past ballar.
show(pd.DataFrame([
    {"Silhouette": "0.70 dan yuqori", "Ma'nosi": "Kuchli, aniq ajralgan guruhlar"},
    {"Silhouette": "0.50 - 0.70", "Ma'nosi": "Ishonchli tuzilma"},
    {"Silhouette": "0.25 - 0.50", "Ma'nosi": "Kuchsiz tuzilma — ehtiyot bo'ling"},
    {"Silhouette": "0.25 dan past", "Ma'nosi": "Tabiiy guruh YO'Q deb hisoblanadi"},
]))
| Silhouette | Ma'nosi |
|---|---|
| 0.70 dan yuqori | Kuchli, aniq ajralgan guruhlar |
| 0.50 - 0.70 | Ishonchli tuzilma |
| 0.25 - 0.50 | Kuchsiz tuzilma — ehtiyot bo'ling |
| 0.25 dan past | Tabiiy guruh YO'Q deb hisoblanadi |
Bizning ball 0.18 — oxirgi qatorga tushadi.
Xulosa: bu ma'lumotda aniq tabiiy guruhlar yo'q. K-Means baribir 4 guruh chizdi — chunki undan shuni so'radik, va u har qanday ma'lumotni K ta bo'lakka bo'laveradi. Ballar esa bu bo'lish sun'iy ekanini aytadi.
Marketing bo'limiga aytiladigan halol javob shunday:
"Ma'lumotda tabiiy segmentlar topilmadi. Agar segmentatsiya kerak bo'lsa, uni biznes qoidasi bilan qo'ying (masalan narx bo'yicha uchga bo'lish) — bu clustering dan ishonchliroq bo'ladi."
K-Means HAR DOIM natija qaytaradi — hatto guruh yo'q bo'lsa ham
Bu — clustering dagi eng xavfli xususiyat. KMeans(n_clusters=4) hech qachon "guruh topilmadi" demaydi. U har qanday ma'lumotni to'rtga bo'ladi, hatto u bir tekis tasodifiy bulut bo'lsa ham.
Shuning uchun silhouette ni har doim hisoblang va uni hisobotga yozing. Busiz siz tasodifiy bo'linishni "mijoz segmentlari" deb taqdim etishingiz mumkin.
Isbot uchun: tasodifiy shovqinda ham K-Means guruh "topadi" — pastda shuni o'lchaymiz va o'z natijamiz bilan solishtiramiz.
r_sh = np.random.default_rng(1)
shovqin_data = r_sh.normal(size=(1200, 7))      # BUTUNLAY tasodifiy
km_sh = KMeans(n_clusters=4, n_init=10, random_state=42).fit(shovqin_data)
print("BUTUNLAY TASODIFIY ma'lumotda K-Means:")
print(f"  guruh hajmlari : {np.bincount(km_sh.labels_)}")
print(f"  silhouette     : {silhouette_score(shovqin_data, km_sh.labels_):.4f}")
print()
print(f"Bizning haqiqiy ma'lumotda (K={eng_k}): {silhouette_score(Xs, km_eng.labels_):.4f}")
print()
nisbat = silhouette_score(Xs, km_eng.labels_) / silhouette_score(shovqin_data, km_sh.labels_)
print(f"Nisbat: bizning ball tasodifdan {nisbat:.1f} barobar yuqori")
BUTUNLAY TASODIFIY ma'lumotda K-Means:
  guruh hajmlari : [277 306 305 312]
  silhouette     : 0.0961

Bizning haqiqiy ma'lumotda (K=2): 0.1797

Nisbat: bizning ball tasodifdan 1.9 barobar yuqori
Guruhga nom bermaguncha ish tugamagan
Agar guruhga ikki so'z bilan nom berolmasangiz, demak u guruh emas — tasodifiy to'plam.
Shuning uchun ketma-ketlik: K ni tanlash -> guruhlarni o'qish -> nom berish -> nom berib bo'lmasa K ni o'zgartirish.
K-Means ning cheklovlari
from sklearn.datasets import make_moons, make_blobs

r = np.random.default_rng(42)
# 1) yarim oy shakli
X_oy, y_oy = make_moons(n_samples=400, noise=.06, random_state=42)
# 2) har xil hajmdagi guruhlar
X_h, y_h = make_blobs(n_samples=[400, 60, 60], centers=[[0,0],[4,4],[-4,4]],
                      cluster_std=[1.4, .4, .4], random_state=42)

rasm, axes = plt.subplots(2, 2, figsize=(12, 8))
for j, (Xd, nom) in enumerate([(X_oy, "Yarim oy"), (X_h, "Har xil hajm")]):
    Xd_s = StandardScaler().fit_transform(Xd)
    km_t = KMeans(n_clusters=2 if j == 0 else 3, n_init=10, random_state=42).fit_predict(Xd_s)
    axes[j, 0].scatter(Xd[:, 0], Xd[:, 1], c=km_t, cmap="viridis", s=18, alpha=.8)
    axes[j, 0].set_title(f"{nom}: K-Means", fontweight="bold")
    from sklearn.cluster import DBSCAN
    db_t = DBSCAN(eps=.3 if j == 0 else .5, min_samples=5).fit_predict(Xd_s)
    axes[j, 1].scatter(Xd[:, 0], Xd[:, 1], c=db_t, cmap="viridis", s=18, alpha=.8)
    axes[j, 1].set_title(f"{nom}: DBSCAN", fontweight="bold")
    for a in axes[j]: a.grid(alpha=.3)
fig("kmeans_cheklov.png", caption="K-Means doira shaklidagi, teng hajmli guruhlarni kutadi. DBSCAN esa har qanday shaklni topadi.")
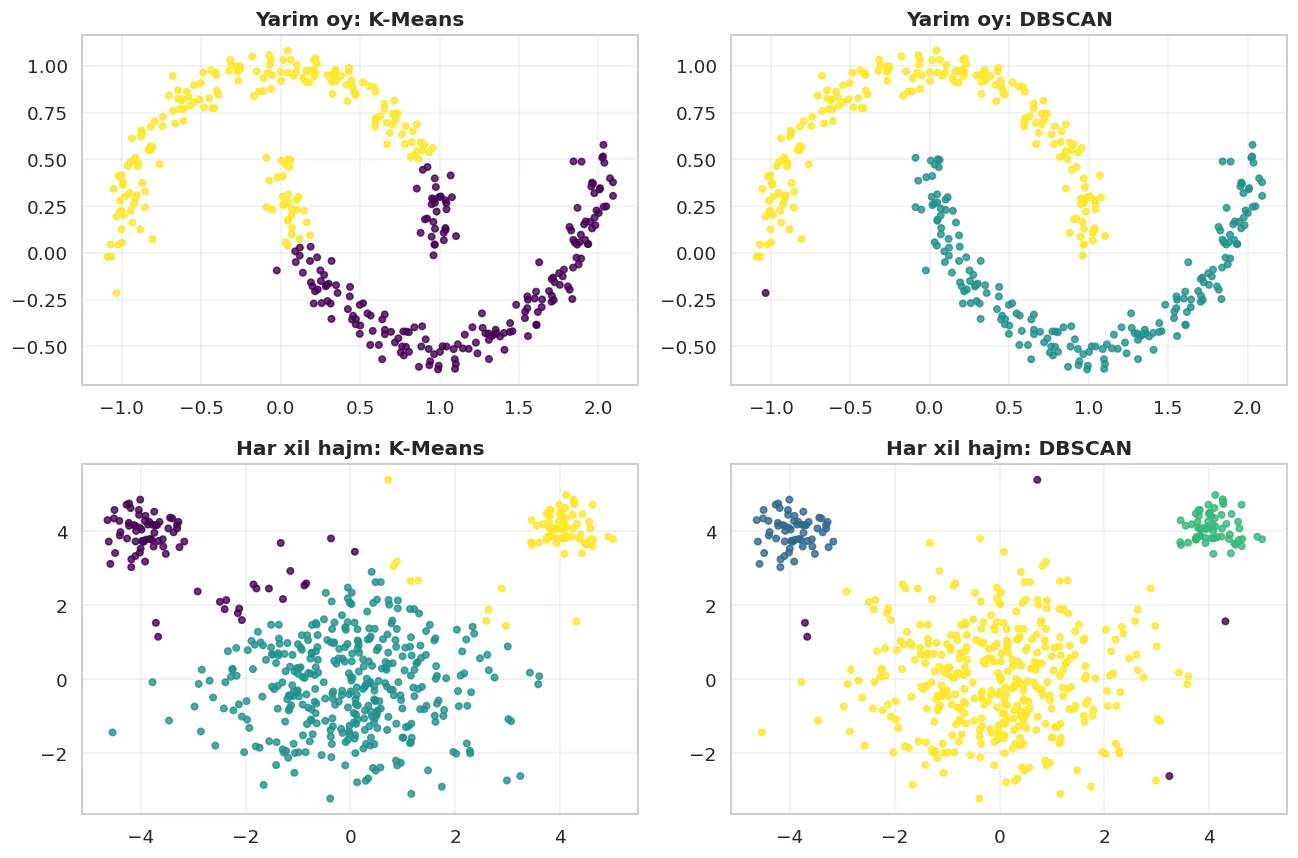
K-Means doira shaklidagi, teng hajmli guruhlarni kutadi. DBSCAN esa har qanday shaklni topadi.
show(pd.DataFrame([
    {"Cheklov": "Doira shaklini kutadi", "Oqibati": "Yarim oy yoki halqani bo'lolmaydi"},
    {"Cheklov": "K ni siz berasiz", "Oqibati": "Noto'g'ri K -> ma'nosiz guruhlar"},
    {"Cheklov": "Teng hajm kutadi", "Oqibati": "Kichik guruhni kattaning ichiga qo'shadi"},
    {"Cheklov": "Chetki qiymatga sezgir", "Oqibati": "Bitta uzoq nuqta markazni tortadi"},
    {"Cheklov": "Boshlang'ich markazga bog'liq", "Oqibati": "n_init=10 shu uchun kerak"},
]))
| Cheklov | Oqibati |
|---|---|
| Doira shaklini kutadi | Yarim oy yoki halqani bo'lolmaydi |
| K ni siz berasiz | Noto'g'ri K -> ma'nosiz guruhlar |
| Teng hajm kutadi | Kichik guruhni kattaning ichiga qo'shadi |
| Chetki qiymatga sezgir | Bitta uzoq nuqta markazni tortadi |
| Boshlang'ich markazga bog'liq | n_init=10 shu uchun kerak |
print("Boshlang'ich markaz ta'siri — n_init ning roli:")
print(f"{'n_init':>8} {'inertia':>12} {'turli natijalar soni':>22}")
print("-" * 46)
for ni in [1, 3, 10]:
    natijalar = set()
    inertialar = []
    for seed in range(8):
        k_t = KMeans(n_clusters=4, n_init=ni, random_state=seed).fit(Xs)
        inertialar.append(round(k_t.inertia_, 1))
        natijalar.add(round(k_t.inertia_, 1))
    print(f"{ni:>8} {np.mean(inertialar):>12.1f} {len(natijalar):>22}")
Boshlang'ich markaz ta'siri — n_init ning roli:
  n_init      inertia   turli natijalar soni
----------------------------------------------
       1       5377.9                      8
       3       5304.7                      6
      10       5304.1                      3
n_init=1 bo'lsa, turli seed turli natija beradi. n_init=10 esa 10 marta urinib eng yaxshisini tanlaydi — shuning uchun u sukut bo'yicha yoqilgan.
DBSCAN: zichlikka asoslangan
DBSCAN boshqa savol beradi: "bu nuqta atrofida yetarlicha qo'shni bormi?"
from sklearn.cluster import DBSCAN

print(f"{'eps':>6} {'min_samples':>12} {'guruhlar':>10} {'shovqin':>9} {'silhouette':>12}")
print("-" * 54)
for eps in [0.5, 0.8, 1.2, 1.8]:
    db = DBSCAN(eps=eps, min_samples=10).fit(Xs)
    n_guruh = len(set(db.labels_)) - (1 if -1 in db.labels_ else 0)
    shovqin = int((db.labels_ == -1).sum())
    if n_guruh > 1:
        mask = db.labels_ != -1
        s = silhouette_score(Xs[mask], db.labels_[mask]) if mask.sum() > n_guruh else float("nan")
    else:
        s = float("nan")
    print(f"{eps:>6} {10:>12} {n_guruh:>10} {shovqin:>9} {s:>12.4f}")
   eps  min_samples   guruhlar   shovqin   silhouette
------------------------------------------------------
   0.5           10          0      1200          nan
   0.8           10          2      1180       0.6764
   1.2           10          3       324       0.1449
   1.8           10          2         7       0.1634
DBSCAN ning ikki afzalligi bor:
Kni bermaysiz — u guruhlar sonini o'zi topadi- Shovqinni ajratadi — hech bir guruhga tushmagan nuqtalar
-1yorlig'ini oladi
Lekin narxi ham bor: eps ni tanlash K ni tanlashdan oson emas.
DBSCAN yuqori o'lchovda ishlamaydi
DBSCAN masofaga tayanadi, shuning uchun 20-bobdagi o'lchov la'nati unga to'liq ta'sir qiladi.
Ustunlar 10-15 dan oshsa, eps ni topish deyarli imkonsiz bo'ladi: hamma nuqta bir xil uzoqlikda ko'rinadi.
Shuning uchun amalda tartib: avval PCA (26-bob) bilan 2-10 o'lchovga tushiring, keyin DBSCAN.
Hierarchical: daraxt ko'rinishida
from sklearn.cluster import AgglomerativeClustering
from scipy.cluster.hierarchy import dendrogram, linkage

namuna = Xs[np.random.default_rng(42).choice(len(Xs), 60, replace=False)]
Z = linkage(namuna, method="ward")

rasm, ax = plt.subplots(figsize=(11, 4.5))
dendrogram(Z, ax=ax, no_labels=True, color_threshold=7)
ax.set_xlabel("Namunalar"); ax.set_ylabel("Birlashish masofasi")
ax.set_title("Dendrogramma — guruhlar qanday birlashadi", fontweight="bold")
fig("dendrogram.png", caption="Pastdan yuqoriga: har nuqta o'z guruhida boshlanadi, keyin bosqichma-bosqich birlashadi. Gorizontal kesim K ni beradi.")

print(f"{'K':>4} {'silhouette (ward)':>20}")
print("-" * 26)
for k in [2, 3, 4, 5, 6]:
    yl = AgglomerativeClustering(n_clusters=k, linkage="ward").fit_predict(Xs)
    print(f"{k:>4} {silhouette_score(Xs, yl):>20.4f}")
   K    silhouette (ward)
--------------------------
   2               0.1356
   3               0.1465
   4               0.1144
   5               0.1143
   6               0.1114
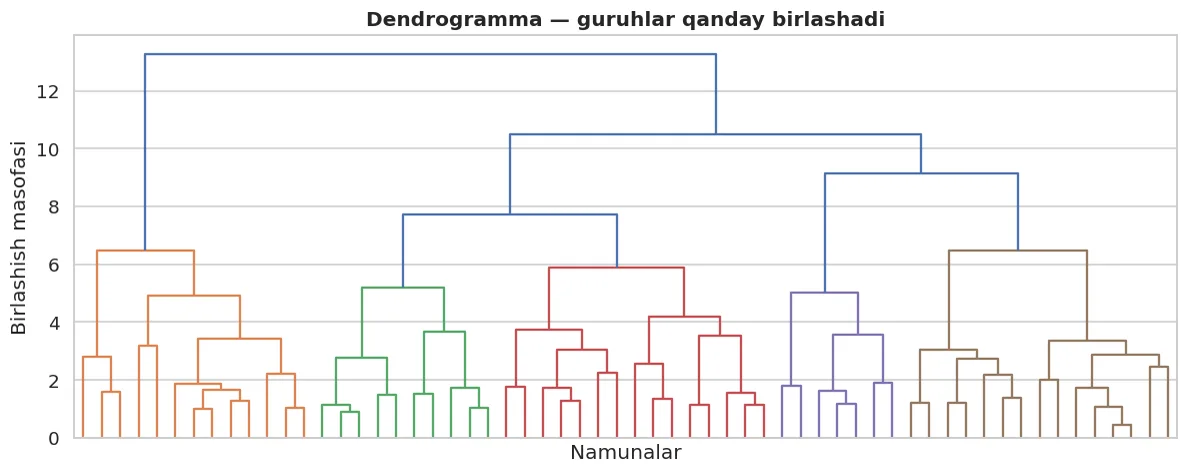
Pastdan yuqoriga: har nuqta o'z guruhida boshlanadi, keyin bosqichma-bosqich birlashadi. Gorizontal kesim K ni beradi.
Dendrogramma ning afzalligi: siz K ni oldindan bermaysiz — daraxtni ko'rib, keyin kesim joyini tanlaysiz.
Uchtasini taqqoslash
import time
from sklearn.metrics import calinski_harabasz_score, davies_bouldin_score

print(f"{'usul':<28} {'guruhlar':>9} {'silhouette':>12} {'Calinski-H':>12} {'vaqt':>8}")
print("-" * 76)
for nom, model in [
    ("KMeans(4)", KMeans(n_clusters=4, n_init=10, random_state=42)),
    ("DBSCAN(eps=1.2)", DBSCAN(eps=1.2, min_samples=10)),
    ("Agglomerative(4)", AgglomerativeClustering(n_clusters=4, linkage="ward")),
]:
    t0 = time.perf_counter()
    yl = model.fit_predict(Xs)
    dt = time.perf_counter() - t0
    mask = yl != -1
    n_g = len(set(yl[mask]))
    if n_g > 1:
        s = silhouette_score(Xs[mask], yl[mask])
        ch = calinski_harabasz_score(Xs[mask], yl[mask])
    else:
        s = ch = float("nan")
    print(f"{nom:<28} {n_g:>9} {s:>12.4f} {ch:>12.1f} {dt:>7.2f}s")
usul                          guruhlar   silhouette   Calinski-H     vaqt
----------------------------------------------------------------------------
KMeans(4)                            4       0.1632        232.7    0.09s
DBSCAN(eps=1.2)                      3       0.1449        113.3    0.01s
Agglomerative(4)                     4       0.1144        178.1    0.01s
show(pd.DataFrame([
    {"Mezon": "Silhouette", "Diapazon": "-1 .. +1", "Yaxshi": "Yuqori", "Izoh": "Eng ko'p ishlatiladigan"},
    {"Mezon": "Calinski-Harabasz", "Diapazon": "0 .. inf", "Yaxshi": "Yuqori", "Izoh": "Guruhlar orasi / ichi nisbati"},
    {"Mezon": "Davies-Bouldin", "Diapazon": "0 .. inf", "Yaxshi": "PAST", "Izoh": "Teskari o'qiladi"},
]))
| Mezon | Diapazon | Yaxshi | Izoh |
|---|---|---|---|
| Silhouette | -1 .. +1 | Yuqori | Eng ko'p ishlatiladigan |
| Calinski-Harabasz | 0 .. inf | Yuqori | Guruhlar orasi / ichi nisbati |
| Davies-Bouldin | 0 .. inf | PAST | Teskari o'qiladi |
Qaysi birini tanlaysiz
show(pd.DataFrame([
    {"Usul": "K-Means", "Qachon": "Katta ma'lumot, doira shaklidagi guruhlar",
     "K kerakmi": "HA", "Shovqin": "Ajratmaydi", "Tezlik": "Juda tez"},
    {"Usul": "DBSCAN", "Qachon": "Noma'lum shakl, shovqin bor",
     "K kerakmi": "yo'q (eps kerak)", "Shovqin": "AJRATADI (-1)", "Tezlik": "O'rtacha"},
    {"Usul": "Agglomerative", "Qachon": "Kichik ma'lumot, ierarxiya kerak",
     "K kerakmi": "yo'q (dendrogramma)", "Shovqin": "Ajratmaydi", "Tezlik": "Sekin (O(n^2)+)"},
    {"Usul": "GaussianMixture", "Qachon": "Guruhlar ustma-ust tushsa",
     "K kerakmi": "HA", "Shovqin": "Ajratmaydi", "Tezlik": "Tez"},
]))
| Usul | Qachon | K kerakmi | Shovqin | Tezlik |
|---|---|---|---|---|
| K-Means | Katta ma'lumot, doira shaklidagi guruhlar | HA | Ajratmaydi | Juda tez |
| DBSCAN | Noma'lum shakl, shovqin bor | yo'q (eps kerak) | AJRATADI (-1) | O'rtacha |
| Agglomerative | Kichik ma'lumot, ierarxiya kerak | yo'q (dendrogramma) | Ajratmaydi | Sekin (O(n^2)+) |
| GaussianMixture | Guruhlar ustma-ust tushsa | HA | Ajratmaydi | Tez |
Clustering ni supervised bilan tekshirish
Bizda target bor (ijaraga_berildi_30k), lekin clustering uni ko'rmadi. Qiziq savol: topilgan guruhlar target bilan bog'liqmi?
from sklearn.metrics import adjusted_rand_score

yorliq_km = KMeans(n_clusters=2, n_init=10, random_state=42).fit_predict(Xs)
y_haqiqiy = df["ijaraga_berildi_30k"].to_numpy()
print(f"K-Means(2) va haqiqiy target mosligi (ARI): {adjusted_rand_score(y_haqiqiy, yorliq_km):.4f}")
print()
print("Taqqoslash jadvali:")
show(pd.crosstab(yorliq_km, y_haqiqiy, rownames=["guruh"], colnames=["haqiqat"]).reset_index())
K-Means(2) va haqiqiy target mosligi (ARI): 0.1959

Taqqoslash jadvali:
| guruh | 0 | 1 |
|---|---|---|
| 0 | 411 | 153 |
| 1 | 181 | 455 |
ARI 0 ga yaqin bo'lsa — clustering target ni topmagan. Va bu normal: clustering target ni qidirmaydi, u ma'lumotdagi boshqa tuzilmani topadi.
Clustering target ni topishi shart emas
Talabalar ko'pincha clustering natijasini target bilan solishtirib, "ishlamadi" degan xulosa chiqaradi.
Lekin clustering boshqa savolga javob beradi: "bu ma'lumotda qanday tabiiy guruhlar bor?" Agar tabiiy guruhlar target bilan mos tushmasa — bu kamchilik emas, ma'lumot haqidagi ma'lumot.
Agar sizga target kerak bo'lsa, supervised model ishlating (14-21-bob).
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Vazifa", "Bitta jumla": "Yorliqsiz ma'lumotda tabiiy guruhlar topish"},
    {"Tushuncha": "K-Means", "Bitta jumla": "Markaz tashla -> biriktir -> markazni ko'chir"},
    {"Tushuncha": "n_init", "Bitta jumla": "Boshlang'ich markaz tasodifiy — 10 marta urinish kerak"},
    {"Tushuncha": "K ni tanlash", "Bitta jumla": "Elbow silliq bo'ladi; silhouette aniqroq"},
    {"Tushuncha": "Eng muhim qadam", "Bitta jumla": "Guruhlarni O'QISH va nom berish"},
    {"Tushuncha": "K-Means cheklovi", "Bitta jumla": "Doira shakl, teng hajm, K ni siz berasiz"},
    {"Tushuncha": "DBSCAN", "Bitta jumla": "K kerak emas, shovqinni ajratadi; yuqori o'lchovda ishlamaydi"},
    {"Tushuncha": "Agglomerative", "Bitta jumla": "Dendrogramma — K ni keyin tanlaysiz"},
    {"Tushuncha": "Scaling", "Bitta jumla": "Hammasiga SHART — masofaga tayanadi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Vazifa | Yorliqsiz ma'lumotda tabiiy guruhlar topish |
| K-Means | Markaz tashla -> biriktir -> markazni ko'chir |
| n_init | Boshlang'ich markaz tasodifiy — 10 marta urinish kerak |
| K ni tanlash | Elbow silliq bo'ladi; silhouette aniqroq |
| Eng muhim qadam | Guruhlarni O'QISH va nom berish |
| K-Means cheklovi | Doira shakl, teng hajm, K ni siz berasiz |
| DBSCAN | K kerak emas, shovqinni ajratadi; yuqori o'lchovda ishlamaydi |
| Agglomerative | Dendrogramma — K ni keyin tanlaysiz |
| Scaling | Hammasiga SHART — masofaga tayanadi |
Keyingi bobda: 6-qismning oxirgi usuli — target bor bo'lganda o'lchovni kamaytirish.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.