Ma'lumot formatlari: CSV dan Parquet gacha
Yo'qolgan nol
Hamkasbingiz sizga mijozlar ro'yxatini yubordi — oddiy Excel fayli. Siz uni ochdingiz va telefon raqamlariga qaradingiz:
901234567
907654321
Bir narsa yetishmayapti. O'zbekistonda telefon raqami 90 bilan emas, 090 bilan boshlanadi.
Boshidagi nol yo'qolgan.
Hech kim uni o'chirmadi. Excel "bu son ekan" deb qaror qildi va sonlarda boshida nol turmaydi. Fayl toza ko'rinadi, xato xabari yo'q, hamma ustun joyida. Faqat 200 ta telefon raqami endi noto'g'ri.
Bu — CSV ning birinchi va eng xavfli kamchiligi: u ma'lumot turini saqlamaydi. Har safar o'qiganda tur qaytadan taxmin qilinadi, va taxmin xato bo'lishi mumkin.
Shu bobda buni o'z ko'zingiz bilan ko'rasiz — va nol yo'qolmaydigan formatni o'rganasiz.
CSV nima uchun yetarli emas
CSV hamma joyda ishlaydi va Excel da ochiladi. Shuning uchun u ma'lumot almashish uchun yaxshi. Lekin ma'lumotni saqlash va qayta ishlash uchun uning to'rtta jiddiy kamchiligi bor.
Birinchisi eng xavflisi: CSV turlarni bilmaydi.
import pandas as pd
import io

xom = "id,kod,narx,sana,faol\n1,007,10.5,2026-09-01,true\n2,042,20.0,2026-09-02,false\n"
d = pd.read_csv(io.StringIO(xom))
print("CSV dan o'qilgandan keyingi turlar:")
for ustun, tur in d.dtypes.items():
    print(f"  {ustun:8} {str(tur):10} namuna: {d[ustun].iloc[0]!r}")
CSV dan o'qilgandan keyingi turlar:
  id       int64      namuna: np.int64(1)
  kod      int64      namuna: np.int64(7)
  narx     float64    namuna: np.float64(10.5)
  sana     object     namuna: '2026-09-01'
  faol     bool       namuna: np.True_
kod ustuniga qarang. Faylda 007 yozilgan edi — o'qilgandan keyin 7 bo'ldi. Boshlang'ich
nollar yo'qoldi.
Nega bunday bo'ldi? CSV — bu oddiy matn fayli. Uning ichida 007 va "007" orasida farq
yo'q; hammasi belgilar. Faylda "bu ustun matn" deb yozilgan joy yo'q.
Shuning uchun pandas har o'qishda taxmin qiladi: ustunga qaraydi, hamma qiymat raqamga
o'xshasa — "demak bu son" deydi. Va sonlarda boshida nol turmaydi.
Diqqat qiling: bu pandas ning xatosi emas. U qo'lidan kelganini qildi. Ma'lumot esa
faylning o'zida yo'q edi.
sana ustuniga ham qarang — u object, ya'ni matn bo'lib qoldi. Endi undan oy yoki hafta
kunini olish uchun avval aylantirish kerak, va aylantirishni unutish oson.
Taxmin har o'qishda qaytadan qilinadi
Eng nozik tomoni shu: taxmin faylga bog'liq emas, ma'lumotga bog'liq.
Bugun faylingizdagi barcha kodlar raqam — pandas "son" deb o'qiydi. Ertaga bitta yangi
qator qo'shiladi va unda kod A007 bo'ladi — endi pandas butun ustunni "matn" deb
o'qiydi.
Bir kunda ustun turi o'z-o'zidan o'zgardi. Kodingiz o'zgarmadi. Va agar siz o'sha ustunda arifmetika qilayotgan bo'lsangiz, bugun ishlagan kod ertaga yiqiladi.
1-bobdagi naqsh yana qaytadi: hech kim hech narsa buzmadi, lekin tizim buzildi.
Qator-qator va ustun-ustun saqlash
Ikkinchi kamchilik tuzilishda. CSV qator bo'yicha saqlaydi, Parquet esa ustun bo'yicha.
diagramma(
    {
        "CSV (qator bo'yicha)": (0, 0, 4.4, 0.7, "manba"),
        "1-qator: Aziz | A | 85": (0, 0.9, 4.4, 0.6, "oddiy"),
        "2-qator: Bobur | A | 92": (0, 1.7, 4.4, 0.6, "oddiy"),
        "3-qator: Dilnoza | B | 78": (0, 2.5, 4.4, 0.6, "oddiy"),
        "Parquet (ustun bo'yicha)": (5.6, 0, 4.4, 0.7, "saqlash"),
        "ism: Aziz, Bobur, Dilnoza": (5.6, 0.9, 4.4, 0.6, "oddiy"),
        "guruh: A, A, B": (5.6, 1.7, 4.4, 0.6, "oddiy"),
        "baho: 85, 92, 78": (5.6, 2.5, 4.4, 0.6, "oddiy"),
    },
    nom="qator_ustun.png", kenglik=13,
    izoh="Chapda har qator birga yotadi. O'ngda har ustun birga yotadi — bitta ustunni o'qish uchun qolganini o'qish shart emas.",
)
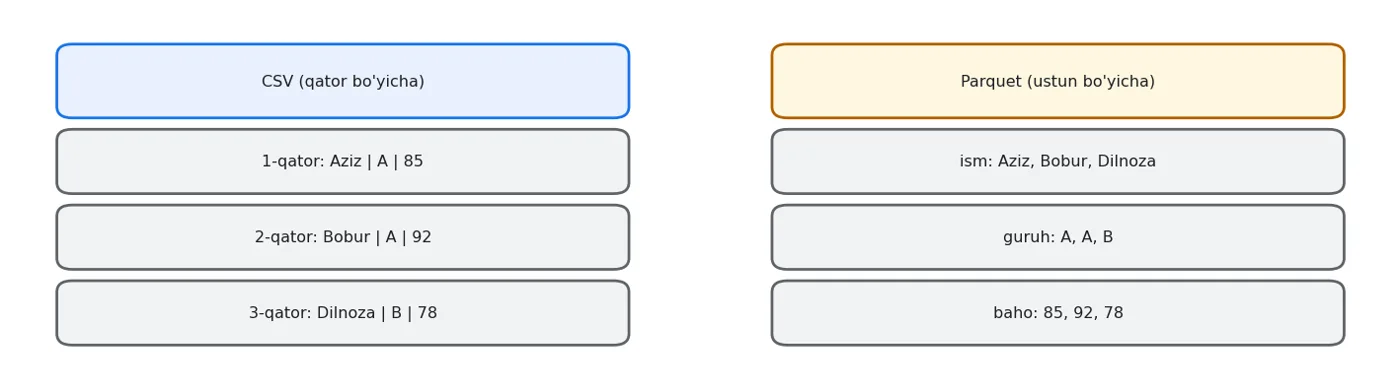
Chapda har qator birga yotadi. O'ngda har ustun birga yotadi — bitta ustunni o'qish uchun qolganini o'qish shart emas.
Farqi amalda nimani beradi:
Nega bu farq qiladi? Kutubxonani yana bir marta eslang.
CSV — bu kundalik daftar. Har kun uchun bitta bet: sana, ob-havo, nima yedingiz, kim keldi. Hammasi birga.
Endi savol: "bir yilda necha kun yomg'ir yog'di?"
Daftarni ochib, har betni varaqlashingiz kerak — chunki ob-havo har betda boshqa narsalar orasida yozilgan.
Parquet — bu alohida jadvallar. Bitta varaqda faqat sanalar. Ikkinchisida faqat ob-havo. Uchinchisida faqat taomlar.
O'sha savol uchun endi bitta varaq yetadi. Qolganlarini qo'lga ham olmaysiz.
Ikki amaliy natija:
- Bitta ustun kerak bo'lsa — Parquet faqat o'shani diskdan ko'taradi. CSV esa butun faylni o'qib, keraksiz qismini tashlaydi. (9-bobda buni o'lchadik: Parquet OLAP so'rovida 13 barobar tez chiqdi.)
- Siqish yaxshiroq — bir ustundagi qiymatlar o'xshash bo'ladi. Ob-havo varag'ida faqat "quyoshli, bulutli, yomg'ir" takrorlanadi. Takroriy narsani siqish esa oson.
Ikkalasini ham o'lchaymiz.
O'lchov: hajm
import pandas as pd
from pathlib import Path

ISH.mkdir(parents=True, exist_ok=True)
d = pd.read_csv(DATA / "ijara.csv")
print(f"ma'lumot: {len(d):,} qator, {len(d.columns)} ustun")

yollar = {}
d.to_csv(ISH / "t.csv", index=False)
yollar["CSV"] = ISH / "t.csv"

import gzip, shutil
with open(ISH / "t.csv", "rb") as f_in, gzip.open(ISH / "t.csv.gz", "wb", compresslevel=6) as f_out:
    shutil.copyfileobj(f_in, f_out)
yollar["CSV + gzip"] = ISH / "t.csv.gz"

for siqish in ["snappy", "gzip", "zstd"]:
    try:
        yol = ISH / f"t_{siqish}.parquet"
        d.to_parquet(yol, compression=siqish, index=False)
        yollar[f"Parquet ({siqish})"] = yol
    except Exception as e:
        print(f"  {siqish}: {type(e).__name__}")

asos = yollar["CSV"].stat().st_size
qatorlar = []
for nom, yol in yollar.items():
    hajm = yol.stat().st_size
    qatorlar.append({"format": nom, "hajm, KB": round(hajm / 1024, 1),
                     "CSV ga nisbatan": f"{hajm / asos:.2f}x",
                     "tejaldi": f"{100 * (1 - hajm / asos):.0f}%"})
show(pd.DataFrame(qatorlar))
ma'lumot: 12,000 qator, 14 ustun
| format | hajm, KB | CSV ga nisbatan | tejaldi |
|---|---|---|---|
| CSV | 704.9 | 1.00x | 0% |
| CSV + gzip | 215.9 | 0.31x | 69% |
| Parquet (snappy) | 212.6 | 0.30x | 70% |
| Parquet (gzip) | 171.8 | 0.24x | 76% |
| Parquet (zstd) | 169.3 | 0.24x | 76% |
O'lchov: o'qish tezligi
import time

def olch(f, n=5):
    f()
    t0 = time.perf_counter()
    for _ in range(n):
        natija = f()
    return (time.perf_counter() - t0) / n * 1000, natija

qatorlar = []
ms, _ = olch(lambda: pd.read_csv(ISH / "t.csv"))
qatorlar.append({"amal": "CSV — butun fayl", "ms": round(ms, 1)})

ms, _ = olch(lambda: pd.read_parquet(ISH / "t_snappy.parquet"))
qatorlar.append({"amal": "Parquet — butun fayl", "ms": round(ms, 1)})

ms, _ = olch(lambda: pd.read_csv(ISH / "t.csv", usecols=["narx_mln", "broker"]))
qatorlar.append({"amal": "CSV — 2 ustun", "ms": round(ms, 1)})

ms, _ = olch(lambda: pd.read_parquet(ISH / "t_snappy.parquet", columns=["narx_mln", "broker"]))
qatorlar.append({"amal": "Parquet — 2 ustun", "ms": round(ms, 1)})
show(pd.DataFrame(qatorlar))
| amal | ms |
|---|---|
| CSV — butun fayl | 11.2 |
| Parquet — butun fayl | 6.4 |
| CSV — 2 ustun | 6.8 |
| Parquet — 2 ustun | 2.6 |
Ikki ustun o'qiganda farq eng katta bo'ladi: CSV baribir har qatorni to'liq o'qib, ajratib, keraksizini tashlashi kerak. Parquet esa faqat kerakli ikki ustunni diskdan oladi.
O'lchov: turlar saqlanadimi
Bu eng muhim farq va uni o'lchash oson:
import pandas as pd
from datetime import date

sinov = pd.DataFrame({
    "kod": ["007", "042", "100"],
    "sana": pd.to_datetime(["2026-09-01", "2026-09-02", "2026-09-03"]),
    "narx": [10.5, 20.0, 30.25],
    "faol": [True, False, True],
    "toifa": pd.Categorical(["A", "B", "A"]),
})
print("ASL turlar:")
for u, t in sinov.dtypes.items():
    print(f"  {u:7} {t}")

sinov.to_csv(ISH / "turlar.csv", index=False)
sinov.to_parquet(ISH / "turlar.parquet", index=False)
csv_qayta = pd.read_csv(ISH / "turlar.csv")
pq_qayta = pd.read_parquet(ISH / "turlar.parquet")

qatorlar = []
for u in sinov.columns:
    qatorlar.append({
        "ustun": u,
        "asl": str(sinov[u].dtype),
        "CSV dan keyin": str(csv_qayta[u].dtype),
        "Parquet dan keyin": str(pq_qayta[u].dtype),
        "CSV saqladimi": str(sinov[u].dtype) == str(csv_qayta[u].dtype),
    })
show(pd.DataFrame(qatorlar))
print("\nCSV dan keyin 'kod' birinchi qiymati:", repr(csv_qayta["kod"].iloc[0]))
print("Parquet dan keyin                    :", repr(pq_qayta["kod"].iloc[0]))
ASL turlar:
  kod     object
  sana    datetime64[ns]
  narx    float64
  faol    bool
  toifa   category

CSV dan keyin 'kod' birinchi qiymati: np.int64(7)
Parquet dan keyin                    : '007'
| ustun | asl | CSV dan keyin | Parquet dan keyin | CSV saqladimi |
|---|---|---|---|---|
| kod | object | int64 | object | False |
| sana | datetime64[ns] | object | datetime64[ns] | False |
| narx | float64 | float64 | float64 | True |
| faol | bool | bool | bool | True |
| toifa | category | object | category | False |
Parquet turlarni sxema bilan birga saqlaydi, shuning uchun qayta o'qiganda hech narsa
o'zgarmaydi. 007 ham 007 bo'lib qoladi.
Parquet ichida nima bor
import pyarrow.parquet as pq

fayl = pq.ParquetFile(ISH / "t_snappy.parquet")
print("sxema (birinchi 6 ustun):")
for maydon in list(fayl.schema_arrow)[:6]:
    print(f"  {maydon.name:24} {maydon.type}")
print(f"\nqator guruhlari (row groups): {fayl.num_row_groups}")
print(f"jami qatorlar: {fayl.metadata.num_rows:,}")

# har ustun uchun statistika — so'rovni tezlashtiradi
guruh = fayl.metadata.row_group(0)
print("\nustun statistikasi (1-guruh):")
for i in range(min(4, guruh.num_columns)):
    ust = guruh.column(i)
    st = ust.statistics
    if st is not None:
        print(f"  {ust.path_in_schema:22} min={st.min}  max={st.max}  siqilgan={ust.total_compressed_size:>7} bayt")
sxema (birinchi 6 ustun):
  elon_id                  string
  sana                     string
  tuman                    string
  xonalar                  int64
  maydon                   double
  qavat                    int64

qator guruhlari (row groups): 1
jami qatorlar: 12,000

ustun statistikasi (1-guruh):
  elon_id                min=E100042  max=E999992  siqilgan=  94501 bayt
  sana                   min=2026-08-01  max=2026-08-30  siqilgan=   7776 bayt
  tuman                  min=Bektemir  max=Yunusobod  siqilgan=   6235 bayt
  xonalar                min=1  max=4  siqilgan=   3147 bayt
Statistika qatoriga e'tibor bering. Har ustun guruhi uchun min va max saqlanadi. Shuning
uchun WHERE narx_mln > 50 so'rovi kelganda, engine max=12 bo'lgan guruhni umuman
o'qimaydi. Bu predicate pushdown deyiladi va 18-bobda uni o'lchaymiz.
Qachon qaysi format
import pandas as pd
show(pd.DataFrame([
    {"holat": "Odam Excel da ochadi", "format": "CSV", "sabab": "Universal, tahrirlash oson"},
    {"holat": "API javobi, ichma-ich tuzilish", "format": "JSON", "sabab": "Ierarxiya saqlanadi"},
    {"holat": "Ma'lumot ombori, tahlil", "format": "Parquet", "sabab": "Ustunli, siqilgan, turli"},
    {"holat": "Oqim (streaming) xabari", "format": "Avro / JSON", "sabab": "Qatorli, sxema evolyutsiyasi"},
    {"holat": "Model artefakti", "format": "joblib / ONNX", "sabab": "26-bobda batafsil"},
    {"holat": "Jadval versiyalari, time travel", "format": "Iceberg", "sabab": "19-bob"},
]))
| holat | format | sabab |
|---|---|---|
| Odam Excel da ochadi | CSV | Universal, tahrirlash oson |
| API javobi, ichma-ich tuzilish | JSON | Ierarxiya saqlanadi |
| Ma'lumot ombori, tahlil | Parquet | Ustunli, siqilgan, turli |
| Oqim (streaming) xabari | Avro / JSON | Qatorli, sxema evolyutsiyasi |
| Model artefakti | joblib / ONNX | 26-bobda batafsil |
| Jadval versiyalari, time travel | Iceberg | 19-bob |
Parquet ham hamma dardga davo emas
Kichik fayllarda foyda yo'q. 1000 qator uchun Parquet ning metama'lumoti CSV dan ham ko'proq joy egallashi mumkin.
Qator-qator qo'shib bo'lmaydi. Parquet fayl "yozib tugatiladi". Har yangi qator uchun qo'shimcha qilolmaysiz — shuning uchun oqim uchun u to'g'ridan-to'g'ri yaramaydi (19-bobdagi Iceberg shu muammoni yechadi).
Odam o'qiy olmaydi. cat bilan ko'rib bo'lmaydi, grep ishlamaydi.
Kichik fayl da'vosini tekshiramiz:
import pandas as pd
qatorlar = []
for n in (100, 1_000, 10_000, 100_000):
    kichik = d.head(n) if n <= len(d) else pd.concat([d] * (n // len(d) + 1)).head(n)
    kichik.to_csv(ISH / "k.csv", index=False)
    kichik.to_parquet(ISH / "k.parquet", compression="snappy", index=False)
    c = (ISH / "k.csv").stat().st_size
    p = (ISH / "k.parquet").stat().st_size
    qatorlar.append({"qatorlar": f"{n:,}", "CSV, KB": round(c / 1024, 1),
                     "Parquet, KB": round(p / 1024, 1), "nisbat": f"{p / c:.2f}x",
                     "Parquet foydalimi": "ha" if p < c else "yo'q"})
show(pd.DataFrame(qatorlar))
| qatorlar | CSV, KB | Parquet, KB | nisbat | Parquet foydalimi |
|---|---|---|---|---|
| 100 | 6 | 11.8 | 1.97x | yo'q |
| 1,000 | 58.9 | 32 | 0.54x | ha |
| 10,000 | 587.3 | 181.6 | 0.31x | ha |
| 100,000 | 5 872.7 | 788.9 | 0.13x | ha |
Loyihamizga qo'llaymiz
shu faylni yaratingsrc/quvur/saqlash.py
"""Ma'lumotni o'qish va yozish — bitta joyda, format tanlovi bilan."""
from pathlib import Path

import pandas as pd

SIQISH = "snappy"


def yoz(df: pd.DataFrame, yol: str | Path) -> Path:
    """Kengaytmaga qarab format tanlaydi. Parquet uchun turlar saqlanadi."""
    p = Path(yol)
    p.parent.mkdir(parents=True, exist_ok=True)
    if p.suffix == ".parquet":
        df.to_parquet(p, compression=SIQISH, index=False)
    elif p.suffix == ".csv":
        df.to_csv(p, index=False, encoding="utf-8")
    else:
        raise ValueError(f"noma'lum format: {p.suffix} (.parquet yoki .csv kutilgan)")
    return p


def oqi(yol: str | Path, ustunlar: list[str] | None = None) -> pd.DataFrame:
    """Parquet bo'lsa faqat kerakli ustunlarni diskdan oladi."""
    p = Path(yol)
    if not p.exists():
        raise FileNotFoundError(f"ma'lumot topilmadi: {p}")
    if p.suffix == ".parquet":
        return pd.read_parquet(p, columns=ustunlar)
    if p.suffix == ".csv":
        return pd.read_csv(p, usecols=ustunlar)
    raise ValueError(f"noma'lum format: {p.suffix}")


def csv_dan_parquet(manba: str | Path, nishon: str | Path) -> dict[str, float]:
    """CSV ni Parquet ga o'tkazadi va tejamni qaytaradi."""
    df = pd.read_csv(manba)
    yoz(df, nishon)
    c = Path(manba).stat().st_size
    p = Path(nishon).stat().st_size
    return {"csv_kb": round(c / 1024, 1), "parquet_kb": round(p / 1024, 1),
            "tejam_foiz": round(100 * (1 - p / c), 1)}
python3 -c "
import sys; sys.path.insert(0, 'src')
from quvur.saqlash import csv_dan_parquet, oqi

for nom in ['ijara', 'ballon', 'buyurtma']:
    n = csv_dan_parquet(f'../datasets/{nom}.csv', f'../datasets/{nom}.parquet')
    print(f\"  {nom:10} {n['csv_kb']:>9.1f} KB -> {n['parquet_kb']:>8.1f} KB   tejam {n['tejam_foiz']:>5.1f}%\")

d = oqi('../datasets/ijara.parquet', ustunlar=['narx_mln', 'broker'])
print()
print('faqat 2 ustun o\'qildi:', list(d.columns), '|', len(d), 'qator')
"
  ijara          704.9 KB ->    212.6 KB   tejam  69.8%
  ballon        2545.3 KB ->    731.3 KB   tejam  71.3%
  buyurtma      4384.3 KB ->   1236.9 KB   tejam  71.8%

faqat 2 ustun o'qildi: ['narx_mln', 'broker'] | 12000 qator
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| CSV va turlar | 007 → 7; sana matn bo'lib qoladi; ogohlantirish yo'q |
| Qatorli va ustunli | Parquet bitta ustunni qolganini o'qimasdan oladi |
| Hajm | Parquet CSV dan sezilarli kichik; siqish turi ham ta'sir qiladi |
| Ustun tanlash | Eng katta tezlik farqi shu yerda |
| Sxema | Parquet turlarni fayl ichida saqlaydi |
| Statistika | Har guruhda min/max — so'rov keraksiz qismni o'qimaydi |
| Parquet cheklovi | Kichik faylda foydasiz; qator qo'shib bo'lmaydi; odam o'qimaydi |
Talaba ishi
ijara.csvnizstdvagzipbilan yozib, hajm va yozish vaqtini ham o'lchang. Qaysi biri sizning holatingizga mos?buyurtma.csvdan faqatsumma_mingustunini o'qing — CSV va Parquet dan. Farqijaradagidan kattami yoki kichikmi? Nega?to_parquet(..., row_group_size=1000)bilan yozing vanum_row_groupsni tekshiring. Guruh kichrayganda statistika qanday o'zgaradi?kodustuni muammosini CSV da hal qiling:read_csvgadtype={"kod": str}bering. Bu yechim nega ishonchsiz? (Maslahat: kim eslab qoladi?)
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.