MLOps nima va nega oddiy dasturdan farq qiladi
O'n yil oldin shaharni yodlagan taksichi
Toshkentda taksi chaqirdingiz. Haydovchi tajribali — u shaharni yoddan biladi. Navigator ishlatmaydi, "qayerdan yurish kerakligini o'zim bilaman" deydi.
Va u haqiqatan biladi. O'n yil oldin.
O'shandan beri yangi ko'chalar ochildi, ba'zilari bir tomonlama bo'ldi, tirbandlik boshqa joyga ko'chdi. Haydovchi esa o'sha eski xaritaga qarab yuradi.
Endi eng muhim savol: u xato qilyaptimi?
Mashinasi buzilmadi. Yo'ldan chiqmadi. Hech qanday signal chalinmadi. U sizni manzilga olib keldi — atigi 20 daqiqa ortiqcha vaqt sarflab. Va u buni bilmaydi ham, chunki hech kim unga aytmadi.
Mana shu — ishlab chiqarishdagi ML modelining eng xavfli holati.
Buzilgan dastur baqiradi, buzilgan model esa jim
Farqni aniq qo'yaylik.
Oddiy dastur buzilsa, u baqiradi: xato xabari chiqadi, sayt ochilmaydi, log qizaradi, telefoningizga ogohlantirish keladi. Siz muammo borligini bilasiz.
Model buzilsa, u javob berishda davom etadi. Ishonch bilan. Xuddi o'sha taksichidek.
Hech qanday xato yo'q. Sayt ishlayapti. Server yashil. Faqat javoblar sekin-asta noto'g'ri bo'lib boradi, va buni birinchi bo'lib mijozlar sezadi — siz emas.
Nega bu butun kitobning sababi
Agar model buzilganda xato bersa, MLOps kerak bo'lmasdi — oddiy monitoring yetardi.
Butun murakkablik shundan kelib chiqadi: buzilganini o'zingiz qidirib topishingiz kerak. Siz uni o'lchamasangiz, hech kim aytmaydi.
Uch narsa, bitta tizim
Nega model jim buziladi? Chunki ML tizimida o'zgaradigan narsalar ko'p.
Oddiy dasturda bitta narsa o'zgaradi: kod. Uni git da saqlaysiz, test yozasiz, deploy qilasiz.
ML tizimida uchta narsa o'zgaradi va ular bir-biridan mustaqil:
diagramma(
    {
        "KOD\n(o'qitish, xizmat)": (0, 0, 2.6, 1.1, "qayta"),
        "MA'LUMOT\n(o'qitish to'plami)": (3.4, 0, 2.6, 1.1, "manba"),
        "MODEL\n(o'qitilgan vaznlar)": (6.8, 0, 2.6, 1.1, "saqlash"),
        "Ishlab chiqarishdagi tizim": (3.4, 2.2, 2.6, 1.1, "xizmat"),
    },
    [
        ("KOD\n(o'qitish, xizmat)", "Ishlab chiqarishdagi tizim"),
        ("MA'LUMOT\n(o'qitish to'plami)", "Ishlab chiqarishdagi tizim"),
        ("MODEL\n(o'qitilgan vaznlar)", "Ishlab chiqarishdagi tizim"),
    ],
    nom="uchlik.png", kenglik=11,
    izoh="Uchala tomon mustaqil o'zgaradi. Bittasi o'zgarsa, natija o'zgaradi — kod o'sha bo'lsa ham.",
)
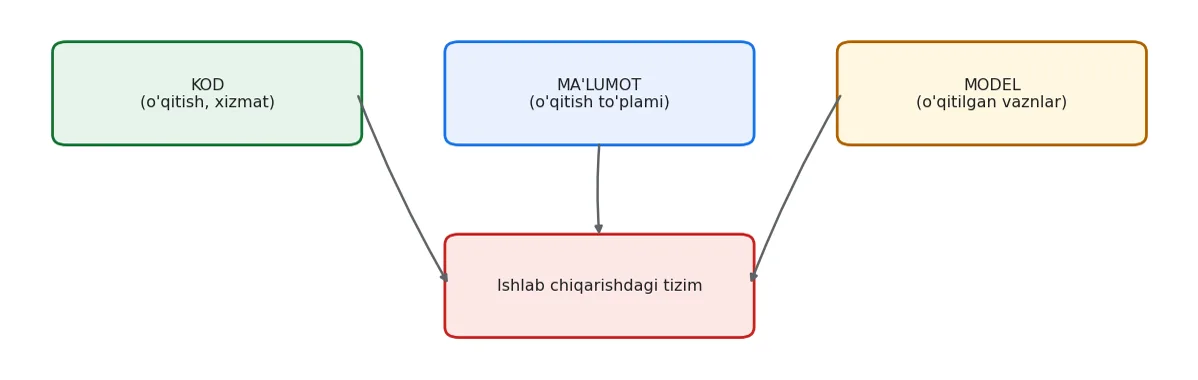
Uchala tomon mustaqil o'zgaradi. Bittasi o'zgarsa, natija o'zgaradi — kod o'sha bo'lsa ham.
Rasmga qarang: uchala quti ham natijaga ta'sir qiladi, lekin ularning faqat bittasi git da yotadi.
Bu farq MLOps ning butun sababi. Oddiy dasturda "kod o'zgarmadi — xulq o'zgarmaydi" qoidasi ishlaydi. ML da esa kod o'zgarmasa ham natija buzilishi mumkin, chunki dunyo o'zgargan.
Taksichini eslang: uning "kodi" (haydash mahorati) benuqson. O'zgargan narsa — shahar.
Buni aytish oson, ko'rsatish esa ishonarliroq. Shuning uchun birinchi bobdayoq ko'rsatamiz: haqiqiy model quramiz, uni bir oy "eskirtiramiz" va aniq raqam bilan nima yo'qolganini o'lchaymiz.
Haqiqiy masala: broker aniqlash
Kitob davomida bitta masala ustida ishlaymiz. U o'ylab topilgan emas — bu ijara e'lonlari platformasining haqiqiy muammosi.
Foydalanuvchi uy egasini qidiradi, lekin e'lonlarning katta qismini brokerlar joylaydi. Broker e'loni odatda: bitta telefon ko'p e'londa, tavsif qisqa va shablon, rasm kam, narx bozordan bir oz past.
Vazifa: e'lon brokernikimi yoki egasinikimi — shuni bashorat qilish.
import pandas as pd
d = pd.read_csv(DATA / "ijara.csv")
print(f"e'lonlar: {len(d):,} | ustunlar: {len(d.columns)}")
print(f"broker ulushi: {100 * d['broker'].mean():.1f}%")
show(d.head(5)[["tuman", "xonalar", "maydon", "narx_mln", "tavsif_uzunligi",
                "rasmlar_soni", "telefon_takrorlanishi", "broker"]])
e'lonlar: 12,000 | ustunlar: 14
broker ulushi: 35.6%
| tuman | xonalar | maydon | narx_mln | tavsif_uzunligi | rasmlar_soni | telefon_takrorlanishi | broker |
|---|---|---|---|---|---|---|---|
| Yakkasaroy | 4 | 99.4 | 11.47 | 189 | 11 | 2 | 0 |
| Sergeli | 1 | 21.1 | 1.2 | 136 | 6 | 4 | 0 |
| Sergeli | 1 | 43.1 | 1.85 | 109 | 3 | 5 | 1 |
| Mirzo Ulug'bek | 2 | 61.8 | 5.61 | 295 | 5 | 1 | 0 |
| Olmazor | 1 | 38.7 | 1.83 | 163 | 7 | 8 | 1 |
Signallar ustma-ust tushadi — bu muhim. Bitta ustunga qarab ajratib bo'lmaydi:
import pandas as pd
qatorlar = []
for ustun in ["telefon_takrorlanishi", "kunlik_elonlar", "tavsif_uzunligi", "rasmlar_soni"]:
    e = d[d.broker == 1][ustun]
    o = d[d.broker == 0][ustun]
    # ikki taqsimot qanchalik ustma-ust tushadi
    past, yuqori = min(e.min(), o.min()), max(e.max(), o.max())
    qatorlar.append({
        "belgi": ustun,
        "broker o'rtacha": round(e.mean(), 1),
        "ega o'rtacha": round(o.mean(), 1),
        "broker oralig'i": f"{e.min():.0f}–{e.max():.0f}",
        "ega oralig'i": f"{o.min():.0f}–{o.max():.0f}",
    })
show(pd.DataFrame(qatorlar))
| belgi | broker o'rtacha | ega o'rtacha | broker oralig'i | ega oralig'i |
|---|---|---|---|---|
| telefon_takrorlanishi | 5.6 | 2.4 | 1–16 | 1–15 |
| kunlik_elonlar | 3.4 | 1.8 | 1–13 | 1–8 |
| tavsif_uzunligi | 211.4 | 374.9 | 30–872 | 30–900 |
| rasmlar_soni | 5.1 | 8.4 | 1–18 | 1–22 |
Jadvalga diqqat bilan qarang — bu yerda butun ML ning sababi yashiringan.
O'rtachalar farq qiladi. Broker e'lonida telefon ko'proq takrorlanadi, tavsif qisqaroq. Demak signal bor.
Lekin oraliqlar ustma-ust tushadi. Brokerning eng kam qiymati egasining eng ko'p qiymatidan past. Ya'ni ular kesishadi.
Nega bu muhim? Chunki agar kesishmaganida, sizga model umuman kerak bo'lmasdi. Oddiy shart yozardingiz:
agar telefon_takrorlanishi > 5:
    bu broker
Bir qator kod, nol ML, nol MLOps. Ishonchli va tushunarli.
Lekin haqiqiy dunyoda shunday chegara yo'q. Ba'zi uy egalari haqiqatan ko'p e'lon joylaydi — masalan bir necha kvartirasi bor odam. Ba'zi brokerlar esa ehtiyotkor bo'lib, har telefonni bir marta ishlatadi.
Qaysi chegarani qo'ysangiz ham, siz kimnidir noto'g'ri belgilaysiz.
Model buni hal qilmaydi — u ham xato qiladi. Uning farqi shundaki, u bitta ustunga emas, o'nta ustunga birdan qaraydi va ular orasidagi murakkab bog'liqlikni topadi. Telefon ko'p takrorlangani o'zi yetarli emas, lekin telefon ko'p + tavsif qisqa + rasm kam birgalikda — ancha kuchli dalil.
Avval qoida yozib ko'ring
Amaliy maslahat, va u ML kurslarida kamdan-kam aytiladi: har yangi masalada avval oddiy qoida yozib ko'ring va uning aniqligini o'lchang.
Ba'zan qoida yetarli bo'ladi. Unda model qurmang — qoidani saqlash arzon, tushunarli va u 1-bobdagi jim buzilish muammosiga duch kelmaydi.
Model faqat qoida yetmaganda kerak. Va buni bilish uchun qoidani o'lchash kerak.
Birinchi model
import time
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import f1_score, precision_score, recall_score, roc_auc_score

XUSUSIYATLAR = ["xonalar", "maydon", "qavat", "jami_qavat", "narx_mln", "tavsif_uzunligi",
                "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar", "egasi_tasdiqlangan"]

X, y = d[XUSUSIYATLAR], d["broker"]
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.25, random_state=42, stratify=y)

t0 = time.perf_counter()
model = RandomForestClassifier(n_estimators=150, min_samples_leaf=3,
                               random_state=42, n_jobs=-1).fit(Xtr, ytr)
oqitish_s = time.perf_counter() - t0

p = model.predict(Xte)
ehtimol = model.predict_proba(Xte)[:, 1]
print(f"o'qitish vaqti: {oqitish_s:.1f} s | o'qitish to'plami: {len(Xtr):,} qator")
print(f"F1        : {f1_score(yte, p):.3f}")
print(f"aniqlik   : {precision_score(yte, p):.3f}")
print(f"to'liqlik : {recall_score(yte, p):.3f}")
print(f"AUC       : {roc_auc_score(yte, ehtimol):.3f}")
o'qitish vaqti: 0.3 s | o'qitish to'plami: 9,000 qator
F1        : 0.860
aniqlik   : 0.895
to'liqlik : 0.828
AUC       : 0.915
F1 0.860. Bu nimani anglatadi?
To'rt raqam chiqdi va ularni chalkashtirmaslik muhim, chunki ular boshqa savollarga javob beradi:
| Metrika | Savol | Kimni qiziqtiradi |
|---|---|---|
| Aniqlik (precision) | "Broker dedim — nechtasi rostdan broker?" | Foydalanuvchi: begunoh egani broker deb belgilamang |
| To'liqlik (recall) | "Brokerlarning nechtasini tutdim?" | Platforma: brokerlar o'tib ketmasin |
| F1 | Ikkalasining muvozanati | Umumiy baho |
| AUC | Model tartiblay oladimi | Chegarani keyin tanlash uchun |
Bu ajratish keyinroq qimmatga tushadi. Tasavvur qiling: model uy egasini broker deb belgiladi va uning e'loni o'chirildi. U jahli chiqib qo'ng'iroq qiladi — bu aniqlik muammosi. Aksincha, brokerlar bemalol e'lon joylayversa — bu to'liqlik muammosi.
Ikkalasini bir vaqtda yaxshilab bo'lmaydi: chegarani qattiqlashtirsangiz aniqlik oshadi, to'liqlik tushadi. Qaysi birini tanlash — texnik emas, biznes qarori.
0.860 esa mukammal emas, va bu to'g'ri. Ma'lumotimizda 6% yorliq shovqini bor — ya'ni ba'zi e'lonlar noto'g'ri belgilangan. Agar F1 1.000 chiqqanida, bu model shovqinni ham "yodlab olgan" degani bo'lardi va yangi ma'lumotda darhol qulardi.
1.000 ko'rsangiz, xursand bo'lmang — qidiring
Yangi boshlovchilarning eng ko'p uchraydigan xatosi: mukammal natijani muvaffaqiyat deb qabul qilish.
Haqiqiy ma'lumotda mukammal natija deyarli har doim xatoni anglatadi. Eng ko'p sabab —
javob xususiyatlar orasiga tushib qolgan (masalan broker_id ustuni qolib ketgan), yoki
test to'plami o'qitish to'plami bilan aralashgan.
Qoida: natija kutganingizdan yaxshiroq bo'lsa, uni tekshiring. Yomonroq bo'lsa ham tekshiring, lekin yaxshiroq bo'lganda albatta.
Shu yerda ko'p kurs tugaydi: "model o'qitildi, aniqlik yaxshi, tayyor". Diplom beriladi, video tugaydi.
Bu kitob esa shu yerdan boshlanadi. Chunki modelning haqiqiy hayoti endi boshlanadi — va u yerda hech kim sizga F1 ni aytib turmaydi.
Bir oydan keyin
Model ishlab chiqarishga chiqdi. Kod o'zgarmadi, model fayli o'sha. Bir oy o'tdi va yangi e'lonlar keldi:
yangi = pd.read_csv(DATA / "ijara_yangi.csv")
py = model.predict(yangi[XUSUSIYATLAR])
ey = model.predict_proba(yangi[XUSUSIYATLAR])[:, 1]

import pandas as pd
show(pd.DataFrame([
    {"davr": "Avgust (o'qitilgan)", "F1": round(f1_score(yte, p), 3),
     "aniqlik": round(precision_score(yte, p), 3), "to'liqlik": round(recall_score(yte, p), 3),
     "AUC": round(roc_auc_score(yte, ehtimol), 3)},
    {"davr": "Sentabr (yangi)", "F1": round(f1_score(yangi["broker"], py), 3),
     "aniqlik": round(precision_score(yangi["broker"], py), 3),
     "to'liqlik": round(recall_score(yangi["broker"], py), 3),
     "AUC": round(roc_auc_score(yangi["broker"], ey), 3)},
]))
| davr | F1 | aniqlik | to'liqlik | AUC |
|---|---|---|---|---|
| Avgust (o'qitilgan) | 0.86 | 0.895 | 0.828 | 0.915 |
| Sentabr (yangi) | 0.675 | 0.887 | 0.545 | 0.876 |
Mana MLOps nima uchun kerakligi, bitta jadvalda.
F1 0.860 dan 0.675 ga tushdi. Kod bir qator ham o'zgarmadi. Model fayli o'sha. Faqat dunyo o'zgardi.
Endi eng muhim savolni bering: siz buni qanday bilib oldingiz?
Javob — bilib olmadingiz. Bu yerda bilganingizning yagona sababi: bizda sentabr e'lonlarining
to'g'ri javoblari bor edi (yangi["broker"] ustuni). Biz modelning bashoratini haqiqat
bilan solishtira oldik.
Ishlab chiqarishda esa o'sha ustun yo'q. Model "bu broker" deydi, va... tamom. Hech kim kelib "yo'q, u uy egasi edi" demaydi.
Demak modelning yomonlashgani hech qayerda ko'rinmaydi:
- Xato yo'q — model ishlayapti
- Log toza — hech narsa yiqilmagan
- Server yashil — protsessor va xotira normal
- Sayt ishlayapti — sahifalar ochilmoqda
Yagona o'zgargan narsa — brokerlarning yarmi endi o'tib ketmoqda. Va buni birinchi bo'lib foydalanuvchilar sezadi, uch oydan keyin, "sizning saytingizda ham brokerlar ko'p ekan" degan shikoyat shaklida.
Taksichini eslang: u ham sizni manzilga olib keldi. Faqat 20 daqiqa kech.
Bu "modelni yaxshiroq qurish" bilan hal bo'lmaydi
Tabiiy fikr: "demak modelni kuchliroq qilish kerak edi — ko'proq ma'lumot, murakkabroq algoritm".
Yo'q. Har qanday model eskiradi, chunki muammo modelda emas — dunyo o'zgaradi. Brokerlar sizning tizimingizga moslashadi, bozor o'zgaradi, foydalanuvchilar odatini o'zgartiradi.
Yechim — eskimaydigan model emas (bunday model yo'q), balki eskiganini o'z vaqtida sezadigan tizim. Mana shu tizim MLOps deb ataladi, va butun kitob shuni quradi.
Nima bo'ldi aynan
Jadvalni diqqat bilan o'qing — u sababni ham aytadi.
Aniqlik deyarli o'zgarmadi (0.895 → 0.887): model "broker" desa, u hali ham haq. To'liqlik esa qulab tushdi (0.828 → 0.545): endi brokerlarning deyarli yarmini umuman ko'rmayapti.
Sababi ma'lumotda:
qatorlar = []
for ustun in ["tavsif_uzunligi", "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar"]:
    qatorlar.append({
        "belgi": ustun,
        "broker — avgust": round(d[d.broker == 1][ustun].mean(), 1),
        "broker — sentabr": round(yangi[yangi.broker == 1][ustun].mean(), 1),
        "ega (o'zgarmagan)": round(d[d.broker == 0][ustun].mean(), 1),
    })
show(pd.DataFrame(qatorlar))
| belgi | broker — avgust | broker — sentabr | ega (o'zgarmagan) |
|---|---|---|---|
| tavsif_uzunligi | 211.4 | 346.1 | 374.9 |
| rasmlar_soni | 5.1 | 7.8 | 8.4 |
| telefon_takrorlanishi | 5.6 | 5.6 | 2.4 |
| kunlik_elonlar | 3.4 | 3.4 | 1.8 |
Brokerlar moslashdi. Tavsifni uzaytirdilar (211 → 346), rasm ko'p qo'ya boshladilar (5.1 → 7.8) — ya'ni egaga o'xshab qoldilar. Telefon takrorlanishi esa o'zgarmadi, chunki uni o'zgartirish qiyin.
Model aynan o'sha ikki belgiga ko'p tayanardi. Endi ular ishlamaydi.
AUC sizni aldashi mumkin
O'sha jadvalda AUC 0.915 dan 0.876 ga tushdi — atigi 0.04. Agar faqat AUC ni kuzatganingizda, "hammasi joyida" deb o'ylardingiz. F1 esa 0.185 ga tushdi.
Sabab: AUC tartiblash sifatini o'lchaydi, chegaradan qat'i nazar. Model hali ham brokerlarni egalardan yuqoriroq baholaydi — lekin sizning 0.5 chegarangizdan pastda. Ishlab chiqarishda esa qaror chegara bilan qabul qilinadi.
Qaysi metrikani kuzatayotganingiz — qaror. Biznes qarori qaysi bo'lsa, o'shani o'lchang.
Demak MLOps nima
MLOps — bu bitta asbob emas, quyidagi savollarga javob beradigan amaliyotlar to'plami:
import pandas as pd
show(pd.DataFrame([
    {"savol": "Bu model qaysi ma'lumotda o'qitilgan?", "bob": "4, 5 — ma'lumot versiyalash"},
    {"savol": "O'sha natijani qayta ola olamanmi?", "bob": "2 — takrorlanish"},
    {"savol": "Qaysi tajriba eng yaxshi bo'lgan edi?", "bob": "22 — MLflow"},
    {"savol": "Hozir qaysi model ishlab turibdi?", "bob": "23 — model registri"},
    {"savol": "Yangi model eskisidan yomonroq emasmi?", "bob": "25, 31 — model testlari va CI"},
    {"savol": "Modelni qanday xizmatga aylantiraman?", "bob": "27 — FastAPI"},
    {"savol": "U qancha tez javob beradi?", "bob": "29 — latency o'lchash"},
    {"savol": "Serverga qanday chiqaraman?", "bob": "30, 32 — deploy va CD"},
    {"savol": "Yomon bo'lsa qanday orqaga qaytaraman?", "bob": "32 — rollback"},
    {"savol": "Model buzilganini qanday bilaman?", "bob": "34, 35 — kuzatuv va drift"},
    {"savol": "Qachon qayta o'qitaman?", "bob": "35 — qayta o'qitish"},
]))
| savol | bob |
|---|---|
| Bu model qaysi ma'lumotda o'qitilgan? | 4, 5 — ma'lumot versiyalash |
| O'sha natijani qayta ola olamanmi? | 2 — takrorlanish |
| Qaysi tajriba eng yaxshi bo'lgan edi? | 22 — MLflow |
| Hozir qaysi model ishlab turibdi? | 23 — model registri |
| Yangi model eskisidan yomonroq emasmi? | 25, 31 — model testlari va CI |
| Modelni qanday xizmatga aylantiraman? | 27 — FastAPI |
| U qancha tez javob beradi? | 29 — latency o'lchash |
| Serverga qanday chiqaraman? | 30, 32 — deploy va CD |
| Yomon bo'lsa qanday orqaga qaytaraman? | 32 — rollback |
| Model buzilganini qanday bilaman? | 34, 35 — kuzatuv va drift |
| Qachon qayta o'qitaman? | 35 — qayta o'qitish |
Bu savollarning birortasi ham "qaysi algoritm eng yaxshi?" emas. ML kursi o'sha savolga javob beradi; bu kitob undan keyingi savollarga.
Kitob nimani quradi
diagramma(
    {
        "Ma'lumot manbalari\n(Postgres, CSV, oqim)": (0, 0, 2.8, 1.1, "manba"),
        "Ma'lumot quvuri\n(sifat, versiya)": (3.6, 0, 2.6, 1.1, "qayta"),
        "Lakehouse\n(Iceberg / MinIO)": (7.0, 0, 2.6, 1.1, "saqlash"),
        "O'qitish quvuri": (3.6, 2.0, 2.6, 1.1, "qayta"),
        "Model registri\n(MLflow)": (7.0, 2.0, 2.6, 1.1, "saqlash"),
        "Inference servis\n(FastAPI + Docker)": (7.0, 4.0, 2.6, 1.1, "xizmat"),
        "CI / CD": (3.6, 4.0, 2.6, 1.1, "qayta"),
        "Kuzatuv va drift\n(Prometheus)": (0, 4.0, 2.8, 1.1, "kuzatuv"),
    },
    [
        ("Ma'lumot manbalari\n(Postgres, CSV, oqim)", "Ma'lumot quvuri\n(sifat, versiya)"),
        ("Ma'lumot quvuri\n(sifat, versiya)", "Lakehouse\n(Iceberg / MinIO)"),
        ("Ma'lumot quvuri\n(sifat, versiya)", "O'qitish quvuri"),
        ("O'qitish quvuri", "Model registri\n(MLflow)"),
        ("Model registri\n(MLflow)", "Inference servis\n(FastAPI + Docker)"),
        ("CI / CD", "Inference servis\n(FastAPI + Docker)", "deploy"),
        ("Kuzatuv va drift\n(Prometheus)", "CI / CD", "qayta o'qitish"),
    ],
    nom="kitob_arxitekturasi.png", kenglik=13,
    izoh="Kitob oxirida shu tizim to'liq ishlaydi. Har qism o'z bobida quriladi va o'lchanadi.",
)
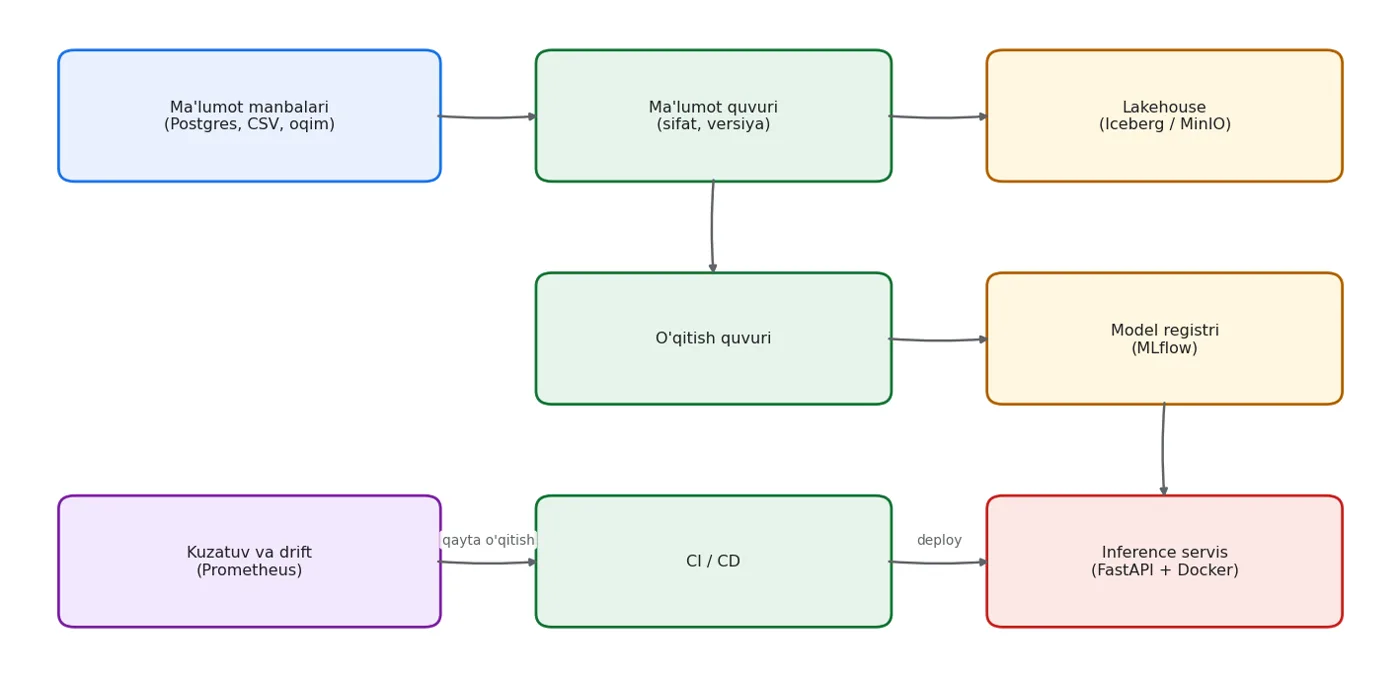
Kitob oxirida shu tizim to'liq ishlaydi. Har qism o'z bobida quriladi va o'lchanadi.
Chap tomondagi halqaga e'tibor bering: kuzatuv drift ni topadi, u qayta o'qitishni boshlaydi, natija yangi deploy bo'ladi. ML tizimi chiziq emas, halqa. Oddiy dasturda bunday halqa yo'q.
Kitob qanday tuzilgan
| Qism | Boblar | Nima haqida |
|---|---|---|
| I. Poydevor | 1–8 | Ma'lumot formatlari, versiyalash, sifat, takrorlanish, Docker |
| II. Data Engineering | 9–21 | Kafka, Spark, Iceberg, lakehouse, oqim, ombor |
| III. MLOps | 22–33 | Tajriba, registr, servis, tezlik, CI/CD |
| IV. Birlashgan | 34–39 | Kuzatuv, drift, real-time ML, loyiha |
Data Engineering qismi MLOps ning poydevori: ma'lumot sifatsiz bo'lsa, model ham sifatsiz. Lekin u bir xil narsa emas — 9-bobda farqni aniq chizamiz.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Uchlik | Kod + ma'lumot + model mustaqil o'zgaradi |
| Asosiy farq | Kod o'zgarmasa ham natija buzilishi mumkin |
| O'lchangan misol | F1 0.860 → 0.675, kod bir qator o'zgarmasdan |
| Drift imzosi | Aniqlik saqlandi (0.895→0.887), to'liqlik qulaadi (0.828→0.545) |
| Metrika tanlash | AUC atigi 0.04 tushdi va muammoni yashirdi |
| ML tizimi | Chiziq emas, halqa: kuzatuv → qayta o'qitish → deploy |
Talaba ishi
ijara_yangi.csvda chegarani 0.5 dan 0.35 ga tushiring (predict_probabilan). To'liqlik qanchaga ko'tariladi va aniqlik qanchaga tushadi? Bu drift ni "tuzatadimi"?- Modelni faqat
telefon_takrorlanishivakunlik_elonlarustunlarida o'qiting. Avgustdagi F1 qancha? Sentabrdagi-chi? Nega bu model drift ga chidamliroq? - Yangi ma'lumotning 20% ini eski ma'lumotga qo'shib, qayta o'qiting. F1 tiklandimi? Bu 35-bobdagi qayta o'qitish strategiyasining eng sodda shakli.
- AUC dan tashqari yana qaysi metrika drift ni yashirishi mumkin? Nega aniqlik yolg'iz o'zi yetarli emas?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.