Takrorlanish: bir xil natijani ikki marta olish
Onangizning oshi va sizning oshingiz
Onangizdan osh retseptini so'radingiz. U aytdi: bir kilo guruch, yarim kilo go'sht, ikki bosh piyoz, bir soat.
Yozib oldingiz. Aynan shunday qildingiz.
Chiqmadi.
Retsept xato emas edi. Siz ham xato qilmadingiz. Lekin onangizning qozoni boshqa, gazi boshqacha yonadi, guruchni boshqa do'kondan oladi, va "bir soat" deganda u aslida pishib bo'lganiga qarab o'chiradi.
Retseptda yozilmagan narsalar retseptda yozilganlardan ko'p edi.
Xuddi shu narsa modelda
Hamkasbingiz sizga model fayli berdi va "F1 0.86" dedi. Siz uning kodini olasiz, ishga tushirasiz — va 0.84 chiqasiz.
Kod bir xil. Fayl bir xil. Natija boshqa.
Endi boshlanadi eng yoqimsiz suhbat:
— Menda 0.86 chiqadi. — Menda 0.84. — Demak siz nimanidir noto'g'ri qilgansiz. — Yoki siz.
Va bu suhbatning hech qanday yechimi yo'q, chunki ikkalangizda ham dalil yo'q. Qaysi raqamni hisobotga yozasiz? Ertaga modelni yaxshilasangiz, 0.87 chiqsa — bu yaxshilanishmi yoki shunchaki yana bir tasodifmi?
Taqqoslash uchun mustahkam nuqta kerak. Usiz siz model yaxshilayotganingizni bilolmaysiz — siz faqat raqamlar o'zgarayotganini ko'rasiz.
Takrorlanish nima va nega u birinchi
Takrorlanish (reproducibility) — bu shunchaki: bir xil kirish bersangiz, bir xil chiqish olasiz. Har safar. Har mashinada.
Bu MLOps ning birinchi g'ishti va tartib tasodifiy emas. O'ylab ko'ring:
- Model yaxshilandimi? — Taqqoslash kerak. Takrorlanish bo'lmasa, taqqoslab bo'lmaydi.
- Nega buzildi? — Eski holatni qayta tiklash kerak. Takrorlanish bo'lmasa, tiklab bo'lmaydi.
- Bu xato menda ham chiqadimi? — Qayta ishlab chiqarish kerak. Takrorlanish bo'lmasa...
Har savol o'sha devorga urilib qaytadi. Shuning uchun bu bob ikkinchi o'rinda turibdi, va qolgan 25 bob uning ustiga quriladi.
Bizning vazifamiz — onangizning retseptiga yozilmagan narsalarni ham yozib qo'yish.
Nima uchun natija o'zgaradi
Ko'pchilik "kod bir xil — natija bir xil" deb o'ylaydi. ML da beshta narsa natijaga ta'sir qiladi:
diagramma(
    {
        "Tasodifiy son\n(seed)": (0, 0, 2.3, 1.0, "manba"),
        "Ma'lumot\n(qaysi versiya)": (2.9, 0, 2.3, 1.0, "manba"),
        "Kutubxona\n(versiya)": (5.8, 0, 2.3, 1.0, "manba"),
        "Apparat\n(CPU/GPU, oqimlar)": (8.7, 0, 2.3, 1.0, "manba"),
        "NATIJA\n(model va metrika)": (4.35, 2.2, 2.3, 1.0, "xizmat"),
    },
    [
        ("Tasodifiy son\n(seed)", "NATIJA\n(model va metrika)"),
        ("Ma'lumot\n(qaysi versiya)", "NATIJA\n(model va metrika)"),
        ("Kutubxona\n(versiya)", "NATIJA\n(model va metrika)"),
        ("Apparat\n(CPU/GPU, oqimlar)", "NATIJA\n(model va metrika)"),
    ],
    nom="takrorlanish_omillari.png", kenglik=12,
    izoh="To'rt manba natijani o'zgartiradi. Ularning har birini qulflash kerak.",
)
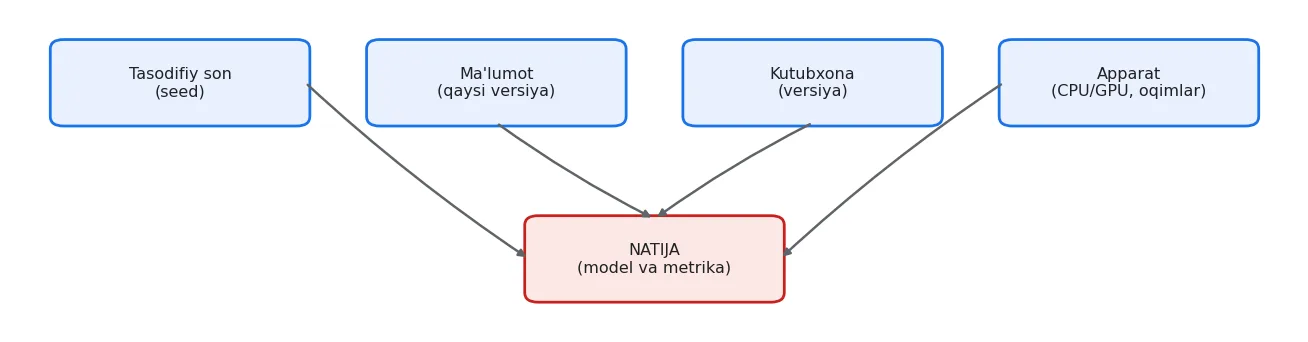
To'rt manba natijani o'zgartiradi. Ularning har birini qulflash kerak.
Birma-bir ko'rib chiqamiz — va har birini o'lchaymiz.
1. Tasodifiy son (seed)
ML algoritmlari tasodifiylikka tayanadi: ma'lumotni bo'lish, daraxt uchun ustun tanlash, vaznlarni boshlash. Seed bermasangiz, har ishga tushirishda boshqa tasodifiy sonlar ishlatiladi.
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import f1_score

d = pd.read_csv(DATA / "ijara.csv")
XUS = ["xonalar", "maydon", "qavat", "jami_qavat", "narx_mln", "tavsif_uzunligi",
       "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar", "egasi_tasdiqlangan"]
X, y = d[XUS], d["broker"]

print("SEEDSIZ — uch marta ishga tushiramiz:")
natijalar = []
for i in range(3):
    Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.25, stratify=y)   # random_state YO'Q
    m = RandomForestClassifier(n_estimators=60, min_samples_leaf=3, n_jobs=1).fit(Xtr, ytr)
    f1 = f1_score(yte, m.predict(Xte))
    natijalar.append(f1)
    print(f"  {i + 1}-urinish: F1 = {f1:.4f}")
print(f"  eng katta farq: {max(natijalar) - min(natijalar):.4f}")
SEEDSIZ — uch marta ishga tushiramiz:
  1-urinish: F1 = 0.8753
  2-urinish: F1 = 0.8786
  3-urinish: F1 = 0.8702
  eng katta farq: 0.0084
Uch marta bir xil kod, uch xil natija.
Nima bo'ldi? Kod train_test_split ni chaqirdi va u ma'lumotni tasodifiy ikkiga bo'ldi.
Har safar boshqacha bo'ldi — demak model har safar boshqa qatorlarda o'qidi va boshqa
qatorlarda sinaldi.
Farq kichik ko'rinadi. Lekin mana nega bu halokatli:
Tasavvur qiling, modelni yaxshilash ustida ishlayapsiz. Yangi xususiyat qo'shdingiz, qayta o'qitdingiz, F1 0.004 ga oshdi. Xursandsiz — yaxshilanish!
Lekin yuqoridagi natijaga qarang: hech narsa qilmasdan ham farq shuncha chiqdi.
Demak sizning "yaxshilanishingiz" yaxshilanish emas, balki shovqin bo'lishi mumkin. Siz esa buni bilmaysiz va o'sha "foydali" xususiyatni kodda qoldirasiz. Bir yildan keyin loyihada o'nlab shunday xususiyat bo'ladi — har biri hech narsa qilmaydi, lekin hech kim ularni olib tashlashga jur'at etmaydi.
Endi seed bilan:
print("SEED BILAN — uch marta:")
natijalar = []
for i in range(3):
    Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.25, stratify=y, random_state=42)
    m = RandomForestClassifier(n_estimators=60, min_samples_leaf=3,
                               random_state=42, n_jobs=1).fit(Xtr, ytr)
    f1 = f1_score(yte, m.predict(Xte))
    natijalar.append(f1)
    print(f"  {i + 1}-urinish: F1 = {f1:.10f}")
print(f"  hammasi bir xilmi: {len(set(natijalar)) == 1}")
SEED BILAN — uch marta:
  1-urinish: F1 = 0.8617332035
  2-urinish: F1 = 0.8617332035
  3-urinish: F1 = 0.8617332035
  hammasi bir xilmi: True
Endi o'ninchi kasrgacha bir xil.
Seed nima qildi? Kompyuterdagi "tasodifiy" sonlar aslida tasodifiy emas — ular formula bilan hisoblanadi. Formula boshlang'ich songa muhtoj, va o'sha son seed (urug') deb ataladi.
Seed bermasangiz, kompyuter uni soatdan oladi — shuning uchun har safar boshqacha. Seed bersangiz, formula har safar aynan o'sha ketma-ketlikni ishlab chiqaradi.
Ya'ni random_state=42 degani "tasodifiylikni o'chir" emas. U "o'sha tasodifiylikni
qayta ishlat" degani. Bo'linish baribir aralash bo'ladi — faqat har safar bir xil aralash.
42 sehrli son emas
Ko'p kodda random_state=42 uchraydi va yangi o'rganuvchilar bu sonda ma'no bor deb
o'ylaydi.
Yo'q. Bu shunchaki hazil — Duglas Adamsning kitobidagi "hayot, olam va hamma narsaning
javobi". random_state=7 yoki random_state=12345 ham xuddi shunday ishlaydi.
Muhimi qiymat emas, balki uning o'zgarmasligi.
Ikki joyda seed kerak
Yuqoridagi kodda random_state=42 ikki marta yozilgan: train_test_split da va
RandomForestClassifier da. Bittasini unutsangiz, natija baribir o'zgaradi.
Umumiy qoida: tasodifiylik ishlatadigan har bir obyektga seed bering. Kutubxonalarda bu odatda
random_state, seed yoki random_seed deb ataladi.
Seed yetarli emas: global tasodifiylik
numpy va Python ning o'z tasodifiy generatorlari ham bor. Ular kutubxona ichida ishlatilishi mumkin:
import random
import numpy as np

def urinish():
    return round(random.random(), 4), round(float(np.random.random()), 4)

print("seedsiz:", urinish(), urinish())
random.seed(42); np.random.seed(42)
a = urinish()
random.seed(42); np.random.seed(42)
b = urinish()
print("seed bilan:", a, b, "| bir xil:", a == b)
seedsiz: (0.7693, 0.1608) (0.5368, 0.9481)
seed bilan: (0.6394, 0.3745) (0.6394, 0.3745) | bir xil: True
Shuning uchun o'qitish skriptining boshida hamma generatorni qulflash kerak. Buni bitta funksiyaga yig'amiz — kitob davomida shuni ishlatamiz:
shu faylni yaratingsrc/quvur/takrorlanish.py
"""Takrorlanishni ta'minlash: hamma tasodifiy generatorni qulflash."""
import os
import random

import numpy as np


def seedni_qulfla(seed: int = 42) -> None:
    """Python, numpy va (agar bor bo'lsa) PyTorch generatorlarini qulflaydi.

    PYTHONHASHSEED ham muhim: usiz to'plam (set) va lug'at tartibi
    ishga tushirishlar orasida o'zgarishi mumkin.
    """
    os.environ["PYTHONHASHSEED"] = str(seed)
    random.seed(seed)
    np.random.seed(seed)
    try:
        import torch
        torch.manual_seed(seed)
        torch.cuda.manual_seed_all(seed)
        torch.use_deterministic_algorithms(True, warn_only=True)
    except ImportError:
        pass
python3 -c "
import sys; sys.path.insert(0, 'src')
from quvur.takrorlanish import seedni_qulfla
import random, numpy as np
seedni_qulfla(42); a = (random.random(), float(np.random.random()))
seedni_qulfla(42); b = (random.random(), float(np.random.random()))
print('bir xil natija:', a == b)
print('qiymatlar:', tuple(round(x, 6) for x in a))
"
bir xil natija: True
qiymatlar: (0.639427, 0.37454)
2. Ma'lumot qaysi versiya edi
Seed qulflandi, lekin ma'lumot o'zgargan bo'lsa, natija baribir boshqacha bo'ladi. Va eng yomoni — buni sezmaysiz, chunki fayl nomi o'sha.
Yechim: faylning barmoq izini (hash) olish. Bitta bayt o'zgarsa, hash butunlay o'zgaradi.
import hashlib

def fayl_hash(yol, blok=1 << 20):
    """Faylning SHA-256 barmoq izi. Katta fayllar uchun bo'lak-bo'lak o'qiydi."""
    h = hashlib.sha256()
    with open(yol, "rb") as f:
        while chunk := f.read(blok):
            h.update(chunk)
    return h.hexdigest()

for nom in ["ijara.csv", "ijara_yangi.csv"]:
    yol = DATA / nom
    print(f"  {nom:18} {fayl_hash(yol)[:16]}...  {yol.stat().st_size // 1024} KB")
  ijara.csv          03dbeed95e47e74c...  704 KB
  ijara_yangi.csv    1265eaff262ea8e0...  235 KB
Bitta bayt o'zgarsa nima bo'lishini ko'rsatamiz:
import shutil, hashlib
from pathlib import Path

vaqtinchalik = ISH / "hash_sinov"
vaqtinchalik.mkdir(parents=True, exist_ok=True)
asl = vaqtinchalik / "a.csv"
asl.write_text("ism,baho\nAziz,85\nBobur,90\n", encoding="utf-8")
nusxa = vaqtinchalik / "b.csv"
nusxa.write_text("ism,baho\nAziz,85\nBobur,91\n", encoding="utf-8")   # bitta raqam

h1, h2 = fayl_hash(asl), fayl_hash(nusxa)
print("asl :", h1)
print("o'zg.:", h2)
print("farq qiladigan belgilar soni:", sum(a != b for a, b in zip(h1, h2)), "/ 64")
shutil.rmtree(vaqtinchalik)
asl : 025d74eb1917770a089833b9e7598b2a6f6c2a5f8b1eba2fbd4115cfd8594b76
o'zg.: df39468d130cf83a184650d6dd680a42501f9c4a2ee6de0baee809a1f8016add
farq qiladigan belgilar soni: 60 / 64
Bitta raqam o'zgardi — hash ning yarmidan ko'pi o'zgardi. Bu ataylab shunday: hash "biroz o'xshash" degan tushunchani bilmaydi, faqat "bir xil" yoki "boshqa".
3. Kutubxona versiyalari
import sys, sklearn, numpy, pandas, platform
import pandas as pd
show(pd.DataFrame([
    {"komponent": "Python", "versiya": sys.version.split()[0]},
    {"komponent": "scikit-learn", "versiya": sklearn.__version__},
    {"komponent": "numpy", "versiya": numpy.__version__},
    {"komponent": "pandas", "versiya": pandas.__version__},
    {"komponent": "OS", "versiya": platform.system() + " " + platform.machine()},
]))
| komponent | versiya |
|---|---|
| Python | 3.10.12 |
| scikit-learn | 1.7.2 |
| numpy | 2.2.6 |
| pandas | 2.3.3 |
| OS | Linux x86_64 |
Nega bu muhim: scikit-learn 1.3 va 1.7 bir xil kodda boshqa natija berishi mumkin — standart
parametrlar o'zgaradi, algoritm yaxshilanadi, xatolar tuzatiladi. Versiyani yozib qo'ymasangiz, olti
oydan keyin natijani takrorlay olmaysiz.
2-kitobdagi (Python muhandisligi) qoida shu yerda ham ishlaydi: qulf fayli (pip freeze).
4. Apparat va oqimlar
Seed qulflandi, ma'lumot o'sha, kutubxona o'sha. Endi parallellik ni sinaymiz — bu eng kam kutilgan manba.
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier

Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.25, stratify=y, random_state=42)

qatorlar = []
for oqim in (1, 4, -1):
    ehtimollar, f1lar = [], []
    for _ in range(3):
        m = RandomForestClassifier(n_estimators=60, min_samples_leaf=3,
                                   random_state=42, n_jobs=oqim).fit(Xtr, ytr)
        ehtimollar.append(m.predict_proba(Xte)[:, 1])
        f1lar.append(f1_score(yte, m.predict(Xte)))
    eng_katta_farq = max(np.abs(ehtimollar[0] - ehtimollar[i]).max() for i in (1, 2))
    qatorlar.append({
        "n_jobs": oqim,
        "ehtimolda eng katta farq": f"{eng_katta_farq:.2e}",
        "F1 bir xilmi": len(set(f1lar)) == 1,
        "F1": round(f1lar[0], 10),
    })
show(pd.DataFrame(qatorlar))
print("CPU yadrolari:", __import__("os").cpu_count())
CPU yadrolari: 8
| n_jobs | ehtimolda eng katta farq | F1 bir xilmi | F1 |
|---|---|---|---|
| 1 | 0.00e+00 | True | 0.862 |
| 4 | 2.22e-16 | True | 0.862 |
| -1 | 2.22e-16 | True | 0.862 |
Jadval nozik, lekin muhim narsani ko'rsatadi.
n_jobs=1 bilan natija bit-ma-bit bir xil: farq 0.00e+00.
Ko'p oqim bilan farq bor: 10⁻¹⁶ tartibida. Bu tasodifiy son emas — bu float64 ning eng
kichik qadami (bir-ikki ULP), va aniq qiymati ishga tushirishdan ishga tushirishga o'zgaradi.
Sabab: oqimlar tugaganda natijalar turli tartibda qo'shiladi, suzuvchi nuqta qo'shishi esa
tartibga bog'liq:
a = 0.1 + (0.2 + 0.3)
b = (0.1 + 0.2) + 0.3
print(f"0.1 + (0.2 + 0.3) = {a!r}")
print(f"(0.1 + 0.2) + 0.3 = {b!r}")
print("teng emas:", a != b, "| farq:", abs(a - b))
0.1 + (0.2 + 0.3) = 0.6
(0.1 + 0.2) + 0.3 = 0.6000000000000001
teng emas: True | farq: 1.1102230246251565e-16
Matematikada qo'shish tartibi ahamiyatsiz; kompyuterda esa yo'q.
Lekin F1 uchala holatda ham bir xil chiqdi. Nega? Chunki 10⁻¹⁶ farq hech bir ehtimolni
0.5 chegarasidan o'tkaza olmadi — ehtimollar chegaradan ancha uzoqda edi.
"Odatda ta'sir qilmaydi" — bu kafolat emas
Yuqoridagi natija shu ma'lumot va shu model uchun to'g'ri. Lekin bir ehtimol aynan 0.5000000000
bo'lsa, 10⁻¹⁶ farq uni ikkinchi tomonga o'tkazadi va bashorat o'zgaradi.
Bundan tashqari: model faylini hash bilan solishtirsangiz, ko'p oqimli va bir oqimli modellar boshqa hash beradi — mazmunan bir xil bo'lsa ham.
Amaliy qoida:
- Metrikani taqqoslayotgan bo'lsangiz — n_jobs=-1 bemalol, tez.
- Bit-ma-bit takrorlanish kerak bo'lsa (audit, sertifikatlash, model hash) — n_jobs=1.
- GPU dagi neyron tarmoqlarda farq ancha kattaroq; PyTorch da
torch.use_deterministic_algorithms(True) kerak — u sekinroq, lekin aniq.
Hammasini bitta joyga: yugurish pasporti
Endi yuqoridagi to'rttasini bitta faylga yozamiz. Har o'qitish shunday "pasport" qoldirsin:
shu faylni yaratingsrc/quvur/pasport.py
"""Har o'qitish uchun takrorlanish pasporti."""
import hashlib
import json
import platform
import subprocess
import sys
from datetime import datetime, timezone
from pathlib import Path
from typing import Any


def fayl_hash(yol: str | Path, blok: int = 1 << 20) -> str:
    h = hashlib.sha256()
    with open(yol, "rb") as f:
        while chunk := f.read(blok):
            h.update(chunk)
    return h.hexdigest()


def git_holati() -> dict[str, str]:
    """Joriy commit va ish daraxti toza yoki yo'qligini qaytaradi."""
    def buyruq(*a: str) -> str:
        try:
            return subprocess.run(a, capture_output=True, text=True, timeout=10).stdout.strip()
        except (OSError, subprocess.SubprocessError):
            return ""
    commit = buyruq("git", "rev-parse", "HEAD")
    ozgargan = buyruq("git", "status", "--porcelain")
    return {"commit": commit or "(git yo'q)", "toza": "ha" if commit and not ozgargan else "yo'q"}


def pasport(malumot_yoli: str | Path, parametrlar: dict[str, Any],
            metrikalar: dict[str, float], seed: int) -> dict[str, Any]:
    """O'qitishni qayta takrorlash uchun kerak bo'ladigan HAMMA narsa."""
    import numpy
    import pandas
    import sklearn
    return {
        "vaqt": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "seed": seed,
        "malumot": {"yol": str(malumot_yoli), "sha256": fayl_hash(malumot_yoli),
                    "hajm_bayt": Path(malumot_yoli).stat().st_size},
        "kod": git_holati(),
        "muhit": {
            "python": sys.version.split()[0],
            "sklearn": sklearn.__version__,
            "numpy": numpy.__version__,
            "pandas": pandas.__version__,
            "platforma": f"{platform.system()} {platform.machine()}",
        },
        "parametrlar": parametrlar,
        "metrikalar": metrikalar,
    }


def saqla(p: dict[str, Any], yol: str | Path) -> None:
    Path(yol).write_text(json.dumps(p, ensure_ascii=False, indent=2), encoding="utf-8")
Ishlatib ko'ramiz:
shu faylni yaratingoqit_pasport.py
"""Pasport bilan o'qitish namunasi."""
import sys
sys.path.insert(0, "src")

import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import f1_score, precision_score, recall_score

from quvur.pasport import pasport, saqla
from quvur.takrorlanish import seedni_qulfla

SEED = 42
MALUMOT = "../datasets/ijara.csv"
XUS = ["xonalar", "maydon", "qavat", "jami_qavat", "narx_mln", "tavsif_uzunligi",
       "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar", "egasi_tasdiqlangan"]
PARAM = {"n_estimators": 150, "min_samples_leaf": 3}

seedni_qulfla(SEED)
d = pd.read_csv(MALUMOT)
Xtr, Xte, ytr, yte = train_test_split(d[XUS], d["broker"], test_size=0.25,
                                      stratify=d["broker"], random_state=SEED)
m = RandomForestClassifier(**PARAM, random_state=SEED, n_jobs=-1).fit(Xtr, ytr)
p = m.predict(Xte)

metrikalar = {
    "f1": round(f1_score(yte, p), 4),
    "aniqlik": round(precision_score(yte, p), 4),
    "toliqlik": round(recall_score(yte, p), 4),
}
saqla(pasport(MALUMOT, PARAM, metrikalar, SEED), "pasport.json")
print("metrikalar:", metrikalar)
python3 oqit_pasport.py
echo "--- pasport.json ---"
cat pasport.json
metrikalar: {'f1': 0.8603, 'aniqlik': 0.8947, 'toliqlik': 0.8285}
--- pasport.json ---
{
  "vaqt": "2026-09-29T13:29:06+00:00",
  "seed": 42,
  "malumot": {
    "yol": "../datasets/ijara.csv",
    "sha256": "03dbeed95e47e74cc03b7d67fc0c109f3ae77bdf9e9dbbe02614b5d8f937e304",
    "hajm_bayt": 721774
  },
  "kod": {
    "commit": "(git yo'q)",
    "toza": "yo'q"
  },
  "muhit": {
    "python": "3.10.12",
    "sklearn": "1.7.2",
    "numpy": "2.2.6",
    "pandas": "2.3.3",
    "platforma": "Linux x86_64"
  },
  "parametrlar": {
    "n_estimators": 150,
    "min_samples_leaf": 3
  },
  "metrikalar": {
    "f1": 0.8603,
    "aniqlik": 0.8947,
    "toliqlik": 0.8285
  }
}
Pasport nimani hal qiladi
Endi savollarga javob bor:
import pandas as pd
show(pd.DataFrame([
    {"savol": "Qaysi ma'lumotda o'qitilgan?", "pasportdagi maydon": "malumot.sha256"},
    {"savol": "Kod qaysi holatda edi?", "pasportdagi maydon": "kod.commit"},
    {"savol": "Saqlanmagan o'zgarish bormidi?", "pasportdagi maydon": "kod.toza"},
    {"savol": "Qaysi kutubxona versiyasi?", "pasportdagi maydon": "muhit.*"},
    {"savol": "Qanday parametrlar bilan?", "pasportdagi maydon": "parametrlar"},
    {"savol": "Natija qanday bo'lgan?", "pasportdagi maydon": "metrikalar"},
]))
| savol | pasportdagi maydon |
|---|---|
| Qaysi ma'lumotda o'qitilgan? | malumot.sha256 |
| Kod qaysi holatda edi? | kod.commit |
| Saqlanmagan o'zgarish bormidi? | kod.toza |
| Qaysi kutubxona versiyasi? | muhit.* |
| Qanday parametrlar bilan? | parametrlar |
| Natija qanday bo'lgan? | metrikalar |
kod.toza maydoni alohida qimmatli. U yo'q bo'lsa — o'qitish paytida saqlanmagan o'zgarishlar
bor edi, demak o'sha commit ni olib ham natijani takrorlay olmaysiz. Bu eng ko'p uchraydigan
takrorlanmaslik sababi.
Yuqoridagi chiqishda commit qiymati (git yo'q) — chunki kitob kodni vaqtinchalik papkada
bajaradi va u git omborida emas. O'z loyihangizda u haqiqiy commit hash ini ko'rsatadi. toza
maydoni esa ehtiyotkorlik uchun yo'q deb qaytaradi: git holatini bilmasak, "toza" deb da'vo
qilmaganimiz to'g'riroq.
Takrorlanish — bepul emas
Seed qulflash ba'zan modelni sekinlashtiradi (GPU da determinizm), va pasport yozish qo'shimcha kod. Lekin narxi kichik: bir necha qator. Uning o'rniga siz "bu raqam qayerdan keldi?" degan savolga har doim javob bera olasiz.
Muhim istisno: takrorlanish yaxshi model degani emas. U faqat "bir xil natija" degani. Yomon modelni ham mukammal takrorlash mumkin.
Takrorlanishning uch darajasi
import pandas as pd
show(pd.DataFrame([
    {"daraja": "1. Bir xil mashinada", "nima kerak": "Seed + ma'lumot hash",
     "qiyinligi": "oson", "bu kitobda": "2-bob"},
    {"daraja": "2. Boshqa mashinada", "nima kerak": "+ kutubxona qulfi (lock)",
     "qiyinligi": "o'rtacha", "bu kitobda": "7-bob (Docker)"},
    {"daraja": "3. Olti oydan keyin", "nima kerak": "+ ma'lumot arxivi, konteyner image",
     "qiyinligi": "qiyin", "bu kitobda": "4, 7, 23-boblar"},
]))
| daraja | nima kerak | qiyinligi | bu kitobda |
|---|---|---|---|
| 1. Bir xil mashinada | Seed + ma'lumot hash | oson | 2-bob |
| 2. Boshqa mashinada | + kutubxona qulfi (lock) | o'rtacha | 7-bob (Docker) |
| 3. Olti oydan keyin | + ma'lumot arxivi, konteyner image | qiyin | 4, 7, 23-boblar |
Ko'p jamoa 1-darajada to'xtaydi va "bizda takrorlanish bor" deb o'ylaydi. Haqiqiy sinov — olti oydan keyin o'sha natijani qayta olish.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Seedsiz | Bir xil kod har safar boshqa natija beradi |
| Seed qayerda | Tasodifiylik ishlatadigan har obyektda; global generatorlar ham |
PYTHONHASHSEED |
Usiz to'plam va lug'at tartibi o'zgarishi mumkin |
| Ma'lumot hash | Bitta bayt o'zgarsa, hash yarmidan ko'pi o'zgaradi |
| Kutubxona versiyasi | sklearn 1.3 va 1.7 boshqa natija berishi mumkin |
kod.toza |
Saqlanmagan o'zgarish — eng ko'p uchraydigan takrorlanmaslik sababi |
| Parallellik | n_jobs>1 ehtimolni 10⁻¹⁶ tartibida o'zgartiradi (float qo'shish tartibi) |
| Bit-ma-bit kerakmi | Metrika uchun yo'q; audit va model hash uchun n_jobs=1 |
| Pasport | Ma'lumot + kod + muhit + parametr + metrika bitta JSON da |
| Chegara | Takrorlanish "yaxshi model" degani emas |
Talaba ishi
oqit_pasport.pyni ikki marta ishga tushiring va ikkipasport.jsonni solishtiring. Qaysi maydonlar o'zgardi? Ular o'zgarishi kerakmidi?datasets/ijara.csvga bitta bo'sh qator qo'shing va pasportni qayta yasang. Qaysi maydon o'zgarganini ko'rsating.seedni_qulfladagiPYTHONHASHSEEDqatorini olib tashlang. Farqni sezish uchun qanday test yozish mumkin? (Maslahat:setustidan aylanib chiqing.)- Pasportga model faylining hash ini ham qo'shing. Bu nimani tekshirishga imkon beradi?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.