O'qitish: qurilish maydonida kaska va jilet
Bu bobning kodi: kod/07_oqitish.py — kitob papkasidan ishga tushiring: python kod/07_oqitish.py
Vazifa
Qurilish maydonida ishchi kaskasiz yoki signal jiletisiz yurmasligi kerak. Hozir buni prorab ko'zi bilan kuzatadi. Kamera va detector buni kechayu kunduz qila oladi: "3-kamera, 14:07, kaskasiz odam". Bu — IV qismda sotishni o'rganadigan mahsulotlardan biri. Bu bobda uning yuragini — detector ni o'zimiz o'qitamiz.
COCO da "kaska" degan sinf yo'q. Demak tayyor yolo11n bu vazifani bilmaydi va uni yangi dataset da o'qitish kerak. Bobning rejasi:
- Dataset ni yuklab olish va tekshirish.
- Ikki tajriba: COCO da o'qitilgan vaznlardan boshlash va noldan boshlash.
- Natijalarni o'qish: precision, recall, AP, mAP — formulalari va noldan yozilgan kodi bilan.
Dataset
Ultralytics ning Construction-PPE dataseti (PPE — shaxsiy himoya vositalari): 1 132 o'qitish, 143 validatsiya va 141 test rasmi, 11 sinf. Yuklab olish (bir marta, ~178 MB):
# Construction-PPE (7-bob): 1 416 rasm, ~178 MB
if not Path("datasets/construction-ppe").exists():
    download("https://github.com/ultralytics/assets/releases/download/v0.0.0/construction-ppe.zip", dir=Path("datasets"), delete=True)
Datasetning data.yaml fayli path: construction-ppe deydi, ultralytics esa nisbiy yo'lni o'zining sozlamalaridagi papkaga bog'laydi. O'z nusxamizni yozamiz, yo'lni kitob papkasiga qaratib:
import time
from collections import Counter
from pathlib import Path

import cv2
import numpy as np
import pandas as pd
import torch
import torchvision
import yaml
import matplotlib.pyplot as plt
from ultralytics import YOLO
from ultralytics.utils import LOGGER
from ultralytics.utils.metrics import ap_per_class

LOGGER.setLevel("ERROR")

ds = Path("datasets/construction-ppe")
tavsif = yaml.safe_load((ds / "data.yaml").read_text())
tavsif["path"] = str(ds)
tavsif.pop("download", None)
Path("datasets/ppe.yaml").write_text(yaml.safe_dump(tavsif, allow_unicode=True, sort_keys=False))
nomlar = tavsif["names"]
print("sinflar:", nomlar)
print("litsenziya:", (ds / "LICENSE").read_text().splitlines()[0].strip())
sinflar: {0: 'helmet', 1: 'gloves', 2: 'vest', 3: 'boots', 4: 'goggles', 5: 'none', 6: 'Person', 7: 'no_helmet', 8: 'no_goggle', 9: 'no_gloves', 10: 'no_boots'}
litsenziya: GNU AFFERO GENERAL PUBLIC LICENSE
Dataset ham, ultralytics kodi ham AGPL-3.0. Unda o'qitilgan modelni sotishdan oldin IV qismdagi litsenziya bobini o'qing.
Dataset ni tekshirish
O'qitishdan oldin har doim dataset ni o'z ko'zingiz bilan tekshiring. Birinchi savol: har bir label faylga rasm bormi va aksincha?
for qism in ("train", "val", "test"):
    rasmlar = {p.stem for p in (ds / "images" / qism).iterdir()}
    labellar = {p.stem for p in (ds / "labels" / qism).iterdir() if p.suffix == ".txt"}
    print(f"{qism:5s}: {len(rasmlar)} rasm, {len(labellar)} label | rasmsiz label: {sorted(labellar - rasmlar)[:4]}"
          f"{' ...' if len(labellar - rasmlar) > 4 else ''} ({len(labellar - rasmlar)} ta) | labelsiz rasm: {len(rasmlar - labellar)}")
train: 1132 rasm, 1142 label | rasmsiz label: ['image940(1)', 'image941(1)', 'image944(1)', 'image945(1)'] ... (10 ta) | labelsiz rasm: 0
val  : 143 rasm, 143 label | rasmsiz label: [] (0 ta) | labelsiz rasm: 0
test : 141 rasm, 141 label | rasmsiz label: [] (0 ta) | labelsiz rasm: 0
O'qitish qismida 10 ta "yetim" label bor: image949(1).txt kabi nomlar — kimdir faylni ikki marta nusxalagan. Ultralytics ularni jimgina e'tiborsiz qoldiradi (rasmi yo'q), shuning uchun zarar yo'q. Lekin bu datasetni kim va qanday tayyorlaganini eslatib turadi: tayyor dataset ham xatosiz emas.
Ikkinchi savol: sinflar qanchalik teng taqsimlangan?
def sanash(qism):
    c = Counter()
    for f in (ds / "labels" / qism).glob("*.txt"):
        c.update(int(q.split()[0]) for q in f.read_text().splitlines() if q.strip())
    return c

sanoq = {q: sanash(q) for q in ("train", "val", "test")}
show(pd.DataFrame([{"sinf": nomlar[k], **{q: sanoq[q][k] for q in sanoq}} for k in range(len(nomlar))]), 11)
| sinf | train | val | test |
|---|---|---|---|
| helmet | 1 357 | 201 | 192 |
| gloves | 1 162 | 136 | 163 |
| vest | 1 283 | 171 | 178 |
| boots | 1 251 | 151 | 211 |
| goggles | 427 | 47 | 52 |
| none | 654 | 81 | 65 |
| Person | 1 790 | 239 | 236 |
| no_helmet | 400 | 45 | 40 |
| no_goggle | 337 | 41 | 33 |
| no_gloves | 442 | 56 | 58 |
| no_boots | 88 | 4 | 23 |
no_boots (botinkasiz) o'qitishda 88 ta, validatsiyada atigi 4 ta. 4 ta misol bo'yicha o'lchangan aniqlikka ishonib bo'lmaydi: bitta to'g'ri yoki noto'g'ri topilgan box natijani 25% ga o'zgartiradi. Real loyihada bunday sinfga ko'proq rasm yig'iladi. none sinfi dataset hujjatida aniq izohlanmagan. Pastdagi namunalarga qaraganda, u jilet kiyilmagan tanaga qo'yilgan — ya'ni aslida "jiletsiz" degani. Sinf nomi noaniq bo'lsa, rasmlarni ochib ko'rishdan boshqa yo'l yo'q.
Uchinchisi: obyektlar qanchalik kichik? 1-bobda ko'rdik, kichik obyekt — qiyin obyekt.
olcham = []
for f in (ds / "labels" / "train").glob("*.txt"):
    for q in f.read_text().splitlines():
        if q.strip():
            _, _, _, w, h = map(float, q.split())
            olcham.append(max(w, h) * 640)                      # 640 li kirishdagi uzun tomon, px
olcham = np.array(olcham)
for chegara in (16, 32, 64, 128):
    print(f"uzun tomoni {chegara:3d} px dan kichik: {(olcham < chegara).mean() * 100:5.1f}%")
uzun tomoni  16 px dan kichik:   0.2%
uzun tomoni  32 px dan kichik:   3.2%
uzun tomoni  64 px dan kichik:  23.6%
uzun tomoni 128 px dan kichik:  57.4%
Bir nechta rasmni label lari bilan ko'raylik:
ranglar = plt.cm.tab20(np.linspace(0, 1, len(nomlar)))
_, axes = plt.subplots(1, 3, figsize=(12, 4.4))
for ax, yol in zip(axes, sorted((ds / "images" / "train").iterdir())[::377][:3]):
    rasm = cv2.imread(str(yol))[:, :, ::-1]
    H, W = rasm.shape[:2]
    ax.imshow(rasm)
    for q in (ds / "labels" / "train" / f"{yol.stem}.txt").read_text().splitlines():
        k, xc, yc, w, h = map(float, q.split())
        ax.add_patch(plt.Rectangle(((xc - w / 2) * W, (yc - h / 2) * H), w * W, h * H, fill=False, color=ranglar[int(k)], lw=1.5))
        ax.text((xc - w / 2) * W, (yc - h / 2) * H, nomlar[int(k)], color="white", fontsize=7,
                bbox=dict(fc=ranglar[int(k)], ec="none", pad=1))
    ax.set_title(yol.name, fontsize=9)
    ax.axis("off")
fig("ppe_namunalar.png", "O'qitish qismidan uchta rasm va ularning label lari.")
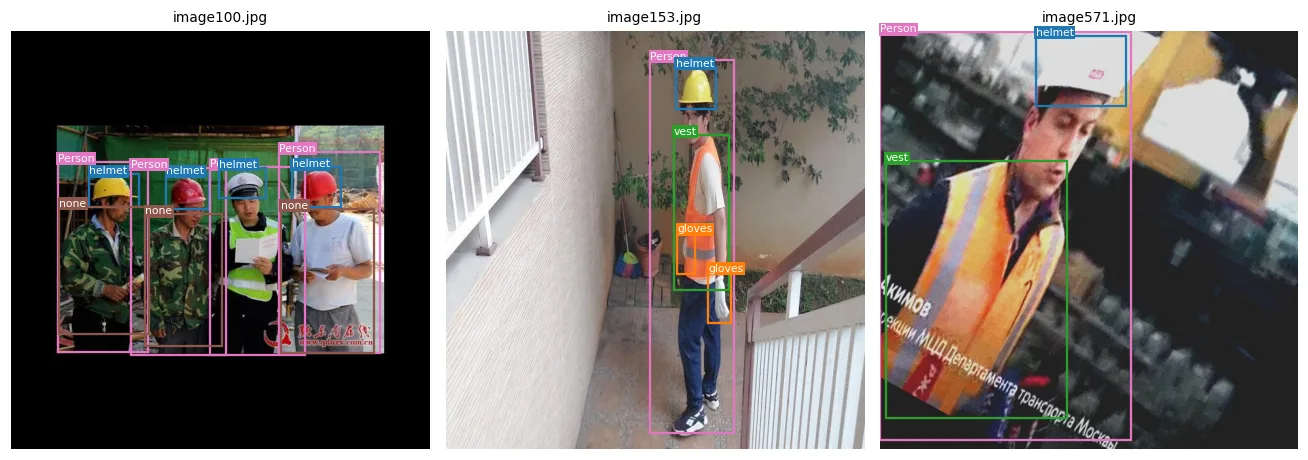
O'qitish qismidan uchta rasm va ularning label lari.
O'z datasetingizni belgilash
Bu dataset tayyor. Real mijozda esa ko'pincha o'zingiz belgilaysiz: uning kameralari, uning ob-havosi, uning kiyim rangi. Belgilash uchun keng tarqalgan ikki bepul dastur: CVAT (MIT litsenziyasi) va Label Studio (Apache-2.0). Ikkalasi ham o'z serveringizga o'rnatiladi va YOLO formatida (1-bobdagi .txt) eksport qiladi. Qoidalar oddiy, lekin buzilsa model yomon o'qiydi:
- Har bir rasmda hamma obyektni belgilang. Belgilanmagan kaska model uchun "fon" bo'lib qoladi va u kaskani topmaslikka o'rgatiladi.
- Box ni obyektga zich chizing. 1-bobdagi IoU formulasini eslang: kichik obyektda 3–4 px xato ham ko'p.
- Sinflarni oldindan aniq yozib qo'ying ("yarim ko'ringan kaska — helmet mi?") va hamma belgilovchi shunga amal qilsin.
- Qiyin rasmlarni ham qo'shing: tun, yomg'ir, uzoqdagi odam, kaskaga o'xshash narsalar.
Augmentatsiya: har epoxada boshqa rasm
1 132 ta rasm kam. Model ularni yodlab olmasligi uchun ultralytics har safar rasmni tasodifiy o'zgartiradi. Standart sozlamalar (cfg/default.yaml):
from ultralytics.utils import DEFAULT_CFG

izoh = {"mosaic": "4 ta rasmni bittaga yopishtirish ehtimoli", "close_mosaic": "oxirgi N epoxada mosaic o'chiriladi",
        "fliplr": "gorizontal aks ettirish ehtimoli", "scale": "masshtab: +/- ulushi", "translate": "siljitish: +/- ulushi",
        "hsv_h": "rang tusi o'zgarishi", "hsv_s": "to'yinganlik o'zgarishi", "hsv_v": "yorug'lik o'zgarishi"}
show(pd.DataFrame([{"parametr": k, "qiymat": getattr(DEFAULT_CFG, k), "ma'nosi": v} for k, v in izoh.items()]))
| parametr | qiymat | ma'nosi |
|---|---|---|
| mosaic | 1 | 4 ta rasmni bittaga yopishtirish ehtimoli |
| close_mosaic | 10 | oxirgi N epoxada mosaic o'chiriladi |
| fliplr | 0.5 | gorizontal aks ettirish ehtimoli |
| scale | 0.5 | masshtab: +/- ulushi |
| translate | 0.1 | siljitish: +/- ulushi |
| hsv_h | 0.015 | rang tusi o'zgarishi |
| hsv_s | 0.7 | to'yinganlik o'zgarishi |
| hsv_v | 0.4 | yorug'lik o'zgarishi |
Eng kuchlisi — mosaic: to'rtta rasm bitta 640 × 640 ga yopishtiriladi. Model bir qadamda ko'proq obyekt, ko'proq fon va turli masshtablarni ko'radi. Oxirgi 10 epoxada mosaic o'chiriladi, chunki ishlatishda rasmlar "yopishtirilgan" bo'lmaydi va model oxirida haqiqiy ko'rinishga moslashishi kerak. O'qitish boshlanganda ultralytics birinchi batch ni rasm qilib saqlaydi — quyidagi rasm pastdagi o'qitishimizdan:
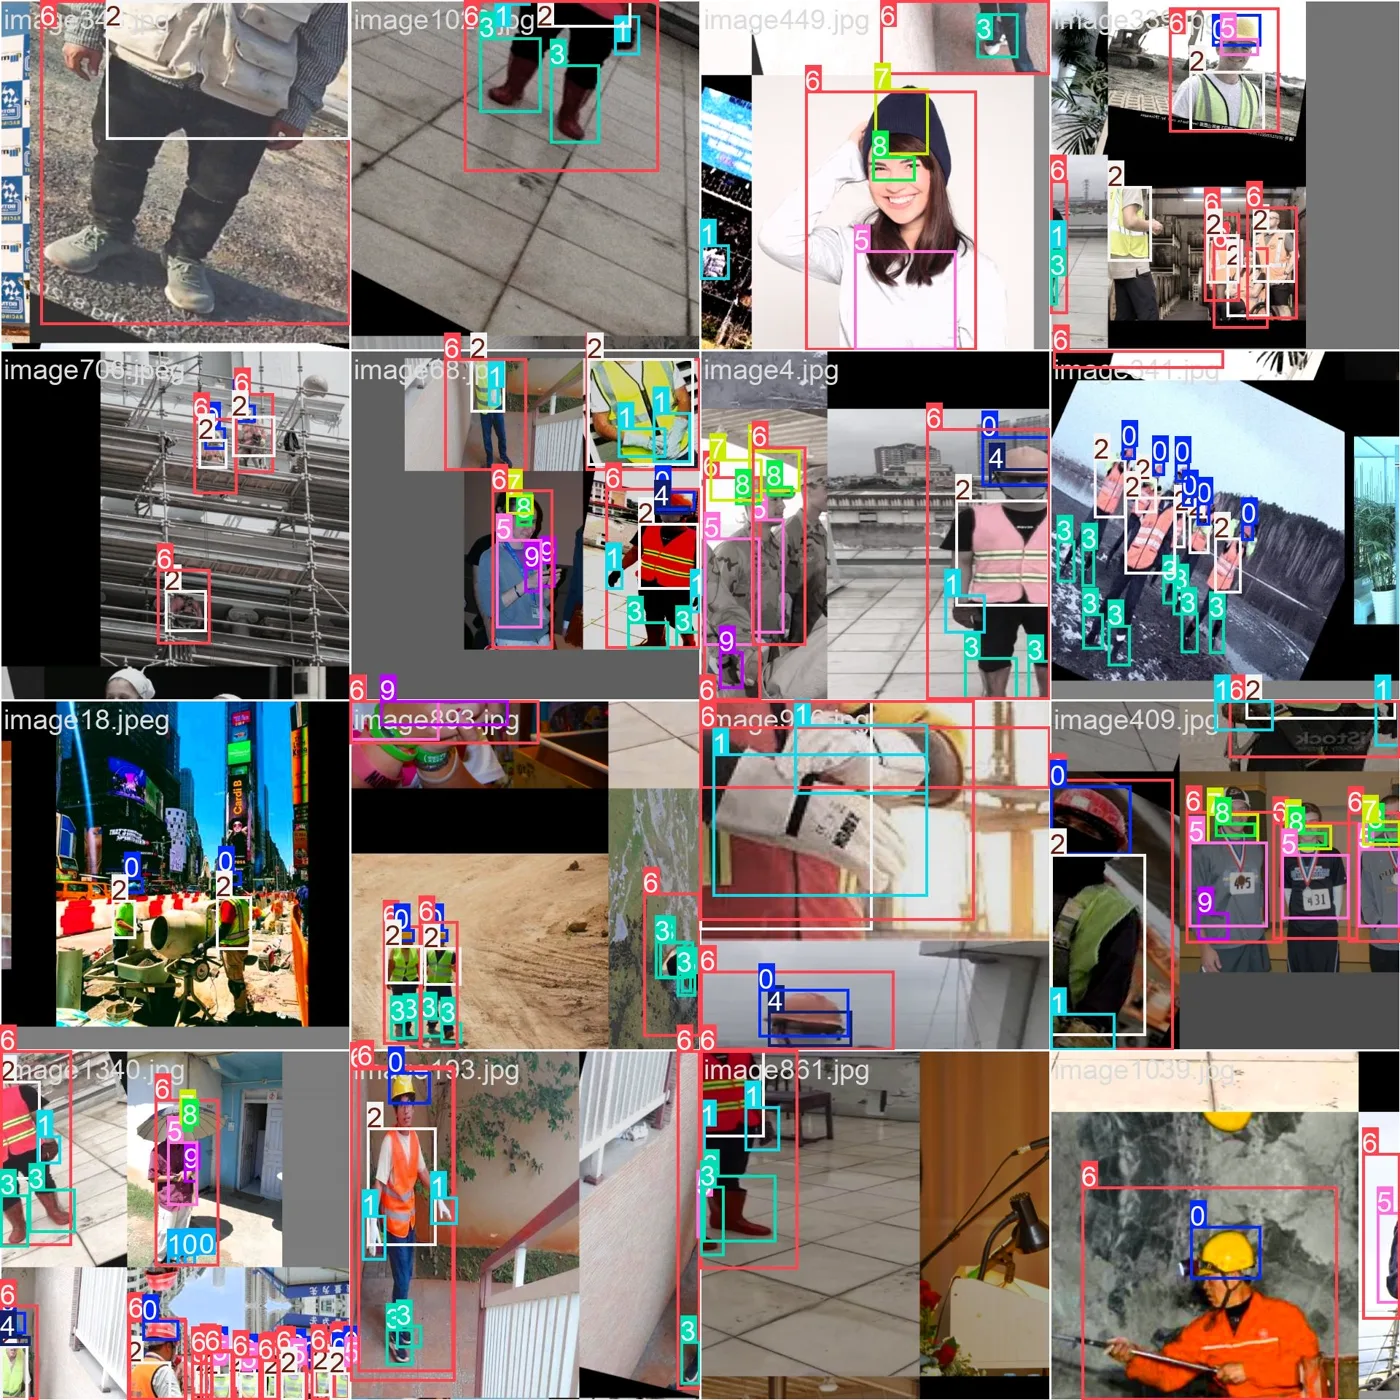
Birinchi o'qitish batch i: mosaic, aks ettirish, rang va masshtab o'zgarishlari
Ikki tajriba
Bir xil model (yolo11n), bir xil dataset, bir xil 50 epoxa. Yagona farq — boshlang'ich vaznlar:
- A (
ppe_coco) — COCO da o'qitilganyolo11n.ptdan boshlaymiz. Bu transfer learning: tarmoq chegaralarni, shakllarni, odamni allaqachon taniydi, faqat yangi sinflarni o'rganadi. Oxirgi qatlam (80 sinf → 11 sinf) mos kelmagani uchun u yangidan boshlanadi. - B (
ppe_noldan) — tasodifiy vaznlar (yolo11n.yaml,pretrained=False). Tarmoq hamma narsani noldan o'rganadi.
tajribalar = {"ppe_coco": ("weights/yolo11n.pt", True), "ppe_noldan": ("yolo11n.yaml", False)}
papka = Path("out/train").resolve()                       # nisbiy project runs/detect/ ichiga tushadi (2-bob)
for nom, (boshlanish, oldindan) in tajribalar.items():
    if (papka / nom / "results.csv").exists():             # kitobni qayta yig'ishda 20 daqiqalik o'qitish takrorlanmasin
        continue
    YOLO(boshlanish).train(data="datasets/ppe.yaml", epochs=50, imgsz=640, batch=16, device=0, seed=0,
                           pretrained=oldindan, cache="ram", workers=4, project=papka, name=nom, exist_ok=True)

for nom in tajribalar:
    tarix = pd.read_csv(papka / nom / "results.csv")
    print(f"{nom:10s}: {len(tarix)} epoxa, {tarix['time'].iloc[-1] / 60:.1f} daqiqa (RTX 5070 Ti)")
ppe_coco  : 50 epoxa, 4.8 daqiqa (RTX 5070 Ti)
ppe_noldan: 50 epoxa, 4.6 daqiqa (RTX 5070 Ti)
optimizer=auto qaysi optimizatorni tanladi? Qoida engine/trainer.py dagi build_optimizer da:
import inspect
from ultralytics.engine.trainer import BaseTrainer

kod = inspect.getsource(BaseTrainer.build_optimizer).splitlines()
print("\n".join(q for q in kod if "lr_fit" in q or '("MuSGD"' in q))
nc = len(nomlar)
print(f"\nbizda nc = {nc}: lr0 = round(0.002 * 5 / (4 + {nc}), 6) = {round(0.002 * 5 / (4 + nc), 6)}")
            lr_fit = round(0.002 * 5 / (4 + nc), 6)  # lr0 fit equation to 6 decimal places
            name, lr, momentum = ("MuSGD", 0.01, 0.9) if iterations > 10000 else ("AdamW", lr_fit, 0.9)

bizda nc = 11: lr0 = round(0.002 * 5 / (4 + 11), 6) = 0.000667
Qisqa o'qitishda (10 000 iteratsiyadan kam) — AdamW va sinflar soniga moslangan o'rganish tezligi. Uzoq o'qitishda — YOLO26 bilan birga kelgan MuSGD. Bizning 50 epoxamiz qisqa, demak AdamW.
Natijalar
Har epoxa oxirida ultralytics validatsiyada o'lchaydi va results.csv ga yozadi. Ikki tajriba yonma-yon:
_, axes = plt.subplots(1, 3, figsize=(12, 3.6))
for nom, rang in zip(tajribalar, ["#2563eb", "#dc2626"]):
    tarix = pd.read_csv(papka / nom / "results.csv")
    for ax, ustun in zip(axes, ["train/box_loss", "train/cls_loss", "metrics/mAP50-95(B)"]):
        ax.plot(tarix["epoch"], tarix[ustun], color=rang, label=nom, lw=2)
        ax.set_title(ustun, fontsize=10)
        ax.set_xlabel("epoxa")
axes[2].legend()
fig("oqitish_egri.png", "Ko'k — COCO dan boshlangan, qizil — noldan. Oxirgi 10 epoxada mosaic o'chadi.")
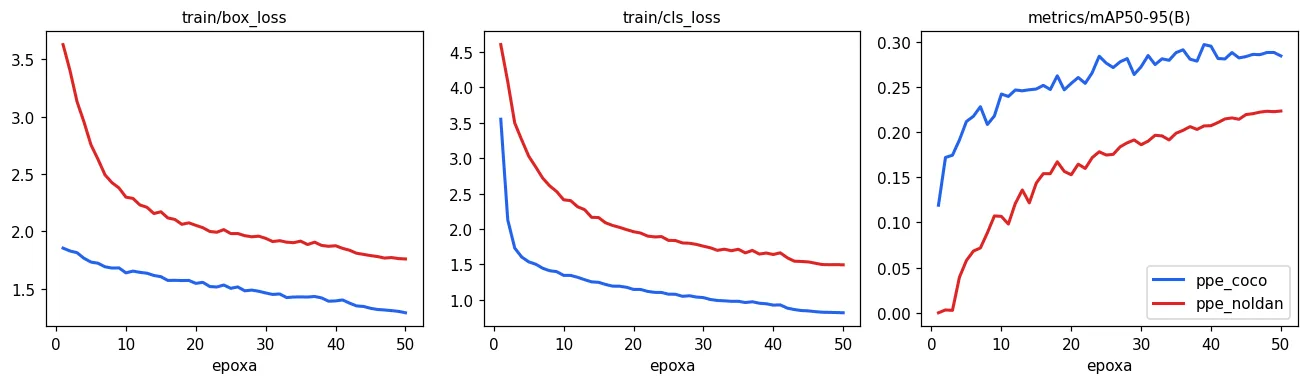
Ko'k — COCO dan boshlangan, qizil — noldan. Oxirgi 10 epoxada mosaic o'chadi.
COCO dan boshlangan model birinchi epoxadayoq mAP50-95 ≈ 0.12 da, noldan boshlangani esa nolda. Eng muhim raqam: COCO dan boshlangan model 7-epoxadayoq noldan boshlangan modelning 50-epoxadagi yakuniy natijasiga (0.223) yetdi. Loss lar ham shuni ko'rsatadi: ko'k egri chiziq boshidanoq pastda. Noldan boshlangan model 50 epoxada ham sekin o'sishda davom etmoqda — uzoqroq o'qitilsa farq qisqaradi, lekin buning narxi vaqt va elektr.
Eng yaxshi vaznlar (best.pt) bilan validatsiya va test qismlarida yakuniy o'lchov. Validatsiya o'qitish davomida eng yaxshi epoxani tanlash uchun ishlatildi, shuning uchun halol yakuniy raqam — test qismida:
qatorlar, olchovlar = [], {}
for nom in tajribalar:
    for qism in ("val", "test"):
        m = YOLO(papka / nom / "weights" / "best.pt").val(data="datasets/ppe.yaml", split=qism, imgsz=640, batch=16,
                                                           device=0, plots=False, project=papka / "val",
                                                           name=f"{nom}_{qism}", exist_ok=True)
        olchovlar[nom, qism] = m
        qatorlar.append({"tajriba": nom, "qism": qism, "precision": m.box.mp, "recall": m.box.mr,
                         "mAP50": m.box.map50, "mAP50-95": m.box.map})
show(pd.DataFrame(qatorlar).round(3))
| tajriba | qism | precision | recall | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| ppe_coco | val | 0.504 | 0.594 | 0.596 | 0.297 |
| ppe_coco | test | 0.701 | 0.516 | 0.548 | 0.281 |
| ppe_noldan | val | 0.861 | 0.391 | 0.459 | 0.224 |
| ppe_noldan | test | 0.859 | 0.38 | 0.442 | 0.22 |
Test da COCO dan boshlangan model mAP50-95 bo'yicha chorak qismdan ko'proq oldinda. Precision va recall ustunlariga ham qarang: noldan boshlangan modelning precision i yuqori, recall i esa past — u "ishonchli ko'rinsa" gapiradi, qolganini o'tkazib yuboradi. Bitta raqam (mAP) bu farqni yashiradi. Test raqamlari validatsiyadan biroz past — bu normal: validatsiya eng yaxshi epoxani tanlashda ishlatilgani uchun unga biroz "moslashib" qolgan.
Sinflar bo'yicha (A tajriba, test qismi):
m = olchovlar["ppe_coco", "test"]
show(pd.DataFrame([{"sinf": nomlar[int(k)], "testdagi soni": sanoq["test"][int(k)],
                    "AP50": m.box.ap50[i], "AP50-95": m.box.ap[i]} for i, k in enumerate(m.box.ap_class_index)])
     .sort_values("AP50-95", ascending=False).round(3), 11)
| sinf | testdagi soni | AP50 | AP50-95 |
|---|---|---|---|
| vest | 178 | 0.905 | 0.577 |
| helmet | 192 | 0.93 | 0.533 |
| Person | 236 | 0.843 | 0.525 |
| boots | 211 | 0.763 | 0.402 |
| gloves | 163 | 0.782 | 0.399 |
| goggles | 52 | 0.777 | 0.312 |
| none | 65 | 0.468 | 0.159 |
| no_helmet | 40 | 0.194 | 0.081 |
| no_goggle | 33 | 0.21 | 0.066 |
| no_gloves | 58 | 0.098 | 0.023 |
| no_boots | 23 | 0.055 | 0.014 |
Bu jadval — butun bobning eng muhim natijasi. Model kaska, jilet va odamni yaxshi topadi (AP50 0.84–0.93). Lekin "yo'q" sinflari — no_helmet, no_goggle, no_gloves, no_boots — juda yomon (AP50 0.21 va undan past). Mahsulot uchun esa aynan ular kerak: signal "kaskasiz odam" haqida bo'ladi.
Sabablari ikkita. Birinchisi — kam misol (testda 23–58 ta). Ikkinchisi — "yo'qlik" ni ko'rish qiyin: no_helmet ning box ida kaska emas, oddiy bosh yoki shapka bor, va model uni yuzlab boshqa "bosh" lardan ajratishi kerak. Muhandislik xulosasi: "kaskasiz odam" ni alohida sinf sifatida o'qitish o'rniga, yaxshi ishlaydigan ikki sinfdan mantiq bilan chiqarish mumkin — Person topildi, uning box ining yuqori qismida helmet yo'q → kaskasiz. Bu qoida III qismda, real vaqt pipeline ida, tracking bilan birga ishlatiladi: bitta kadrda emas, bir necha soniya davomida kaskasiz bo'lsagina signal beriladi.
Metrikalar: precision, recall, AP, mAP
Yuqoridagi raqamlar qayerdan keladi? Har bir bashorat box yoki TP (to'g'ri: shu sinfdagi GT bilan IoU ≥ 0.5, va bu GT hali boshqa box ga "berilmagan"), yoki FP (xato). Topilmay qolgan GT — FN.
Precision — "model 'kaska' degan joylarning qanchasi haqiqatan kaska". Recall — "haqiqiy kaskalarning qanchasini model topdi". Ikkalasi ishonch chegarasiga bog'liq (1-bob): chegara pasaysa recall oshadi, precision tushadi. Chegarani 0 dan 1 gacha surib, (R, P) nuqtalardan egri chiziq hosil bo'ladi. AP — shu egri chiziq ostidagi yuza:
Amalda: bashoratlar ishonch bo'yicha saralanadi, har qadamda P va R hisoblanadi, egri chiziq "konvert" qilinadi (har nuqtada o'ngdagi eng katta precision olinadi — zigzaglar tekislanadi) va 101 nuqtada integrallanadi. mAP50 — IoU chegarasi 0.5 da hamma sinflar AP sining o'rtachasi. mAP50-95 — 0.50, 0.55, ..., 0.95 dagi o'nta IoU chegarasi bo'yicha yana o'rtacha. U box ning aniq joylashuvini ham talab qiladi, shuning uchun doim pastroq.
AP ni noldan yozamiz:
def ap_hisobla(ishonch, tp, n_gt):
    """Bitta sinf AP: saralash -> P/R egri chizig'i -> konvert -> 101 nuqtada integral."""
    if len(tp) == 0 or n_gt == 0:                                   # bashorat yoki GT yo'q: AP = 0
        return 0.0, np.array([]), np.array([])
    tartib = np.argsort(-ishonch)
    tpc = np.cumsum(tp[tartib])
    fpc = np.cumsum(1 - tp[tartib])
    recall = tpc / (n_gt + 1e-16)
    precision = tpc / (tpc + fpc)
    mrec = np.concatenate(([0.0], recall, [1.0]))
    mpre = np.concatenate(([1.0], precision, [0.0]))
    mpre = np.flip(np.maximum.accumulate(np.flip(mpre)))            # konvert: o'ngdagi eng katta precision
    x = np.linspace(0, 1, 101)
    return np.trapezoid(np.interp(x, mrec, mpre), x), recall, precision
TP ni aniqlash uchun ultralytics ning moslash qoidasini takrorlaymiz (DetectionValidator.match_predictions): IoU chegaradan katta va sinfi to'g'ri juftliklar IoU bo'yicha saralanadi, keyin har bashorat va har GT faqat bir marta ishlatiladi:
def moslash(p_box, p_sinf, g_box, g_sinf, chegara=0.5):
    """Har bashorat uchun: TP (True) yoki FP (False)."""
    tp = np.zeros(len(p_box), bool)
    if len(p_box) == 0 or len(g_box) == 0:
        return tp
    iou = torchvision.ops.box_iou(torch.tensor(g_box), torch.tensor(p_box)).numpy() * (g_sinf[:, None] == p_sinf[None])
    juft = np.array(np.nonzero(iou >= chegara)).T                  # (GT, bashorat) juftliklari
    if len(juft):
        juft = juft[iou[juft[:, 0], juft[:, 1]].argsort()[::-1]]   # IoU bo'yicha kamayish
        juft = juft[np.unique(juft[:, 1], return_index=True)[1]]   # har bashorat bir marta
        juft = juft[np.unique(juft[:, 0], return_index=True)[1]]   # har GT bir marta
        tp[juft[:, 1]] = True
    return tp
Test qismining 141 rasmida predict() ishlatib (validatsiyadagi kabi conf=0.001, iou=0.7), hamma bashorat va GT ni yig'amiz:
eng_yaxshi = YOLO(papka / "ppe_coco" / "weights" / "best.pt")
hamma_ishonch, hamma_tp, hamma_sinf, gt_sinflar = [], [], [], []
for yol in sorted((ds / "images" / "test").iterdir()):
    r = eng_yaxshi.predict(yol, conf=0.001, iou=0.7, max_det=300, imgsz=640, device=0, verbose=False)[0]
    H, W = r.orig_shape
    lab = np.loadtxt(ds / "labels" / "test" / f"{yol.stem}.txt", ndmin=2).reshape(-1, 5)
    g_box = np.stack([(lab[:, 1] - lab[:, 3] / 2) * W, (lab[:, 2] - lab[:, 4] / 2) * H,
                      (lab[:, 1] + lab[:, 3] / 2) * W, (lab[:, 2] + lab[:, 4] / 2) * H], 1)
    p_sinf = r.boxes.cls.cpu().numpy()
    hamma_tp.append(moslash(r.boxes.xyxy.cpu().numpy(), p_sinf, g_box, lab[:, 0]))
    hamma_ishonch.append(r.boxes.conf.cpu().numpy())
    hamma_sinf.append(p_sinf)
    gt_sinflar.append(lab[:, 0])
ishonch, tp, p_sinf, gt_sinf = map(np.concatenate, (hamma_ishonch, hamma_tp, hamma_sinf, gt_sinflar))
print("bashoratlar:", len(ishonch), "| shundan TP (IoU 0.5):", int(tp.sum()), "| GT obyektlar:", len(gt_sinf))
bashoratlar: 20417 | shundan TP (IoU 0.5): 1091 | GT obyektlar: 1251
Endi har sinf uchun AP50 ni uch xil hisoblaymiz: o'z funksiyamiz, xuddi shu massivlar ustida ultralytics ning ap_per_class funksiyasi, va yuqoridagi val() natijasi:
_, _, _, _, _, ap_ultra, sinf_ultra, *_ = ap_per_class(tp[:, None], ishonch, p_sinf, gt_sinf)
qatorlar = []
for i, k in enumerate(sinf_ultra):
    ap_biz, _, _ = ap_hisobla(ishonch[p_sinf == k], tp[p_sinf == k].astype(float), (gt_sinf == k).sum())
    j = list(m.box.ap_class_index).index(k)
    qatorlar.append({"sinf": nomlar[int(k)], "AP50 (biz)": ap_biz, "AP50 (ap_per_class)": ap_ultra[i, 0],
                     "AP50 (val())": m.box.ap50[j]})
jadval = pd.DataFrame(qatorlar)
show(jadval.round(4), 11)
print("biz vs ap_per_class, eng katta farq:", float((jadval["AP50 (biz)"] - jadval["AP50 (ap_per_class)"]).abs().max()))
print("biz vs val(), eng katta farq:       ", round(float((jadval["AP50 (biz)"] - jadval["AP50 (val())"]).abs().max()), 4))
biz vs ap_per_class, eng katta farq: 0.0
biz vs val(), eng katta farq:        0.0317
| sinf | AP50 (biz) | AP50 (ap_per_class) | AP50 (val()) |
|---|---|---|---|
| helmet | 0.91 | 0.91 | 0.93 |
| gloves | 0.778 | 0.778 | 0.781 |
| vest | 0.881 | 0.881 | 0.905 |
| boots | 0.749 | 0.749 | 0.763 |
| goggles | 0.745 | 0.745 | 0.777 |
| none | 0.469 | 0.469 | 0.468 |
| Person | 0.83 | 0.83 | 0.843 |
| no_helmet | 0.19 | 0.19 | 0.194 |
| no_goggle | 0.178 | 0.178 | 0.21 |
| no_gloves | 0.067 | 0.067 | 0.098 |
| no_boots | 0.069 | 0.069 | 0.055 |
Birinchi ikki ustun bir xil massivlar ustida hisoblangan va aynan mos: formula to'g'ri. val() bilan esa kichik farq bor. Sababi — kirish rasmlari: val() rasmlarni batch larga guruhlab, har batch ga umumiy letterbox o'lchami tanlaydi (5-bobda ko'rgan "minimal to'ldirish" dan biroz farqli), predict() esa har rasmni alohida letterbox qiladi. Kirish bir necha piksel farq qilsa, ishonch qiymatlari ham biroz farq qiladi.
Bitta sinfning P–R egri chizig'i:
k = [i for i, n in nomlar.items() if n == "helmet"][0]
ap, rec, prec = ap_hisobla(ishonch[p_sinf == k], tp[p_sinf == k].astype(float), (gt_sinf == k).sum())
_, ax = plt.subplots(figsize=(5.5, 4))
ax.plot(rec, prec, lw=2, color="#2563eb")
ax.set_xlabel("recall")
ax.set_ylabel("precision")
ax.set_xlim(0, 1.02)
ax.set_ylim(0, 1.02)
ax.set_title(f"helmet, test: AP50 = {ap:.3f}")
fig("pr_helmet.png", "Ishonch chegarasi 1 dan 0 gacha tushganda: recall o'sadi, precision oxirida tushadi. AP — egri chiziq ostidagi yuza.")
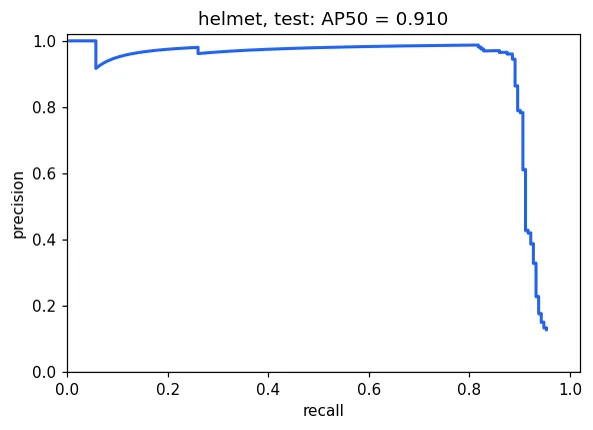
Ishonch chegarasi 1 dan 0 gacha tushganda: recall o'sadi, precision oxirida tushadi. AP — egri chiziq ostidagi yuza.
Yangi rasmlarda
Test qismidan ikkita rasm, o'qitilgan model bilan (standart chegara 0.25):
_, axes = plt.subplots(1, 2, figsize=(12, 5.2))
for ax, yol in zip(axes, sorted((ds / "images" / "test").iterdir())[5::60][:2]):
    r = eng_yaxshi.predict(yol, imgsz=640, device=0, verbose=False)[0]
    ax.imshow(r.plot()[:, :, ::-1])
    ax.set_title(yol.name, fontsize=9)
    ax.axis("off")
fig("ppe_test.png", "Test qismidagi ikki rasm: o'qitishda hech qachon ko'rilmagan.")
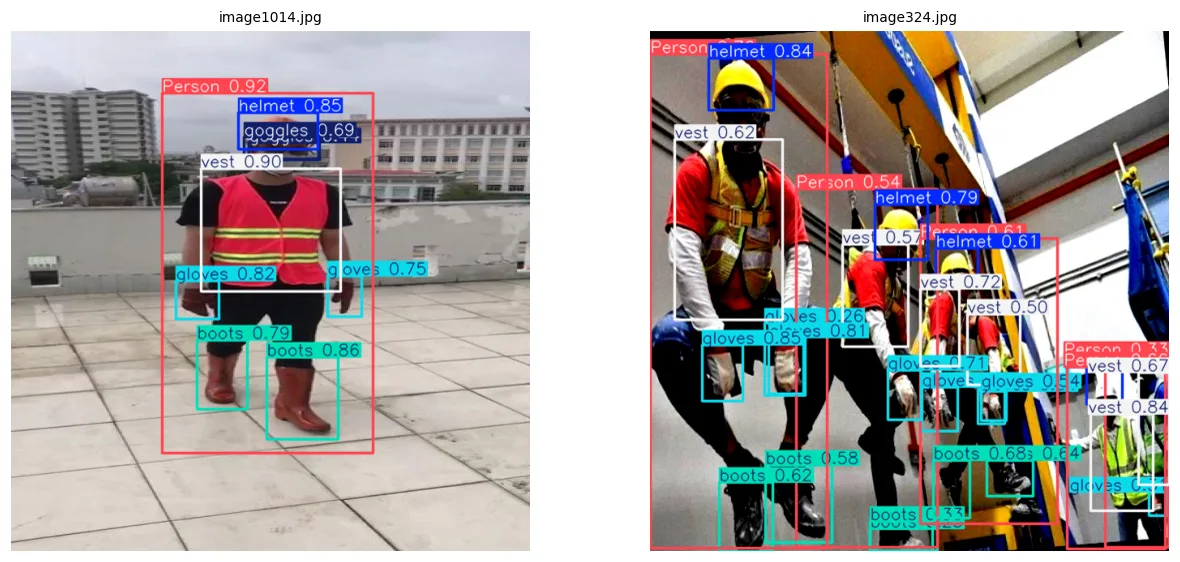
Test qismidagi ikki rasm: o'qitishda hech qachon ko'rilmagan.
Chapdagi rasmda odam, kaska, ko'zoynak, jilet, qo'lqop va botinka — hammasi topilgan, lekin ko'zoynakka ikkita box chizilgan. O'ngdagi olomonda yaqindagi ishchilar yaxshi, uzoqdagi va bir-birini to'sganlarda esa box lar ustma-ust va ishonch pastroq (0.3–0.6). 5 daqiqalik o'qitish uchun yomon emas, mahsulot uchun esa hali yetarli emas — ko'proq ma'lumot, mijozning o'z kameralaridan olingan rasmlar va uzoqroq o'qitish kerak.
Asosiy fikr
- Dataset ni o'qitishdan oldin tekshiring: yetim label lar, sinflar muvozanati, obyektlar o'lchami. 4 ta misolli sinf bo'yicha o'lchangan aniqlikka ishonmang.
- Transfer learning — kichik dataset uchun eng muhim qaror: COCO dan boshlangan model 7 epoxada noldan boshlangan modelning 50 epoxalik natijasiga yetdi. "Yo'qlik" sinflari (kaskasiz va h.k.) yomon o'rganiladi — ularni yaxshi sinflardan mantiq bilan chiqarish ishonchliroq.
- AP — P–R egri chizig'i ostidagi yuza; mAP50 — sinflar bo'yicha o'rtacha, mAP50-95 — yana o'nta IoU chegarasi bo'yicha. Halol yakuniy raqam — o'qitishda ham, model tanlashda ham ishlatilmagan test qismida.
Mashqlar
- A tajribani
epochs=100bilan qayta o'qiting. Test dagi mAP50-95 qanchaga oshadi? Egri chiziqlarga qarab, 50 epoxa yetarli edimi? moslash()da chegarani 0.75 ga ko'taring vahelmetuchun AP ni qayta hisoblang. Nega AP75 AP50 dan past?mosaic=0.0bilan A tajribani takrorlang. Qaysi sinflar eng ko'p yutqazdi — kichiklarmi yoki kattalarmi?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.