Data Engineering va MLOps: chegara qayerda
Ikki kasb, bitta poydevor
I qismda model bilan ishladik: takrorlanish, versiya, sifat, Docker, quvur. Har safar bir narsa
tayyor deb faraz qildik — jadval. ijara.csv bor edi, uni o'qidik.
Haqiqiy kompaniyada o'sha jadval osmondan tushmaydi. Kimdir uni yig'adi, tozalaydi, birlashtiradi va har kuni yangilab turadi. Bu ish — Data Engineering.
diagramma(
    {
        "Ilova bazasi\n(Postgres)": (0, 3.2, 2.3, 1.0, "manba"),
        "Hodisalar\n(klik, buyurtma)": (0, 1.6, 2.3, 1.0, "manba"),
        "Tashqi API\n(karta, ob-havo)": (0, 0.0, 2.3, 1.0, "manba"),
        "Yig'ish\n(Kafka, CDC)": (3.1, 1.6, 2.1, 1.0, "qayta"),
        "Saqlash\n(Iceberg)": (5.9, 1.6, 2.1, 1.0, "saqlash"),
        "Jadval\n(ijara.csv)": (8.7, 1.6, 2.1, 1.0, "saqlash"),
        "Model\n(I va III qism)": (11.5, 1.6, 2.1, 1.0, "xizmat"),
    },
    [
        ("Ilova bazasi\n(Postgres)", "Yig'ish\n(Kafka, CDC)"),
        ("Hodisalar\n(klik, buyurtma)", "Yig'ish\n(Kafka, CDC)"),
        ("Tashqi API\n(karta, ob-havo)", "Yig'ish\n(Kafka, CDC)"),
        ("Yig'ish\n(Kafka, CDC)", "Saqlash\n(Iceberg)"),
        ("Saqlash\n(Iceberg)", "Jadval\n(ijara.csv)"),
        ("Jadval\n(ijara.csv)", "Model\n(I va III qism)"),
    ],
    nom="de_chegara.png", kenglik=15,
    izoh="II qism chapdagi to'rt quti haqida. I va III qism eng o'ngdagisi haqida edi.",
)
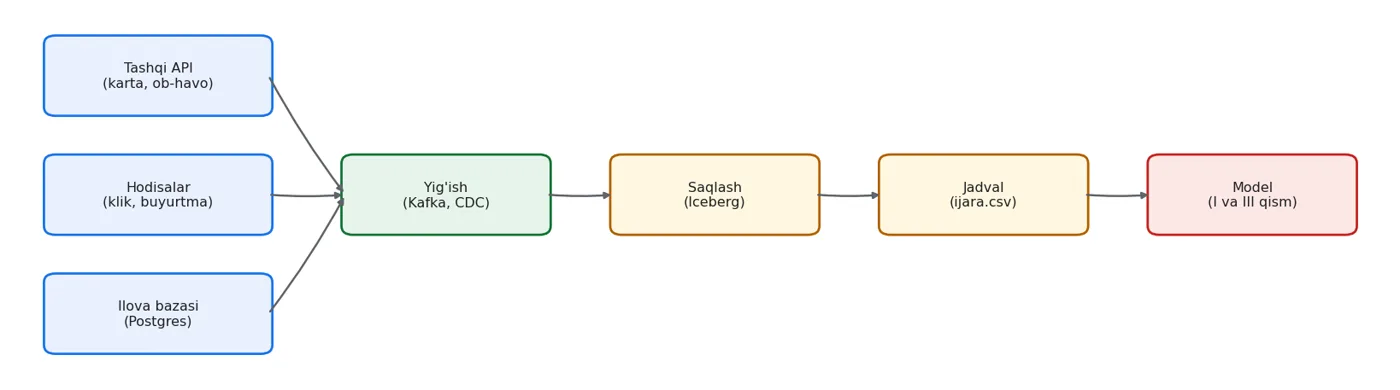
II qism chapdagi to'rt quti haqida. I va III qism eng o'ngdagisi haqida edi.
Chegara aniq: Data Engineer jadvalni yetkazadi, ML muhandis modelni yetkazadi. Lekin ikkalasi ham bir xil savollarga javob beradi — qaysi versiya, qachon yangilandi, sifat tekshirildimi. Shuning uchun II qism MLOps kitobida turibdi: bu alohida fan emas, bir xil poydevor.
OLTP va OLAP: nega ikki xil baza kerak
Eng ko'p chalkashtiriladigan joy shu, va u har doim bitta savol bilan boshlanadi:
— Bizda allaqachon Postgres bor. Nega yana boshqa baza kerak?
Javobni ikki xil kutubxonachi bilan tushuntiraman.
Birinchi kutubxonachi — javondagi kitobni topib beradi. Siz kelasiz, "Alisher Navoiy, Xamsa" deysiz. U katalogga qaraydi, javon raqamini topadi, borib oladi. O'ttiz soniya.
Ikkinchi kutubxonachi — statistika yuritadi. Siz so'raysiz: "Bu yil qaysi janrdagi kitoblar eng ko'p olingan?" U birinchi kutubxonachiga borsa, u bitta-bitta hamma kartochkani ko'rishi kerak bo'ladi — bir hafta ketadi.
Ikkalasi ham kerak. Ikkalasi ham "kutubxonachi". Lekin ular butunlay boshqa ish qiladi va boshqa tartibda saqlaydi.
Ma'lumotlar bazasida ham shunday, va ikki ishning rasmiy nomi bor:
- OLTP (Online Transaction Processing) — "M0076 mijozning oxirgi buyurtmasi qaysi?" Bitta qator, juda tez. Ilova shu bilan ishlaydi.
- OLAP (Online Analytical Processing) — "Sentabrda tumanlar bo'yicha o'rtacha yetkazish vaqti qancha?" Barcha qatorlar. Hisobot shu bilan ishlaydi.
Nomlarni yodlash shart emas. Farqni eslang: bitta qator va butun ustun.
Endi buni Newapp buyurtmalarida o'lchaymiz. Avval bir xil ma'lumotni ikki formatda saqlaymiz:
python3 -c "
import sqlite3, time, pathlib
import pandas as pd, pyarrow as pa, pyarrow.parquet as pq

d = pd.read_csv('../datasets/buyurtma.csv')
print(f'buyurtmalar: {len(d):,} qator, {len(d.columns)} ustun')

# OLTP uslubi: qatorli saqlash + indeks
con = sqlite3.connect('buyurtma.db')
d.to_sql('buyurtma', con, index=False, if_exists='replace')
con.execute('CREATE INDEX i_kuryer ON buyurtma(kuryer_id)')
con.commit(); con.close()

# OLAP uslubi: ustunli saqlash
pq.write_table(pa.Table.from_pandas(d), 'buyurtma.parquet', compression='zstd')

for f in ['buyurtma.db', 'buyurtma.parquet']:
    print(f'  {f:20s} {pathlib.Path(f).stat().st_size/1024:8.1f} KB')
"
buyurtmalar: 60,000 qator, 10 ustun
  buyurtma.db            6060.0 KB
  buyurtma.parquet        900.3 KB
Endi ikki savolni ikkala saqlashda ham o'lchaymiz:
python3 -c "
import sqlite3, time
import numpy as np, pyarrow.parquet as pq

def olch(f, n=20):
    f()                                   # isitish
    v = [ (lambda t0=time.perf_counter(): (f(), (time.perf_counter()-t0)*1000)[1])() for _ in range(n) ]
    return np.median(v)

con = sqlite3.connect('buyurtma.db')

def oltp_sqlite():
    return con.execute(\"SELECT * FROM buyurtma WHERE kuryer_id='K0789'\").fetchall()

def oltp_parquet():
    t = pq.read_table('buyurtma.parquet')
    return t.filter(t['kuryer_id'].to_pandas().values == 'K0789')

def olap_sqlite():
    return con.execute('SELECT tuman, AVG(yol_daq) FROM buyurtma GROUP BY tuman').fetchall()

def olap_parquet():
    t = pq.read_table('buyurtma.parquet', columns=['tuman', 'yol_daq']).to_pandas()
    return t.groupby('tuman')['yol_daq'].mean()

nom1 = 'OLTP: bitta kuryer qatorlari'
nom2 = 'OLAP: tuman kesimida o\'rtacha'
print(f'{\"savol\":34s} {\"SQLite\":>10s} {\"Parquet\":>10s}')
print('-' * 56)
a, b = olch(oltp_sqlite), olch(oltp_parquet)
print(f'{nom1:34s} {a:9.2f}ms {b:9.2f}ms')
c, e = olch(olap_sqlite), olch(olap_parquet)
print(f'{nom2:34s} {c:9.2f}ms {e:9.2f}ms')
print()
print(f'OLTP da SQLite {b/a:.1f}x tez')
print(f'OLAP da Parquet {c/e:.1f}x tez')
con.close()
"
savol                                  SQLite    Parquet
--------------------------------------------------------
OLTP: bitta kuryer qatorlari            0.60ms     11.38ms
OLAP: tuman kesimida o'rtacha         386.80ms     42.44ms

OLTP da SQLite 19.1x tez
OLAP da Parquet 9.1x tez
Natijani diqqat bilan o'qing — bu jadval bobning butun mazmuni.
Bitta g'olib yo'q. Har savolda boshqa format yutdi, va farq kichik emas — o'nlab barobar, ikki yo'nalishda ham.
Nega shunday? Ikki sabab, va ikkalasi ham 4-bobdagi kundalik-daftar rasmiga qaytadi.
OLTP da SQLite yutdi, chunki unda indeks bor. Indeks — bu kitob oxiridagi mundarija: "K0789 ni qidiryapsizmi? 4712-qatorga qarang". U butun jadvalni ko'rmasdan to'g'ri joyga boradi.
Parquet esa bu savolda butun faylni ochib, har qatorni tekshirdi. Mundarija yo'q.
OLAP da Parquet yutdi, chunki u tuman va yol_daq ni o'qiyotganda qolgan 8 ta
ustunni diskdan umuman ko'tarmaydi. SQLite esa qatorli saqlaydi — bitta ustunni olish
uchun har qatorning butunini o'qishi kerak, keyin keraksiz qismini tashlaydi.
Ya'ni ikkalasi ham "sekin" emas. Har biri o'zi mo'ljallanmagan savolda sekin.
Kutubxonachilarni eslang: birinchisidan statistika so'rasangiz, u yomon kutubxonachi emas — siz noto'g'ri odamga murojaat qilgansiz.
"Bazamiz sekin, indeks qo'shaylik"
Hisobot sekin ishlayotganda birinchi instinkt — indeks qo'shish. Lekin indeks OLTP muammosini hal qiladi: "bitta qatorni top". Hisobot esa barcha qatorlarni o'qiydi.
Barcha qatorlar kerak bo'lganda indeks yordam bermaydi, aksincha yozishni sekinlashtiradi. Bu yerda kerak bo'lgan narsa — indeks emas, boshqa saqlash formati.
Batch va oqim
Ikkinchi chegara — qachon.
import pandas as pd
show(pd.DataFrame([
    {"": "Batch", "qachon ishlaydi": "Jadval bo'yicha (masalan har tunda)",
     "kechikish": "Soatlar", "misol": "Kunlik broker hisoboti"},
    {"": "Oqim (streaming)", "qachon ishlaydi": "Hodisa kelishi bilan",
     "kechikish": "Soniyalar", "misol": "Ballon skanerlanganda ogohlantirish"},
]))
| qachon ishlaydi | kechikish | misol | |
|---|---|---|---|
| Batch | Jadval bo'yicha (masalan har tunda) | Soatlar | Kunlik broker hisoboti |
| Oqim (streaming) | Hodisa kelishi bilan | Soniyalar | Ballon skanerlanganda ogohlantirish |
Farqni his qilish uchun butun 40 mingta hodisani ikki usulda hisoblaymiz:
python3 -c "
import time
import pandas as pd

d = pd.read_csv('../datasets/ballon.csv', parse_dates=['vaqt'])
print(f'jami hodisalar: {len(d):,}')

t0 = time.perf_counter()
natija = d.groupby('ombor').size()
batch_ms = (time.perf_counter() - t0) * 1000

t0 = time.perf_counter()
holat = {}
for omb in d['ombor'].values:
    holat[omb] = holat.get(omb, 0) + 1
oqim_ms = (time.perf_counter() - t0) * 1000

nisbat = oqim_ms / batch_ms
bitta = oqim_ms / len(d) * 1000
oxirgi = d['vaqt'].max()

print()
print(f'BATCH: bitta guruhlash        -> {batch_ms:7.1f} ms')
print(f'OQIM : har hodisada yangilash -> {oqim_ms:7.1f} ms')
print(f'  bitta hodisaga {bitta:.2f} mikrosekund')
print()
print(f'natijalar bir xilmi: {dict(natija) == holat}')
print(f'oqim batchdan {nisbat:.1f}x ko\'p vaqt oldi')
print()
print(f'BATCH javobi {oxirgi} dan keyin tayyor')
print('OQIM  javobi har hodisadan keyin tayyor')
"
jami hodisalar: 40,000

BATCH: bitta guruhlash        ->     1.2 ms
OQIM : har hodisada yangilash ->     2.2 ms
  bitta hodisaga 0.05 mikrosekund

natijalar bir xilmi: True
oqim batchdan 1.8x ko'p vaqt oldi

BATCH javobi 2026-09-30 23:55:50 dan keyin tayyor
OQIM  javobi har hodisadan keyin tayyor
Mana asosiy savdo (trade-off): oqim umumiy ishni ko'paytiradi, lekin kechikishni yo'qotadi. Batch arzonroq, lekin javob kun oxirida keladi.
Kichik namunada o'lchov teskari chiqadi
Men bu tajribani avval bir kunlik ma'lumotda (1291 hodisa) o'tkazgandim. Natija: oqim batchdan
tez chiqdi — 0.2x. Ya'ni yuqorida yozgan gapimning teskarisi.
Sabab: 1291 qatorda pandas.groupby ning o'z tayyorgarligi hisobning o'zidan qimmat. Batchning
afzalligi hajm kattalashganda ochiladi, chunki u vektorlashtirilgan.
Shuning uchun bu yerda butun 40 ming hodisa o'lchanadi. Saboq umumiy: "qaysi usul tez" degan savolga javob berishdan oldin qaysi hajmda deb so'rang. Kichik namunadagi natija ishlab chiqarishda teskari bo'lishi mumkin.
Qaysi biri kerakligini qanday bilasiz
Savol texnik emas, biznesniki: javob 6 soat kechiksa nima yo'qoladi?
- Kunlik broker hisoboti kechiksa — hech narsa. Batch.
- Ballon g'oyib bo'lganini ertasiga bilsangiz — ballon ketdi. Oqim.
Oqimni "zamonaviyroq" degani uchun tanlash — eng qimmat xato.
Kim nimani yetkazadi
import pandas as pd
show(pd.DataFrame([
    {"Vazifa": "Postgres dan o'zgarishlarni olish", "Egasi": "Data Engineer", "Bob": "11"},
    {"Vazifa": "Hodisalar oqimini yig'ish", "Egasi": "Data Engineer", "Bob": "10"},
    {"Vazifa": "Jadval sxemasi va evolyutsiyasi", "Egasi": "Data Engineer", "Bob": "15"},
    {"Vazifa": "Ma'lumot sifati tekshiruvi", "Egasi": "Ikkalasi", "Bob": "6"},
    {"Vazifa": "Xususiyat hisoblash", "Egasi": "Ikkalasi", "Bob": "3"},
    {"Vazifa": "Model o'qitish va baholash", "Egasi": "ML muhandis", "Bob": "24"},
    {"Vazifa": "Model versiyasi va registr", "Egasi": "ML muhandis", "Bob": "23"},
    {"Vazifa": "Inference servis", "Egasi": "ML muhandis", "Bob": "27"},
]))
| Vazifa | Egasi | Bob |
|---|---|---|
| Postgres dan o'zgarishlarni olish | Data Engineer | 11 |
| Hodisalar oqimini yig'ish | Data Engineer | 10 |
| Jadval sxemasi va evolyutsiyasi | Data Engineer | 15 |
| Ma'lumot sifati tekshiruvi | Ikkalasi | 6 |
| Xususiyat hisoblash | Ikkalasi | 3 |
| Model o'qitish va baholash | ML muhandis | 24 |
| Model versiyasi va registr | ML muhandis | 23 |
| Inference servis | ML muhandis | 27 |
"Ikkalasi" qatorlariga e'tibor bering — kelishmovchilik aynan o'sha yerda tug'iladi. 3-bobdagi xususiyat siljishi (skew) shuning natijasi: o'qitish xususiyatni bir joyda, xizmat boshqa joyda hisoblaydi. II qism oxirida bu muammoni jadval darajasida hal qilamiz.
II qismda nima quriladi
| Bob | Mavzu | Nimani ishga tushiramiz |
|---|---|---|
| 10 | Apache Kafka | Haqiqiy broker, topic, partition, consumer group |
| 11 | CDC | Postgres → Debezium → Kafka |
| 12 | Spark asoslari | DataFrame, dangasa hisoblash, shuffle |
| 13 | Spark on Kubernetes | Driver va executor pod |
| 14 | Oqimli qayta ishlash | Oyna, watermark, kech kelgan ma'lumot |
| 15 | Apache Iceberg | Time travel, sxema evolyutsiyasi |
| 16 | Lakehouse | Ombor va ko'l birlashgani |
| 17 | Ombor modellashtirish | Fakt va o'lchov jadvallari |
| 18 | So'rov optimizatsiyasi | Partitsiya, statistika, reja o'qish |
| 19 | Tez serving qatlami | ClickHouse uslubidagi o'qish |
| 20 | O'zini tuzatuvchi quvur | Qayta urinish, karantin, ogohlantirish |
| 21 | DE loyihasi | Uchtasini bitta quvurga yig'ish |
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Chegara | DE jadvalni, MLOps modelni yetkazadi |
| OLTP | Bitta qator kerak — indeksli qatorli baza |
| OLAP | Butun ustun kerak — ustunli format |
| Bitta g'olib yo'q | O'lchagan ikki savol, ikki xil g'olib |
| Batch | Arzon, lekin javob kechikadi |
| Oqim | Ko'proq ish, lekin javob doim tayyor |
| Tanlov mezoni | "6 soat kechiksa nima yo'qoladi?" |
| Umumiy joy | Sifat va xususiyat — ikkalasining ishi |
Talaba ishi
ijara.csvuchun ham ikkala saqlashni yarating va o'sha ikki savolni o'lchang. Jadval kichraygani uchun farq qanday o'zgardi?- SQLite da
tumanustuniga indeks qo'shing va OLAP so'rovini qayta o'lchang. Tezlashdimi? Nega? - Parquet dan barcha ustunlarni o'qib ko'ring (
columns=ni olib tashlang). Ustunli formatning afzalligi qanchasi yo'qoladi? - Ballon hodisalarida oqim hisobini 1 daqiqalik oynaga bo'ling. Endi "javob doim tayyor" degani qanchalik to'g'ri?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.