Apache Spark asoslari
Sakkiz kishilik oshxona
Katta to'yga osh damlash kerak. Bir tonna sabzi to'g'ralishi kerak.
Bitta oshpaz bilan: u pichoq oladi, to'g'raydi, to'g'raydi... uch kun ketadi.
Endi sakkiz oshpaz chaqiring. Sabzini sakkiz qismga bo'lib berasiz. Har biri o'z qismini to'g'raydi. Uch kun emas, yarim kun.
Mana shu — Spark ning butun g'oyasi. Boshqa hech narsa emas.
Lekin sakkiz oshpaz bilan yangi muammolar paydo bo'ladi, va ular Spark ni o'rganishdagi qiyin joylar aynan shular:
- Kim nima qilishini kim aytadi? Kerak bo'ladi bosh oshpaz — Spark da u driver deyiladi. Oshpazlarning o'zi — executor.
- Sabzini qanday bo'lish kerak? Teng bo'lmasa, bittasi ertalab tugatadi, bittasi kechgacha ishlaydi. Spark da bu partition masalasi.
- Agar retsept "avval hammasini aralashtir, keyin tuz sep" desa-chi? Unda sakkiz oshpaz ishini to'xtatib, hamma sabzini bir joyga yig'ishi kerak. Bu — shuffle, va u Spark dagi eng qimmat amal.
Bu bobda uchalasini ham o'z ko'zingiz bilan ko'rasiz va o'lchaysiz.
Nega bizga Spark kerak bo'ldi
9-bobda pandas bilan 60 ming qatorni bir necha millisekundda hisobladik. pandas zo'r — bitta shartda: ma'lumot xotiraga sig'sa.
16 GB xotirali kompyuterda 100 GB log faylini ocholmaysiz. pandas MemoryError beradi va
tamom.
Sig'masa uch yo'l bor: kattaroq server olish (qimmat va cheki bor), ma'lumotni bo'lib-bo'lib o'qish (qo'lda va xatoga moyil), yoki ishni ko'p mashinaga taqsimlash. Spark uchinchisini qiladi va bir xil kod bitta noutbukda ham, 50 ta serverda ham ishlaydi.
diagramma(
    {
        "Driver\n(sizning kodingiz)": (0, 1.6, 2.6, 1.1, "qayta"),
        "Executor 1": (3.6, 3.0, 2.0, 0.9, "xizmat"),
        "Executor 2": (3.6, 1.7, 2.0, 0.9, "xizmat"),
        "Executor 3": (3.6, 0.4, 2.0, 0.9, "xizmat"),
        "Ma'lumot\n(bo'laklar)": (6.9, 1.7, 2.2, 1.1, "saqlash"),
    },
    [
        ("Driver\n(sizning kodingiz)", "Executor 1", "vazifa"),
        ("Driver\n(sizning kodingiz)", "Executor 2", "vazifa"),
        ("Driver\n(sizning kodingiz)", "Executor 3", "vazifa"),
        ("Executor 1", "Ma'lumot\n(bo'laklar)"),
        ("Executor 2", "Ma'lumot\n(bo'laklar)"),
        ("Executor 3", "Ma'lumot\n(bo'laklar)"),
    ],
    nom="spark_tuzilish.png", kenglik=12,
    izoh="Driver rejani tuzadi, executorlar bajaradi. Bu bobda hammasi bitta konteynerda.",
)
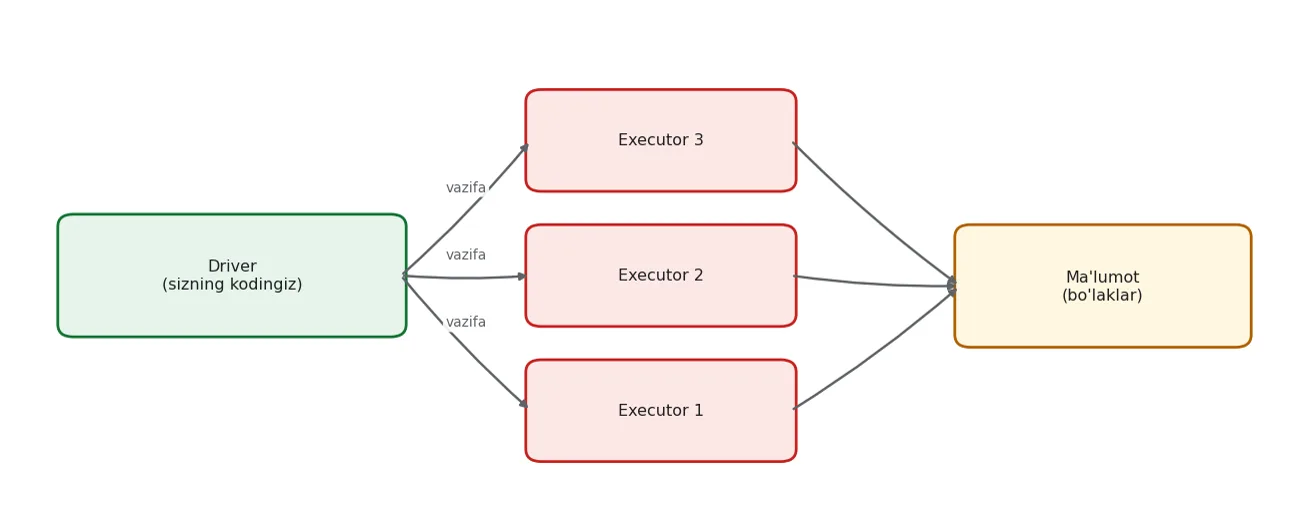
Driver rejani tuzadi, executorlar bajaradi. Bu bobda hammasi bitta konteynerda.
Bu mashinada Java yo'q, shuning uchun Spark ni o'z konteynerida ishlatamiz. Bu aynan ishlab chiqarishdagi usul — Spark hech qachon "noutbukka o'rnatilmaydi".
docker run --rm apache/spark:3.5.4 /opt/spark/bin/spark-submit --version 2>&1 | head -6
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /___/ .__/\_,_/_/ /_/\_\   version 3.5.4
      /_/
Birinchi ish
Skriptni yozamiz. Uning ichida ikkita yangi narsa bor va ularni oldindan tushuntiraman.
SparkSession — bu bosh oshpaz bilan gaplashish uchun telefon. Siz unga buyruq berasiz,
u oshpazlarga taqsimlaydi. Har Spark dasturi shundan boshlanadi.
DataFrame — bu jadval, lekin xotirada emas. pandas DataFrame i kompyuteringiz
xotirasida yotadi; Spark DataFrame i esa faqat ko'rsatma — "bu fayl, shu ustunlar,
shunday o'qilishi kerak". Ma'lumotning o'zi hali hech qayerda yo'q.
Farqni his qilish muhim: s.read.csv(...) yozganingizda fayl o'qilmaydi. Nega — keyingi
bo'limda ko'rasiz.
Ma'lumot konteynerga /data sifatida ulanadi.
shu faylni yaratingspark/01_birinchi.py
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

s = SparkSession.builder.appName("birinchi").getOrCreate()

d = s.read.csv("/data/ijara.csv", header=True, inferSchema=True)
print(f"qatorlar : {d.count():,}")
print(f"ustunlar : {len(d.columns)}")
print(f"partition: {d.rdd.getNumPartitions()}")

(d.groupBy("tuman")
  .agg(F.avg("narx_mln").alias("ortacha_narx"),
       F.count("*").alias("elonlar"))
  .orderBy(F.desc("ortacha_narx"))
  .show(5, truncate=False))

s.stop()
MADATA=$(cd ../datasets && pwd)
docker run --rm -v "$(pwd)/spark:/work:ro" -v "$MADATA:/data:ro" \
  apache/spark:3.5.4 /opt/spark/bin/spark-submit \
  --master "local[2]" --conf spark.log.level=ERROR /work/01_birinchi.py 2>&1 \
  | grep -vE "INFO|WARN"
qatorlar : 12,000
ustunlar : 14
partition: 1
+--------------+------------------+-------+
|tuman         |ortacha_narx      |elonlar|
+--------------+------------------+-------+
|Yakkasaroy    |7.8186584362139815|1215   |
|Mirobod       |7.347546666666664 |1125   |
|Yunusobod     |6.987274919614152 |1244   |
|Mirzo Ulug'bek|6.615872769588843 |1289   |
|Chilonzor     |5.615781383432971 |1171   |
+--------------+------------------+-------+
only showing top 5 rows
Spark loglari
Spark standart holda juda ko'p INFO yozadi. --conf spark.log.level=ERROR ularning ko'pini
o'chiradi, lekin SparkContext ko'tarilgunga qadar bir nechtasi baribir chiqadi — sozlama hali
o'qilmagan bo'ladi.
Shuning uchun bu kitobda chiqish grep -vE "INFO|WARN" orqali o'tkaziladi. Ishlab chiqarishda
esa loglar kerak: ular log4j2.properties fayli bilan boshqariladi.
Dangasa hisoblash (lazy evaluation)
Bu Spark ni tushunishdagi eng muhim tushuncha va yangi o'rganuvchilar eng ko'p adashadigan joy.
Yana oshxonaga. Siz bosh oshpazga borib aytasiz:
— Sabzini to'g'ra. Keyin piyozni qovur. Keyin go'shtni qo'sh. Keyin tuz sep.
Bosh oshpaz nima qiladi? Hech narsa. U tinglaydi va yozib boradi. Oshpazlar hali qimirlamaydi ham.
Ish qachon boshlanadi? Siz "menga tayyor oshni ber" deganingizda.
Nega shunday qilgani ma'qul? Chunki butun retseptni eshitgandan keyin bosh oshpaz o'ylaydi: "Tuzni oxirida sepasiz-ku, unda sabzini to'g'rayotganda tuz idishini olib kelish shart emas. Piyoz va sabzi bir vaqtda to'g'ralsa bo'ladi-ku."
Agar u har jumlani eshitishi bilan yugurib bajarganida, bunday o'ylashga imkoni bo'lmasdi.
Spark da ham xuddi shunday. filter, groupBy kabi amallar — transformatsiya, ular
faqat rejaga qo'shiladi. count(), show(), collect() — action, ular butun ishni
ishga soladi.
O'lchaymiz:
shu faylni yaratingspark/02_dangasa.py
import time
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

s = SparkSession.builder.appName("dangasa").getOrCreate()
d = s.read.csv("/data/buyurtma.csv", header=True, inferSchema=True)

t0 = time.perf_counter()
natija = (d.filter(F.col("summa_ming") > 50)
           .withColumn("soat", F.hour("vaqt"))
           .groupBy("tuman", "soat")
           .agg(F.avg("yol_daq").alias("ort_yol"))
           .orderBy("tuman", "soat"))
reja_ms = (time.perf_counter() - t0) * 1000

t0 = time.perf_counter()
n = natija.count()
bajarish_ms = (time.perf_counter() - t0) * 1000

print(f"TRANSFORMATSIYA (reja tuzish): {reja_ms:8.1f} ms")
print(f"ACTION          (bajarish)   : {bajarish_ms:8.1f} ms")
print(f"nisbat: action rejadan {bajarish_ms/reja_ms:,.0f}x uzoq")
print(f"natija qatorlari: {n:,}")
s.stop()
MADATA=$(cd ../datasets && pwd)
docker run --rm -v "$(pwd)/spark:/work:ro" -v "$MADATA:/data:ro" \
  apache/spark:3.5.4 /opt/spark/bin/spark-submit \
  --master "local[2]" --conf spark.log.level=ERROR /work/02_dangasa.py 2>&1 \
  | grep -vE "INFO|WARN"
TRANSFORMATSIYA (reja tuzish):     51.6 ms
ACTION          (bajarish)   :    601.0 ms
nisbat: action rejadan 12x uzoq
natija qatorlari: 240
To'rtta transformatsiya arzon bo'ldi, bitta count() esa butun ishni bajardi — o'nlab barobar
uzoq.
Nega bu foydali? Chunki Spark butun rejani oldindan ko'radi va uni optimallashtiradi.
filter ni o'qishga yaqinlashtiradi, kerak bo'lmagan ustunlarni tashlaydi. pandas da har qator
darhol bajariladi — optimallashtirishga imkon yo'q.
Rejani o'qiymiz
shu faylni yaratingspark/03_reja.py
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

s = SparkSession.builder.appName("reja").getOrCreate()
d = s.read.csv("/data/buyurtma.csv", header=True, inferSchema=True)

q = (d.filter(F.col("summa_ming") > 50)
      .select("tuman", "yol_daq")
      .groupBy("tuman")
      .agg(F.avg("yol_daq")))

print("=== FIZIK REJA ===")
q.explain(mode="formatted")
s.stop()
MADATA=$(cd ../datasets && pwd)
docker run --rm -v "$(pwd)/spark:/work:ro" -v "$MADATA:/data:ro" \
  apache/spark:3.5.4 /opt/spark/bin/spark-submit \
  --master "local[2]" --conf spark.log.level=ERROR /work/03_reja.py 2>&1 \
  | grep -vE "INFO|WARN" | head -30
=== FIZIK REJA ===
== Physical Plan ==
AdaptiveSparkPlan (7)
+- HashAggregate (6)
   +- Exchange (5)
      +- HashAggregate (4)
         +- Project (3)
            +- Filter (2)
               +- Scan csv  (1)


(1) Scan csv
Output [3]: [tuman#19, summa_ming#23, yol_daq#25]
Batched: false
Location: InMemoryFileIndex [file:/data/buyurtma.csv]
PushedFilters: [IsNotNull(summa_ming), GreaterThan(summa_ming,50.0)]
ReadSchema: struct<tuman:string,summa_ming:double,yol_daq:double>

(2) Filter
Input [3]: [tuman#19, summa_ming#23, yol_daq#25]
Condition : (isnotnull(summa_ming#23) AND (summa_ming#23 > 50.0))

(3) Project
Output [2]: [tuman#19, yol_daq#25]
Input [3]: [tuman#19, summa_ming#23, yol_daq#25]

(4) HashAggregate
Input [2]: [tuman#19, yol_daq#25]
Keys [1]: [tuman#19]
Functions [1]: [partial_avg(yol_daq#25)]
Rejada ikki narsani qidiring.
Exchange — bu shuffle degani, ya'ni ma'lumot executorlar orasida ko'chiriladi.
PushedFilters: [GreaterThan(summa_ming, 50.0)] — mana optimallashtirishning isboti.
Kod da filter read dan keyin yozilgan, lekin Spark uni o'qish bosqichiga tushirdi.
Ya'ni shart faylni o'qiyotgan paytda qo'llanadi, keyin emas. Project qatoriga ham qarang:
14 ustundan faqat 3 tasi o'qilmoqda.
Dangasa hisoblash aynan shu uchun kerak edi: Spark butun rejani ko'rmaganida bu ikki optimallashtirishning birortasini ham qila olmasdi.
Tor va keng transformatsiya
import pandas as pd
show(pd.DataFrame([
    {"Turi": "Tor (narrow)", "Misol": "filter, select, withColumn",
     "Ma'lumot ko'chadimi": "Yo'q", "Narxi": "Arzon"},
    {"Turi": "Keng (wide)", "Misol": "groupBy, join, orderBy, distinct",
     "Ma'lumot ko'chadimi": "Ha — shuffle", "Narxi": "Qimmat"},
]))
| Turi | Misol | Ma'lumot ko'chadimi | Narxi |
|---|---|---|---|
| Tor (narrow) | filter, select, withColumn | Yo'q | Arzon |
| Keng (wide) | groupBy, join, orderBy, distinct | Ha — shuffle | Qimmat |
Farqni o'lchaymiz — bir xil ma'lumot, ikki xil amal:
Bu safar 60 ming qator yetarli emas — sababini natijadan keyin ko'rasiz. Spark ning o'zida 5 million qatorli jadval yasaymiz:
shu faylni yaratingspark/04_shuffle.py
import time
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

s = SparkSession.builder.appName("shuffle").getOrCreate()

N = 5_000_000
d = (s.range(N)
      .withColumn("kalit", (F.rand(42) * 1000).cast("int"))
      .withColumn("qiymat", F.rand(7))
      .cache())
print(f"qatorlar: {d.count():,}")

def olch(nom, f, n=3):
    v = []
    for _ in range(n):
        t0 = time.perf_counter()
        f()
        v.append((time.perf_counter() - t0) * 1000)
    print(f"{nom:32s} {min(v):8.1f} ms")
    return min(v)

tor = olch("TOR : filter + count", lambda: d.filter(F.col("qiymat") > 0.5).count())
keng = olch("KENG: groupBy(1000 kalit)", lambda: d.groupBy("kalit").agg(F.avg("qiymat")).collect())
keng2 = olch("KENG: distinct kalit", lambda: d.select("kalit").distinct().count())
keng3 = olch("KENG: to'liq orderBy", lambda: d.orderBy("qiymat").limit(10).collect())

print()
print(f"groupBy  filterdan {keng/tor:.1f}x qimmat")
print(f"distinct filterdan {keng2/tor:.1f}x qimmat")
print(f"orderBy  filterdan {keng3/tor:.1f}x qimmat")
s.stop()
MADATA=$(cd ../datasets && pwd)
docker run --rm -v "$(pwd)/spark:/work:ro" -v "$MADATA:/data:ro" \
  apache/spark:3.5.4 /opt/spark/bin/spark-submit \
  --master "local[2]" --conf spark.log.level=ERROR /work/04_shuffle.py 2>&1 \
  | grep -vE "INFO|WARN"
qatorlar: 5,000,000
TOR : filter + count                141.2 ms
KENG: groupBy(1000 kalit)           257.8 ms
KENG: distinct kalit                236.4 ms
KENG: to'liq orderBy                175.4 ms

groupBy  filterdan 1.8x qimmat
distinct filterdan 1.7x qimmat
orderBy  filterdan 1.2x qimmat
Bitta mashinada shuffle arzon ko'rinadi — bu sizni aldaydi
Men bu tajribani avval 60 ming qatorli buyurtma.csv da o'tkazdim. Natija: groupBy filterdan
atigi 1.1x qimmat chiqdi. Ya'ni "shuffle qimmat" degan gapni o'sha o'lchov
tasdiqlamadi. Shuning uchun bu yerda 5 million qator ishlatiladi — va farq kattalashdi,
lekin baribir o'nlab barobar emas.
Sabab muhim: bu mashinada hamma narsa bitta konteyner ichida. Oshpazlar bitta stolda o'tiribdi — sabzini bir-biriga uzatish uchun qo'lini cho'zishi yetarli.
Haqiqiy klasterda oshpazlar boshqa-boshqa binoda. Shuffle degani — sabzini mashinaga ortib, boshqa binoga olib borish. Mana o'shanda u butun ishning 90 foizini yeb qo'yadi.
Amaliy xulosa: Spark ni noutbukda sinab ko'rib "shuffle muammo emas ekan" deb xulosa qilmang. Sizning o'lchovingizda tarmoq yo'q edi.
Shuffle — Spark sekinligining birinchi sababi
Ish sekin bo'lsa, birinchi qarash kerak bo'lgan joy — nechta Exchange bor.
Amaliy maslahatlar:
- filter ni imkon qadar erta qo'ying (kamroq ma'lumot ko'chadi)
- kerak bo'lmagan orderBy ni olib tashlang — u to'liq shuffle qiladi
- kichik jadvalni katta jadvalga qo'shayotgan bo'lsangiz, broadcast join ishlating
Partition va parallellik
Spark ishni partitionlarga bo'lib bajaradi. Juda kam bo'lsa — parallellik yo'q; juda ko'p bo'lsa — har biri uchun ortiqcha xarajat.
shu faylni yaratingspark/05_partition.py
import time
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

s = SparkSession.builder.appName("partition").getOrCreate()
d = s.read.csv("/data/buyurtma.csv", header=True, inferSchema=True)
print(f"CSV o'qilgandagi partition: {d.rdd.getNumPartitions()}")

for n in (1, 2, 4, 8, 16):
    p = d.repartition(n).cache()
    p.count()
    t0 = time.perf_counter()
    p.groupBy("tuman").agg(F.avg("yol_daq")).collect()
    print(f"  {n:2d} partition -> {(time.perf_counter()-t0)*1000:7.1f} ms")
    p.unpersist()
s.stop()
MADATA=$(cd ../datasets && pwd)
docker run --rm -v "$(pwd)/spark:/work:ro" -v "$MADATA:/data:ro" \
  apache/spark:3.5.4 /opt/spark/bin/spark-submit \
  --master "local[2]" --conf spark.log.level=ERROR /work/05_partition.py 2>&1 \
  | grep -vE "INFO|WARN"
CSV o'qilgandagi partition: 2
   1 partition ->   229.1 ms
   2 partition ->   163.0 ms
   4 partition ->    98.4 ms
   8 partition ->   114.4 ms
  16 partition ->   145.6 ms
Natijaga qarang — u to'g'ri chiziq emas, kosa shaklida. Boshida tez tushadi, pastda tekislanadi, keyin yana ko'tariladi.
Oshxonaga qayting, sabab o'sha yerda:
- 1 partition — bir tonna sabzi bitta oshpazda. Qolgan yetti kishi qarab turibdi.
- 2 partition — ikkitasi ishlaydi. Yaxshiroq, lekin hali kam.
- 4 partition — eng tez chiqdi. Yadro 2 ta bo'lsa ham 4 bo'lak yaxshi: bo'laklar teng emas, kimdir tezroq tugatib keyingisini oladi, hech kim bo'sh turmaydi.
- 8 va 16 — endi sekinlashadi. Har bo'lak uchun "kimga berdim, tugatdimi" deb hisob yuritish kerak. Sabzi kamayadi, qog'ozbozlik ko'payadi.
Men bu bobni yozganda avval "yadrodan ko'p partition foyda bermaydi" deb qo'ygandim. Birinchi o'lchov buni rad etdi. Keyin qayta o'lchadim — raqamlar yana o'zgardi. Ikkalasida ham bitta narsa barqaror qoldi: eng yaxshi nuqta o'rtada, chekkalarda emas.
Qoida: partition soni yadro sonidan 2–4 barobar ko'p bo'lsa yetarli. Lekin aniq sonni taxmin qilmang — o'lchang. U ma'lumotga ham, mashinaga ham, hatto o'sha kungi yuklamaga ham bog'liq.
Kesh: qachon foyda beradi
Dangasa hisoblashning bir yon ta'siri bor va u ko'pchilikni hayron qoldiradi.
DataFrame — bu ko'rsatma, ma'lumot emas. Demak har action chaqirilganda Spark
boshidan boshlaydi: faylni qayta o'qiydi, filtrni qayta qo'llaydi, hammasini qaytadan
hisoblaydi.
Ya'ni bir xil DataFrame ni uch marta ishlatsangiz, fayl uch marta o'qiladi.
Oshxonada bu shunday ko'rinardi: mijoz "sabzi nechta?" deb so'radi — oshpaz sanadi. Yana so'radi — yana sanadi. Uchinchi marta — yana.
Aqlli oshpaz nima qiladi? Birinchi javobni yozib qo'yadi.
cache() aynan shuni qiladi: "bu natijani xotirada saqla, keyingi safar qayta hisoblama".
Lekin xotira cheksiz emas — shuning uchun savol tug'iladi: qachon keshlash kerak?
O'lchab ko'ramiz.
shu faylni yaratingspark/06_kesh.py
import time
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

s = SparkSession.builder.appName("kesh").getOrCreate()

def uch_marta(d, nom):
    v = []
    for _ in range(3):
        t0 = time.perf_counter()
        d.filter(F.col("summa_ming") > 50).groupBy("tuman").count().collect()
        v.append((time.perf_counter() - t0) * 1000)
    print(f"{nom:12s} " + "  ".join(f"{x:7.1f}" for x in v) + " ms")
    return v

xom = s.read.csv("/data/buyurtma.csv", header=True, inferSchema=True)
a = uch_marta(xom, "keshsiz")

kesh = s.read.csv("/data/buyurtma.csv", header=True, inferSchema=True).cache()
kesh.count()
b = uch_marta(kesh, "keshli")

print()
print(f"keshsiz o'rtacha: {sum(a)/3:7.1f} ms")
print(f"keshli  o'rtacha: {sum(b)/3:7.1f} ms")
print(f"kesh {sum(a)/sum(b):.1f}x tezlashtirdi")
s.stop()
MADATA=$(cd ../datasets && pwd)
docker run --rm -v "$(pwd)/spark:/work:ro" -v "$MADATA:/data:ro" \
  apache/spark:3.5.4 /opt/spark/bin/spark-submit \
  --master "local[2]" --conf spark.log.level=ERROR /work/06_kesh.py 2>&1 \
  | grep -vE "INFO|WARN"
keshsiz        615.3    173.8    186.1 ms
keshli         150.3     83.6     73.9 ms

keshsiz o'rtacha:   325.1 ms
keshli  o'rtacha:   102.6 ms
kesh 3.2x tezlashtirdi
Kesh faqat bir necha marta o'qilganda foyda beradi. Bir marta ishlatiladigan DataFrame ni keshlash — xotirani behuda band qilish.
`collect()` driverni o'ldiradi
collect() butun natijani driver xotirasiga yig'adi. 10 million qatorli DataFrame da bu
OutOfMemoryError bilan tugaydi.
Xavfsiz almashtirishlar: show(20), take(100), limit(1000).collect(), yoki natijani
to'g'ridan-to'g'ri faylga yozish. Kattaligini bilmasangiz, avval count() qiling.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Driver va executor | Driver reja tuzadi, executorlar bajaradi |
| Dangasa hisoblash | Transformatsiya rejaga qo'shiladi, action bajaradi |
| Optimallashtirish | Spark butun rejani ko'rgani uchun uni qayta tartiblaydi |
explain() |
Exchange = shuffle = qimmat |
| Tor amal | filter, select — ma'lumot ko'chmaydi |
| Keng amal | groupBy, join, orderBy — shuffle bo'ladi |
| Partition | Yadro sonidan 2–4x ko'p yetarli |
| Kesh | Faqat qayta ishlatilganda foydali |
collect() |
Driver xotirasiga yig'adi — ehtiyot bo'ling |
Talaba ishi
02_dangasa.pyga yana beshtawithColumnqo'shing. Reja tuzish vaqti sezilarli oshdimi?--master "local[1]"valocal[4]bilan05_partition.pyni ishga tushiring. Eng yaxshi partition soni o'zgardimi?04_shuffle.pydafilternigroupBydan keyin qo'ying. Vaqt qanday o'zgardi vaexplain()da nima farq qiladi?orderByqo'shib rejani qayta o'qing. NechtaExchangepaydo bo'ldi?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.