ROC, PR, threshold va nomutanosib ma'lumot
Sahna: precision past — modelni qayta o'qitamizmi?
7-bobda modelimiz precision = 0.7476, recall = 0.8462 berdi. Menejer keladi:
"Reklama budjeti qisqardi. Men 'tez ketadi' degan e'lonlarning kamida 85 foizida to'g'ri bo'lishini xohlayman."
Siz nima qilasiz? Boshqa algoritm sinaysizmi? Ko'proq ma'lumot yig'asizmi? GPU buyurtma qilasizmi?
Yo'q. Siz bitta sonni o'zgartirasiz — va modelni umuman qayta o'qitmaysiz.
Bu bob shu haqda. Bu — protokolning 10-qadami ning davomi.
Model aslida 0 yoki 1 chiqarmaydi
Birinchi tushunish kerak bo'lgan narsa: predict() sizga javob beradi, lekin model ehtimollik hisoblaydi.
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
X, y = df[son + ["tuman"]], df["ijaraga_berildi_30k"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

quvur = Pipeline([
    ("tayyorla", ColumnTransformer([
        ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                          ("shkala", StandardScaler())]), son),
        ("matn", OneHotEncoder(handle_unknown="ignore"), ["tuman"]),
    ])),
    ("model", LogisticRegression(max_iter=2000)),
]).fit(X_tr, y_tr)

ehtimol = quvur.predict_proba(X_te)[:, 1]
taqqos = pd.DataFrame({"ehtimollik": ehtimol.round(3), "predict()": quvur.predict(X_te),
                       "haqiqat": y_te.values}).head(8)
show(taqqos)
| ehtimollik | predict() | haqiqat |
|---|---|---|
| 0.32 | 0 | 1 |
| 0.767 | 1 | 1 |
| 0.65 | 1 | 1 |
| 0.056 | 0 | 0 |
| 0.831 | 1 | 1 |
| 0.615 | 1 | 1 |
| 0.595 | 1 | 0 |
| 0.682 | 1 | 0 |
predict() ichida yashirin qoida bor: ehtimollik > 0.5 bo'lsa 1, aks holda 0.
0.5 — bu matematik haqiqat emas. Bu sukut bo'yicha qiymat. Va siz uni o'zgartirishingiz mumkin.
Threshold ni surib ko'ramiz
from sklearn.metrics import precision_score, recall_score, f1_score, accuracy_score

print(f"{'chegara':>8} {'precision':>10} {'recall':>8} {'F1':>7} {'accuracy':>9} {'nechta ha':>10}")
print("-" * 56)
for t in [0.3, 0.4, 0.5, 0.6, 0.7, 0.8]:
    b = (ehtimol >= t).astype(int)
    print(f"{t:>8} {precision_score(y_te, b, zero_division=0):>10.4f} "
          f"{recall_score(y_te, b, zero_division=0):>8.4f} "
          f"{f1_score(y_te, b, zero_division=0):>7.4f} "
          f"{accuracy_score(y_te, b):>9.4f} {int(b.sum()):>10}")
 chegara  precision   recall      F1  accuracy  nechta ha
--------------------------------------------------------
     0.3     0.6181   0.9780  0.7574    0.6833        288
     0.4     0.6748   0.9121  0.7757    0.7333        246
     0.5     0.7476   0.8462  0.7938    0.7778        206
     0.6     0.8027   0.6484  0.7173    0.7417        147
     0.7     0.8370   0.4231  0.5620    0.6667         92
     0.8     0.9189   0.1868  0.3105    0.5806         37
Jadvalni o'qing. Chegara oshganda precision o'sadi, recall tushadi. Bu — qat'iy qoida, tasodif emas.
Sabab oddiy: chegara balandlasa, model kamroq "ha" deydi. Kamroq "ha" degani — faqat eng ishonchli holatlarda aytadi (precision o'sadi), lekin ko'p haqiqiy holatni o'tkazib yuboradi (recall tushadi).
Menejerning talabi — precision ≥ 0.85. Qaysi chegara kerak?
import numpy as np
kerakli = None
for t in np.arange(0.30, 0.96, 0.01):
    b = (ehtimol >= t).astype(int)
    if b.sum() > 0 and precision_score(y_te, b, zero_division=0) >= 0.85:
        kerakli = t
        break
b = (ehtimol >= kerakli).astype(int)
print(f"Eng past chegara (precision >= 0.85): {kerakli:.2f}")
print(f"  precision: {precision_score(y_te, b):.4f}")
print(f"  recall   : {recall_score(y_te, b):.4f}")
print(f"  model nechta 'ha' dedi: {int(b.sum())} ta (0.5 da {int((ehtimol >= 0.5).sum())} ta edi)")
Eng past chegara (precision >= 0.85): 0.72
  precision: 0.8519
  recall   : 0.3791
  model nechta 'ha' dedi: 81 ta (0.5 da 206 ta edi)
Mana javob. Modelni qayta o'qitmadik, bitta satr kod ham o'zgartirmadik. Chegarani surdik.
Narxi bor: recall tushdi. Siz menejerga shuni aytasiz: "Precision 0.85 ga chiqdi, lekin endi tez ketadigan kvartiralarning kamrog'ini topamiz. Bu — savdo."
Eng yaxshi F1 beradigan chegarani avtomatik topish
prec, rec, thr = precision_recall_curve(y_te, ehtimol)
f1 = 2 * prec * rec / np.maximum(prec + rec, 1e-12)
eng = int(np.nanargmax(f1[:-1]))
print(thr[eng], f1[eng])
Lekin diqqat: bu chegarani test da topsangiz, u optimistik bo'ladi. To'g'ri yo'l — validation yoki CV da topish.
from sklearn.metrics import precision_recall_curve
prec, rec, thr = precision_recall_curve(y_te, ehtimol)
f1_egri = 2 * prec * rec / np.maximum(prec + rec, 1e-12)
eng = int(np.nanargmax(f1_egri[:-1]))
print(f"Eng yaxshi F1 beradigan chegara: {thr[eng]:.3f}  ->  F1 = {f1_egri[eng]:.4f}")
print(f"Sukut bo'yicha 0.5 da          :          F1 = {f1_score(y_te, quvur.predict(X_te)):.4f}")
Eng yaxshi F1 beradigan chegara: 0.511  ->  F1 = 0.7979
Sukut bo'yicha 0.5 da          :          F1 = 0.7938
Nomutanosib ma'lumot: ROC aldaydi, PR aldamaydi
Hozirgacha sinflar teng edi. Endi eng muhim holatga o'tamiz — nomutanosib ma'lumot. Bu amaliyotda eng ko'p uchraydigan holat.
Sun'iy nomutanosiblik yasaymiz: "tez ketdi" ulushini ~2% ga tushiramiz.
np.random.seed(42)
tez = y_te[y_te == 1].index
sekin = y_te[y_te == 0].index
tanlov = list(sekin) + list(np.random.choice(tez, size=max(1, int(len(sekin) * 0.02)), replace=False))

y_nom = y_te.loc[tanlov]
e_nom = pd.Series(ehtimol, index=y_te.index).loc[tanlov].values
print(f"Yangi to'plam: {len(y_nom)} qator, 'tez ketdi' ulushi {y_nom.mean():.2%}")
Yangi to'plam: 181 qator, 'tez ketdi' ulushi 1.66%
Endi ikki metrikani yonma-yon o'lchaymiz.
from sklearn.metrics import roc_auc_score, average_precision_score

auc = roc_auc_score(y_nom, e_nom)
ap = average_precision_score(y_nom, e_nom)

print(f"ROC-AUC          : {auc:.4f}")
print(f"Average Precision: {ap:.4f}")
print()
print("Tasodifiy model uchun baza:")
print(f"  ROC-AUC = 0.5000      (HAR DOIM, nomutanosiblikdan qat'i nazar)")
print(f"  AP      = {y_nom.mean():.4f}      (= pozitiv sinf ulushi)")
ROC-AUC          : 0.9551
Average Precision: 0.2342

Tasodifiy model uchun baza:
  ROC-AUC = 0.5000      (HAR DOIM, nomutanosiblikdan qat'i nazar)
  AP      = 0.0166      (= pozitiv sinf ulushi)
ROC-AUC chiroyli ko'rinadi. Lekin AP juda past.
Nega farq? Formulaga qaraymiz.
b_nom = (e_nom >= 0.5).astype(int)
from sklearn.metrics import confusion_matrix
tn, fp, fn, tp = confusion_matrix(y_nom, b_nom).ravel()
print(f"TN={tn}  FP={fp}  FN={fn}  TP={tp}")
print()
print("ROC ning ikkinchi o'qi — FPR:")
print(f"  FPR = FP / (FP + TN) = {fp} / ({fp} + {tn}) = {fp/(fp+tn):.4f}")
print()
print("TN ulkan (negativlar ko'p) -> maxraj ulkan -> FPR doim kichik.")
print("Natijada ROC egri chizig'i chap yuqoriga yopishadi va CHIROYLI ko'rinadi.")
print()
print("PR egri chizig'i esa TN ni UMUMAN ishlatmaydi:")
print(f"  precision = TP / (TP + FP) = {tp} / ({tp} + {fp}) = {tp/(tp+fp) if tp+fp else 0:.4f}")
print(f"  recall    = TP / (TP + FN) = {tp} / ({tp} + {fn}) = {tp/(tp+fn) if tp+fn else 0:.4f}")
TN=126  FP=52  FN=0  TP=3

ROC ning ikkinchi o'qi — FPR:
  FPR = FP / (FP + TN) = 52 / (52 + 126) = 0.2921

TN ulkan (negativlar ko'p) -> maxraj ulkan -> FPR doim kichik.
Natijada ROC egri chizig'i chap yuqoriga yopishadi va CHIROYLI ko'rinadi.

PR egri chizig'i esa TN ni UMUMAN ishlatmaydi:
  precision = TP / (TP + FP) = 3 / (3 + 52) = 0.0545
  recall    = TP / (TP + FN) = 3 / (3 + 0) = 1.0000
Mana sabab. TN — ROC ning yashirin yordamchisi. Negativlar ko'p bo'lsa, u ROC ni sun'iy ravishda yaxshi ko'rsatadi.
PR egri chizig'i faqat TP, FP, FN ni ishlatadi — ya'ni faqat siz qiziqqan sinf haqida gapiradi.
import matplotlib.pyplot as plt
from sklearn.metrics import roc_curve

fpr, tpr, _ = roc_curve(y_nom, e_nom)
p2, r2, _ = precision_recall_curve(y_nom, e_nom)

rasm, axes = plt.subplots(1, 2, figsize=(13, 5))
axes[0].plot(fpr, tpr, "b-", lw=2, label=f"AUC = {auc:.3f}")
axes[0].plot([0, 1], [0, 1], "k--", alpha=.5, label="Tasodifiy (0.5)")
axes[0].set_xlabel("False Positive Rate"); axes[0].set_ylabel("True Positive Rate")
axes[0].set_title("ROC — CHIROYLI ko'rinadi", color="darkorange", fontweight="bold")
axes[0].legend(); axes[0].grid(alpha=.3)

axes[1].plot(r2, p2, "r-", lw=2, label=f"AP = {ap:.3f}")
axes[1].axhline(y_nom.mean(), color="k", ls="--", alpha=.5, label=f"Tasodifiy ({y_nom.mean():.3f})")
axes[1].set_xlabel("Recall"); axes[1].set_ylabel("Precision")
axes[1].set_title("PR — HAQIQATNI ko'rsatadi", color="green", fontweight="bold")
axes[1].legend(); axes[1].grid(alpha=.3)
fig("roc_pr.png", caption="Bir xil model, bir xil ma'lumot. Chapdagi grafik sizni aldaydi.")
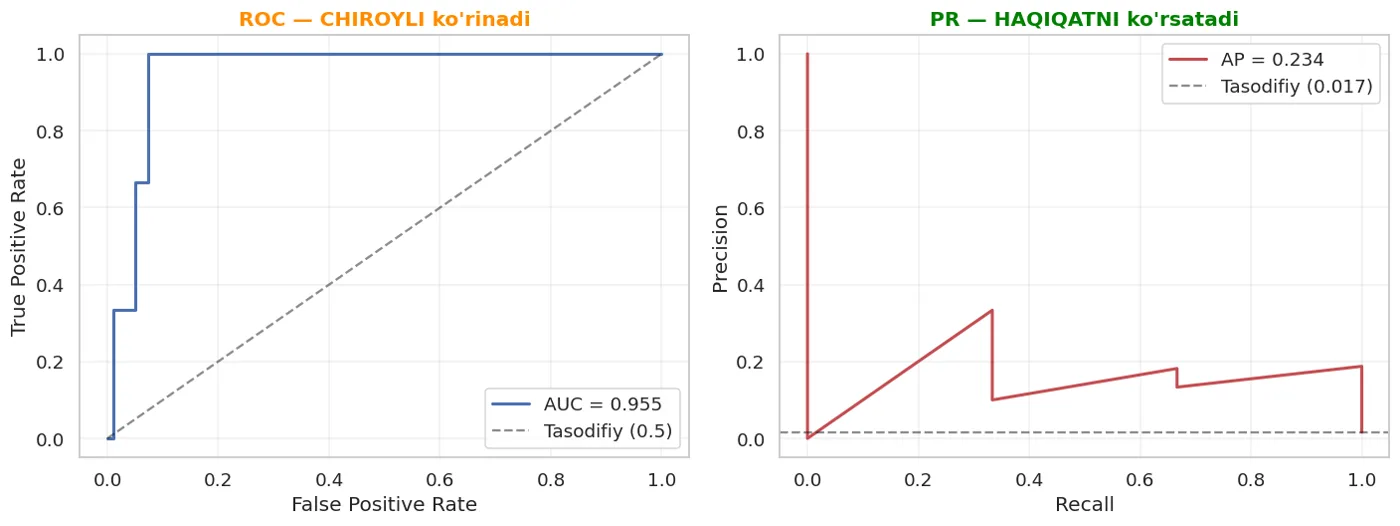
Bir xil model, bir xil ma'lumot. Chapdagi grafik sizni aldaydi.
Qachon ROC, qachon PR
- Sinflar taxminan teng -> ROC-AUC yaxshi ishlaydi, o'qish oson.
- Sinflar nomutanosib (pozitiv < 10%) -> PR-AUC (average precision) ishlatiladi.
- Maqolada "AUC 0.92" deb yozilgan bo'lsa va ma'lumot nomutanosib bo'lsa — sinf nisbatini so'rang.
Qoida: siz kam uchraydigan narsani qidirsangiz (fraud, kasallik, buzilish), PR ni o'qing.
class_weight="balanced" — sehrli tuzatish emas
Nomutanosiblikni "tuzatish" uchun eng ko'p beriladigan maslahat: class_weight="balanced". Keling, uni o'lchab ko'ramiz.
tz = list(set(tanlov))
X_nom = X_te.loc[tz]
y_nom2 = y_te.loc[tz]
X_ntr, X_nte, y_ntr, y_nte = train_test_split(X_nom, y_nom2, test_size=0.4,
                                              random_state=42, stratify=y_nom2)

def oz_quvur(**kw):
    return Pipeline([
        ("tayyorla", ColumnTransformer([
            ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                              ("shkala", StandardScaler())]), son),
            ("matn", OneHotEncoder(handle_unknown="ignore"), ["tuman"]),
        ])),
        ("model", LogisticRegression(max_iter=3000, **kw)),
    ])

oddiy = oz_quvur().fit(X_ntr, y_ntr)
balans = oz_quvur(class_weight="balanced").fit(X_ntr, y_ntr)

qatorlar = []
for nom_m, m in [("Oddiy", oddiy), ("class_weight=balanced", balans)]:
    b = m.predict(X_nte)
    qatorlar.append({"Model": nom_m,
                     "Accuracy": round(accuracy_score(y_nte, b), 4),
                     "Precision": round(precision_score(y_nte, b, zero_division=0), 4),
                     "Recall": round(recall_score(y_nte, b, zero_division=0), 4),
                     "F1": round(f1_score(y_nte, b, zero_division=0), 4)})
show(pd.DataFrame(qatorlar))
| Model | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|
| Oddiy | 0.986 | 0 | 0 | 0 |
| class_weight=balanced | 0.973 | 0 | 0 | 0 |
class_weight="balanced" nima qildi? U modelga "kam uchraydigan sinfning xatosi qimmatroq" dedi. Natijada model ko'proq "ha" deyadi — recall o'sadi, precision tushadi.
Bu tuzatish emas — bu tarozini bir tomonga og'dirish. Siz threshold ni surganingizda ham xuddi shu narsa bo'ladi.
Nomutanosiblikni "hal qilish" degan narsa yo'q
class_weight, SMOTE, oversampling, undersampling — bularning hech biri ma'lumotga yangi bilim qo'shmaydi. Ular faqat qaysi xatoni afzal ko'rasiz degan savolga javob beradi.
Agar sizda 20 ta pozitiv namuna bo'lsa, hech qanday texnika uni 2000 ta qilib qo'ymaydi. Yechim — ko'proq ma'lumot yig'ish yoki muammoni qayta qo'yish.
macro va weighted — qaysi birini o'qiysiz
from sklearn.metrics import classification_report
print(classification_report(y_nte, oddiy.predict(X_nte),
                            target_names=["sekin", "tez"], digits=4, zero_division=0))
              precision    recall  f1-score   support

       sekin     0.9863    1.0000    0.9931        72
         tez     0.0000    0.0000    0.0000         1

    accuracy                         0.9863        73
   macro avg     0.4932    0.5000    0.4966        73
weighted avg     0.9728    0.9863    0.9795        73
Diqqat: weighted avg katta sinfning natijasini ko'rsatadi va kichik sinfni yashiradi. macro avg esa ikki sinfni teng hisoblaydi — shuning uchun u pastroq va halolroq.
Qoida: nomutanosib ma'lumotda macro ni o'qing.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "predict() ichida 0.5 bor", "Bitta jumla": "U matematik haqiqat emas, sukut qiymat"},
    {"Tushuncha": "Threshold surish", "Bitta jumla": "Qayta o'qitmasdan precision/recall tanlovi"},
    {"Tushuncha": "Chegara oshsa", "Bitta jumla": "Precision o'sadi, recall tushadi — har doim"},
    {"Tushuncha": "ROC-AUC", "Bitta jumla": "Teng sinflarda yaxshi; nomutanosibda ALDAYDI (TN sababli)"},
    {"Tushuncha": "PR-AUC (AP)", "Bitta jumla": "TN ni ishlatmaydi — nomutanosibda haqiqatni aytadi"},
    {"Tushuncha": "class_weight=balanced", "Bitta jumla": "Tuzatish emas, tarozini og'dirish"},
    {"Tushuncha": "macro vs weighted", "Bitta jumla": "Nomutanosibda macro ni o'qi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| predict() ichida 0.5 bor | U matematik haqiqat emas, sukut qiymat |
| Threshold surish | Qayta o'qitmasdan precision/recall tanlovi |
| Chegara oshsa | Precision o'sadi, recall tushadi — har doim |
| ROC-AUC | Teng sinflarda yaxshi; nomutanosibda ALDAYDI (TN sababli) |
| PR-AUC (AP) | TN ni ishlatmaydi — nomutanosibda haqiqatni aytadi |
| class_weight=balanced | Tuzatish emas, tarozini og'dirish |
| macro vs weighted | Nomutanosibda macro ni o'qi |
Keyingi bobda: hozirgacha hamma raqam bitta bo'linishdan olingan. Uni o'zgartirsak raqamlar ham o'zgaradi. Shuni hal qilamiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.