Cost funksiya va gradient descent
Sahna: vaznlar qayerdan keladi
11-bobda men vaznlarni qo'lda yozdim:
w = np.array([55.0, 7.5, -28.0, 90.0])
Qayerdan oldim? O'ylab topdim. Va bashorat yaqin chiqdi, lekin aniq emas.
Savol: model bu sonlarni qanday o'zi topadi?
Javob ikki qadamdan iborat:
- Xatoni o'lchaydigan funksiya yozamiz (cost function)
- Shu funksiyani eng kichik qiladigan vaznlarni izlaymiz (gradient descent)
Bu bob — fit() ning ichidagi mexanizm.
1-qadam: xatoni o'lchaymiz
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["maydon_m2"]                      # avval BITTA xususiyat — ko'rish osonroq
X = df[son].to_numpy(dtype=float)
y = df["narx_usd"].to_numpy(dtype=float)

def bashorat(X, w, b):
    return X @ w + b

def mse(X, y, w, b):
    xato = bashorat(X, w, b) - y
    return float(np.mean(xato ** 2))

# ikki xil taxmin
for w_t, b_t in [(np.array([5.0]), 200.0), (np.array([7.5]), 180.0), (np.array([12.0]), 50.0)]:
    print(f"w={w_t[0]:>5.1f}  b={b_t:>5.0f}  ->  MSE = {mse(X, y, w_t, b_t):>12,.0f}".replace(",", " "))
w=  5.0  b=  200  ->  MSE =      105 898
w=  7.5  b=  180  ->  MSE =       41 789
w= 12.0  b=   50  ->  MSE =       14 025
MSE (Mean Squared Error) — o'rtacha kvadratik xato:
Nega kvadrat? Ikki sabab:
show(pd.DataFrame([
    {"Sabab": "Ishorani yo'qotish", "Izoh": "+50 va -50 xato bir-birini yo'qotmasligi kerak"},
    {"Sabab": "Katta xatoni ko'proq jazolash", "Izoh": "10 birlik xato -> 100; 100 birlik -> 10 000"},
    {"Sabab": "Hosilasi oson", "Izoh": "Kvadratning hosilasi chiziqli — gradient hisoblash qulay"},
]))
| Sabab | Izoh |
|---|---|
| Ishorani yo'qotish | +50 va -50 xato bir-birini yo'qotmasligi kerak |
| Katta xatoni ko'proq jazolash | 10 birlik xato -> 100; 100 birlik -> 10 000 |
| Hosilasi oson | Kvadratning hosilasi chiziqli — gradient hisoblash qulay |
MSE chetki qiymatlarga juda sezgir
Kvadrat katta xatoni kuchaytiradi. Agar ma'lumotda bitta narx = 999999 bo'lsa, u butun MSE ni va butun modelni tortib ketadi.
Shu holatda MAE (mutlaq xato) yoki HuberRegressor ishlatiladi. 14-bobda taqqoslaymiz.
Cost funksiya — bu kosa
Bitta vazn uchun MSE ni chizib ko'raylik. b ni qotirib, faqat w ni o'zgartiramiz.
w_oraliq = np.linspace(0, 20, 200)
xarajat = [mse(X, y, np.array([wi]), 180.0) for wi in w_oraliq]
eng_yaxshi_i = int(np.argmin(xarajat))

rasm, ax = plt.subplots(figsize=(9.5, 5))
ax.plot(w_oraliq, xarajat, "b-", lw=2)
ax.plot(w_oraliq[eng_yaxshi_i], xarajat[eng_yaxshi_i], "ro", ms=11,
        label=f"eng past: w={w_oraliq[eng_yaxshi_i]:.2f}")
ax.set_xlabel("w (maydon_m2 ning vazni)")
ax.set_ylabel("MSE (xarajat)")
ax.set_title("Cost funksiya — kosa shaklida", fontweight="bold")
ax.legend(); ax.grid(alpha=.3)
fig("kosa.png", caption="MSE kosa shaklida. Eng past nuqta — eng yaxshi vazn. Gradient descent shu nuqtaga tushadi.")

print(f"Eng past nuqta: w = {w_oraliq[eng_yaxshi_i]:.3f},  MSE = {xarajat[eng_yaxshi_i]:,.0f}".replace(",", " "))
Eng past nuqta: w = 10.352 MSE = 11 057
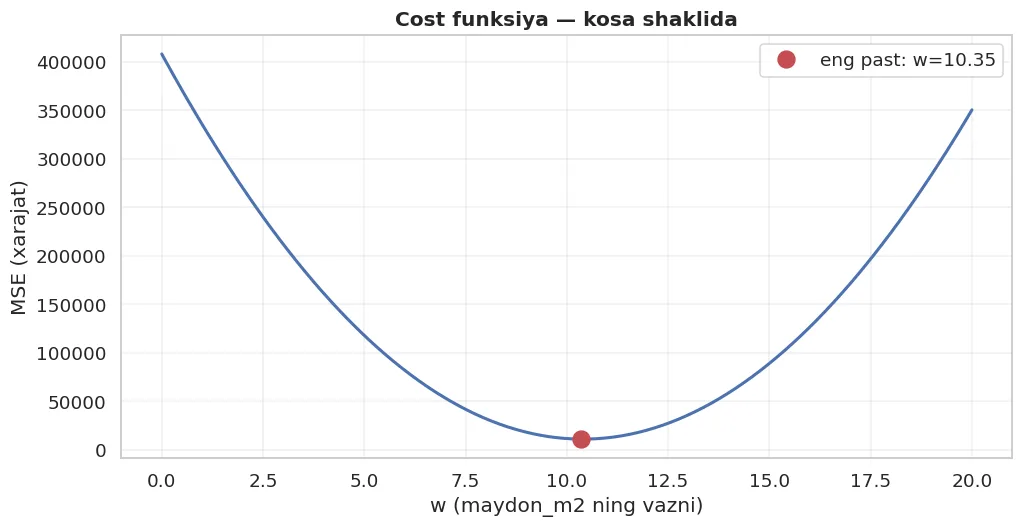
MSE kosa shaklida. Eng past nuqta — eng yaxshi vazn. Gradient descent shu nuqtaga tushadi.
Mana vazifa aniq bo'ldi: kosaning tubini topish.
Bitta vazn bo'lsa, shunchaki 200 ta qiymatni sinab ko'rish mumkin. Lekin 4 vazn bo'lsa —
Shuning uchun boshqa yo'l kerak.
2-qadam: hosila — qaysi tomonga qarab tushish
Tasavvur qiling: siz tog'dasiz, tuman qalin, pastga tushmoqchisiz. Butun vodiyni ko'rmaysiz — lekin oyog'ingiz ostidagi qiyalikni sezasiz.
Qiyalik qaysi tomonga pasaysa — o'sha tomonga qadam qo'yasiz. Takrorlaysiz. Tubga tushasiz.
Hosila — bu matematik qiyalik.
def gradient(X, y, w, b):
    """MSE ning w va b bo'yicha hosilalari."""
    n = len(y)
    xato = bashorat(X, w, b) - y          # shakli (n,)
    dw = (2 / n) * (X.T @ xato)           # shakli (m,)
    db = (2 / n) * np.sum(xato)
    return dw, db

for wi in [3.0, 7.5, 15.0]:
    dw, db = gradient(X, y, np.array([wi]), 180.0)
    yonalish = "w ni OSHIRISH kerak" if dw[0] < 0 else "w ni KAMAYTIRISH kerak"
    print(f"w={wi:>5.1f}  ->  dw={dw[0]:>12,.1f}   {yonalish}".replace(",", " "))
w=  3.0  ->  dw=   -54 337.2   w ni OSHIRISH kerak
w=  7.5  ->  dw=   -21 257.9   w ni OSHIRISH kerak
w= 15.0  ->  dw=    33 874.3   w ni KAMAYTIRISH kerak
Gradient belgisi yo'nalishni aytadi, kattaligi qiyalik tikligini aytadi.
Formulalar (chiziqli model va MSE uchun):
E'tibor bering: X.T @ xato — bu 11-bobdagi amal. Yangi narsa yo'q.
Gradient descent: qoida bitta qatorda
So'z bilan: vazndan gradientni ayir, lekin oldin uni kichik songa ko'paytir. O'sha kichik son — alpha, ya'ni learning rate.
def gradient_descent(X, y, alpha=0.0001, qadamlar=200):
    w = np.zeros(X.shape[1])
    b = 0.0
    tarix = []
    for i in range(qadamlar):
        dw, db = gradient(X, y, w, b)
        w = w - alpha * dw
        b = b - alpha * db
        tarix.append({"qadam": i, "w": float(w[0]), "b": b, "mse": mse(X, y, w, b)})
    return w, b, pd.DataFrame(tarix)

w_fin, b_fin, tarix = gradient_descent(X, y, alpha=0.0002, qadamlar=400)
show(tarix.iloc[[0, 1, 2, 5, 20, 100, 399]].round(3))
| qadam | w | b | mse |
|---|---|---|---|
| 0 | 19.395 | 0.31 | 156 913.295 |
| 1 | 10.269 | 0.177 | 46 637.126 |
| 2 | 14.563 | 0.253 | 22 220.079 |
| 5 | 13.045 | 0.255 | 15 350.696 |
| 20 | 13.186 | 0.387 | 15 269.7 |
| 100 | 13.176 | 1.078 | 15 239.823 |
| 399 | 13.136 | 3.641 | 15 130.008 |
print(f"Boshlanish : w=0.000     MSE={tarix.mse.iloc[0]:>12,.0f}".replace(",", " "))
print(f"Yakun      : w={w_fin[0]:.3f}   MSE={tarix.mse.iloc[-1]:>12,.0f}".replace(",", " "))
print()
from sklearn.linear_model import LinearRegression
lr = LinearRegression().fit(X, y)
print(f"sklearn javobi: w={lr.coef_[0]:.3f}  b={lr.intercept_:.2f}")
print(f"Bizning javob : w={w_fin[0]:.3f}  b={b_fin:.2f}")
Boshlanish : w=0.000     MSE=     156 913
Yakun      : w=13.136   MSE=      15 130

sklearn javobi: w=10.132  b=196.68
Bizning javob : w=13.136  b=3.64
Raqamlarga qarang. Ular mos kelmadi:
w: biz 13.136, sklearn 10.132b: biz 3.64, sklearn 196.68
b ayniqsa dahshatli orqada — u 0 dan boshlanib, atigi 3.64 ga yetdi, 196.68 ga esa yaqin ham bormadi.
Nega? 400 qadam yetarli emas. Lekin "yetarli emas" degani qancha? O'lchaymiz.
print("Shkalalanmagan ma'lumotda qancha qadam kerak:")
print(f"{'qadamlar':>10} {'w':>9} {'b':>10} {'MSE':>12}")
print("-" * 44)
for n in [400, 5000, 50000, 300000]:
    w_t, b_t, tr_t = gradient_descent(X, y, alpha=0.0002, qadamlar=n)
    mse_matn = f"{tr_t.mse.iloc[-1]:,.0f}".replace(",", " ")
    print(f"{n:>10} {w_t[0]:>9.3f} {b_t:>10.2f} {mse_matn:>12}")
print()
print(f"sklearn:   w={lr.coef_[0]:.3f}  b={lr.intercept_:.2f}")
Shkalalanmagan ma'lumotda qancha qadam kerak:
  qadamlar         w          b          MSE
--------------------------------------------
       400    13.136       3.64       15 130
      5000    12.584      39.08       13 760
     50000    10.469     175.02       11 072
    300000    10.132     196.68       11 021

sklearn:   w=10.132  b=196.68
300 000 qadam kerak bo'ldi. Bitta xususiyat va 1200 qator uchun.
Bu — qabul qilinmaydigan narx. Va sabab ma'lumotning shkalasida: maydon_m2 22 dan 220 gacha, shuning uchun alpha juda kichik bo'lishga majbur, va b ning gradienti ham o'sha kichik alpha ga ko'paytiriladi.
Yechim esa keyingi bo'limda.
rasm, axes = plt.subplots(1, 2, figsize=(14, 4.8))
axes[0].plot(tarix.qadam, tarix.mse, "b-", lw=2)
axes[0].set_xlabel("Qadam"); axes[0].set_ylabel("MSE")
axes[0].set_title("Xarajat qadamma-qadam tushadi", fontweight="bold")
axes[0].grid(alpha=.3)

axes[1].plot(w_oraliq, xarajat, "k-", lw=1.5, alpha=.5, label="cost funksiya")
qadamlar_ko = tarix.iloc[::12]
axes[1].plot(qadamlar_ko.w, [mse(X, y, np.array([wi]), 180.0) for wi in qadamlar_ko.w],
             "ro-", ms=5, lw=1, label="gradient descent yo'li")
axes[1].set_xlabel("w"); axes[1].set_ylabel("MSE")
axes[1].set_title("Kosa bo'ylab tushish", fontweight="bold")
axes[1].legend(); axes[1].grid(alpha=.3)
fig("gd_yoli.png", caption="Chapda: xarajat har qadamda kamayadi. O'ngda: shu qadamlar kosa ustida qanday ko'rinadi.")
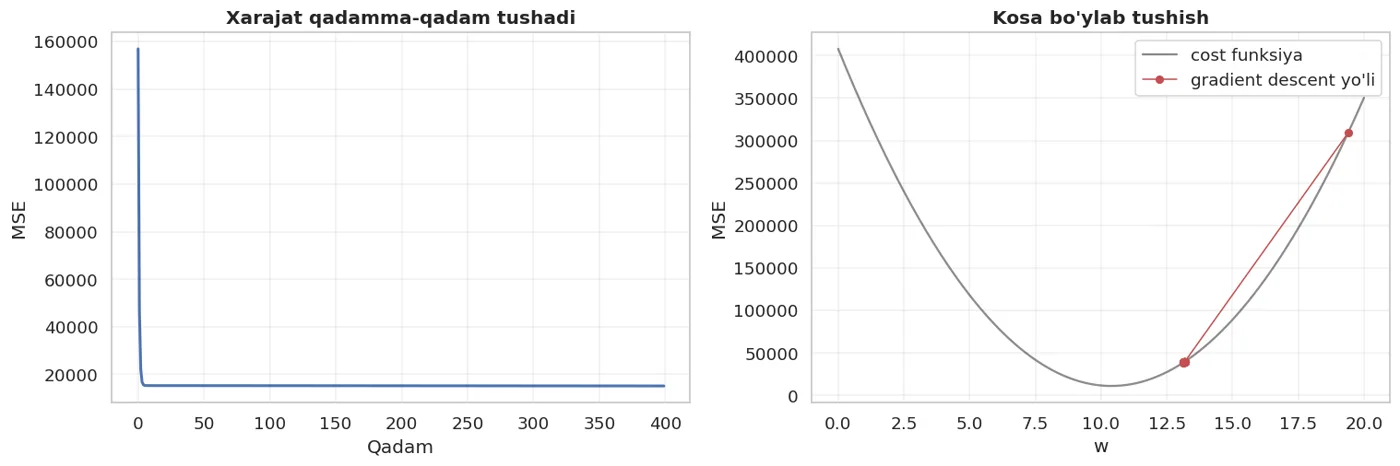
Chapda: xarajat har qadamda kamayadi. O'ngda: shu qadamlar kosa ustida qanday ko'rinadi.
Learning rate — eng muhim sozlama
alpha juda kichik bo'lsa — sekin. Juda katta bo'lsa — kosadan otib chiqadi va portlaydi.
print(f"{'alpha':>10} {'400 qadamdan keyin w':>22} {'MSE':>16} {'holat':>14}")
print("-" * 68)
for a in [0.000001, 0.00002, 0.0002, 0.001, 0.01]:
    w_t, b_t, tr = gradient_descent(X, y, alpha=a, qadamlar=400)
    m = tr.mse.iloc[-1]
    if not np.isfinite(m) or m > 1e12:
        holat, m_matn = "PORTLADI", "inf"
    elif abs(w_t[0] - lr.coef_[0]) < 0.5:
        holat, m_matn = "yaqinlashdi", f"{m:,.0f}".replace(",", " ")
    else:
        holat, m_matn = "juda sekin", f"{m:,.0f}".replace(",", " ")
    print(f"{a:>10} {w_t[0]:>22.3f} {m_matn:>16} {holat:>14}")
print()
print(f"sklearn ning javobi: w = {lr.coef_[0]:.3f}")
     alpha   400 qadamdan keyin w              MSE          holat
--------------------------------------------------------------------
     1e-06                 12.500           17 022     juda sekin
     2e-05                 13.184           15 263     juda sekin
    0.0002                 13.136           15 130     juda sekin
     0.001                    nan              inf       PORTLADI
      0.01                    nan              inf       PORTLADI

sklearn ning javobi: w = 10.132
Jadval uchta holatni ko'rsatadi: juda sekin, to'g'ri, portlagan. Oraliq keng emas.
Nega scaling gradient descent uchun SHART
Yuqoridagi alpha qiymatlari juda kichik — 0.0002. Nega?
Chunki maydon_m2 22 dan 220 gacha. Gradient shu kattalikka proporsional bo'ladi, shuning uchun qadam juda kichik bo'lishi kerak.
Agar ustunlar turli shkalada bo'lsa, bitta alpha hammasiga mos kelmaydi: bittasi uchun juda katta, boshqasi uchun juda kichik. Kosa "cho'zilgan" bo'ladi va gradient descent zigzag qiladi.
StandardScaler dan keyin esa kosa dumaloq bo'ladi va bitta alpha hammasiga yetadi. Bu — 4-bobdagi "scaling kerak" qoidasining haqiqiy sababi.
from sklearn.preprocessing import StandardScaler
Xs = StandardScaler().fit_transform(X)
print("Shkalalangan ma'lumotda ANCHA katta alpha ishlaydi:")
print(f"{'alpha':>8} {'w':>10} {'MSE':>14}")
print("-" * 34)
for a in [0.001, 0.01, 0.1, 0.5]:
    w_t, b_t, tr = gradient_descent(Xs, y, alpha=a, qadamlar=400)
    print(f"{a:>8} {w_t[0]:>10.2f} {tr.mse.iloc[-1]:>13,.0f}".replace(",", " "))
Shkalalangan ma'lumotda ANCHA katta alpha ishlaydi:
   alpha          w            MSE
----------------------------------
   0.001     112.41       140 823
    0.01     203.93        11 021
     0.1     203.99        11 021
     0.5     203.99        11 021
Shkalalangandan keyin alpha=0.1 ham ishlaydi — shkalalashdan oldin bu portlardi.
Ko'p xususiyat bilan
son4 = ["xonalar", "maydon_m2", "metro_km", "mebel"]
X4 = StandardScaler().fit_transform(df[son4].to_numpy(dtype=float))
w4, b4, tr4 = gradient_descent(X4, y, alpha=0.1, qadamlar=1500)

lr4 = LinearRegression().fit(X4, y)
taqqos = pd.DataFrame({
    "xususiyat": son4,
    "biz topdik": w4.round(2),
    "sklearn": lr4.coef_.round(2),
})
show(taqqos)
print(f"bias: biz {b4:.2f}  |  sklearn {lr4.intercept_:.2f}")
print(f"MSE : biz {tr4.mse.iloc[-1]:,.0f}  |  sklearn {mse(X4, y, lr4.coef_, lr4.intercept_):,.0f}".replace(",", " "))
bias: biz 776.10  |  sklearn 776.10
MSE : biz 6 567  |  sklearn 6 567
| xususiyat | biz topdik | sklearn |
|---|---|---|
| xonalar | 62.02 | 62.02 |
| maydon_m2 | 147.32 | 147.32 |
| metro_km | -44.55 | -44.55 |
| mebel | 43.36 | 43.36 |
Kodimizda hech narsa o'zgarmadi — faqat X ning ustunlari ko'paydi. gradient() funksiyasi matritsa amallari bilan yozilgani uchun u har qanday ustun soni bilan ishlaydi.
Uch xil gradient descent
Hozirgacha har qadamda butun ma'lumotni ishlatdik. Boshqa variantlar ham bor.
show(pd.DataFrame([
    {"Turi": "Batch GD", "Har qadamda": "HAMMA qator", "Tezlik": "Sekin",
     "Yo'li": "Silliq", "Qachon": "Kichik ma'lumot"},
    {"Turi": "Stochastic GD (SGD)", "Har qadamda": "BITTA qator", "Tezlik": "Tez",
     "Yo'li": "Juda shovqinli", "Qachon": "Juda katta ma'lumot, onlayn o'qitish"},
    {"Turi": "Mini-batch GD", "Har qadamda": "32-256 qator", "Tezlik": "Tez",
     "Yo'li": "O'rtacha shovqinli", "Qachon": "AMALDA ENG KO'P ishlatiladi"},
]))
| Turi | Har qadamda | Tezlik | Yo'li | Qachon |
|---|---|---|---|---|
| Batch GD | HAMMA qator | Sekin | Silliq | Kichik ma'lumot |
| Stochastic GD (SGD) | BITTA qator | Tez | Juda shovqinli | Juda katta ma'lumot, onlayn o'qitish |
| Mini-batch GD | 32-256 qator | Tez | O'rtacha shovqinli | AMALDA ENG KO'P ishlatiladi |
def mini_batch_gd(X, y, alpha=0.1, epoxalar=30, paket=64, seed=42):
    r = np.random.default_rng(seed)
    w, b = np.zeros(X.shape[1]), 0.0
    tarix = []
    n = len(y)
    for e in range(epoxalar):
        tartib = r.permutation(n)
        for boshi in range(0, n, paket):
            idx = tartib[boshi:boshi + paket]
            dw, db = gradient(X[idx], y[idx], w, b)
            w, b = w - alpha * dw, b - alpha * db
        tarix.append(mse(X, y, w, b))
    return w, b, tarix

w_mb, b_mb, tar_mb = mini_batch_gd(X4, y)
print(f"Batch GD      (1500 qadam): MSE = {tr4.mse.iloc[-1]:>10,.0f}".replace(",", " "))
print(f"Mini-batch GD (30 epoxa)  : MSE = {tar_mb[-1]:>10,.0f}".replace(",", " "))
print(f"sklearn                   : MSE = {mse(X4, y, lr4.coef_, lr4.intercept_):>10,.0f}".replace(",", " "))
Batch GD      (1500 qadam): MSE =      6 567
Mini-batch GD (30 epoxa)  : MSE =      6 584
sklearn                   : MSE =      6 567
Mini-batch kamroq hisob bilan shunga yaqin natijaga keldi. Neyron tarmoqlarda (29–30-bob) aynan shu usul ishlatiladi.
Nega bu bob muhim
show(pd.DataFrame([
    {"Qayerda": "Linear regression (14-bob)", "Gradient descent roli": "Vaznlarni topadi"},
    {"Qayerda": "Logistic regression (15-bob)", "Gradient descent roli": "Xuddi shu, boshqa cost funksiya bilan"},
    {"Qayerda": "Ridge / Lasso (16-bob)", "Gradient descent roli": "Cost ga jarima qo'shiladi"},
    {"Qayerda": "Neyron tarmoq (30-bob)", "Gradient descent roli": "Backpropagation — bu zanjir bo'yicha gradient"},
    {"Qayerda": "XGBoost (19-bob)", "Gradient descent roli": "Nomidan ko'rinadi: Gradient Boosting"},
]))
| Qayerda | Gradient descent roli |
|---|---|
| Linear regression (14-bob) | Vaznlarni topadi |
| Logistic regression (15-bob) | Xuddi shu, boshqa cost funksiya bilan |
| Ridge / Lasso (16-bob) | Cost ga jarima qo'shiladi |
| Neyron tarmoq (30-bob) | Backpropagation — bu zanjir bo'yicha gradient |
| XGBoost (19-bob) | Nomidan ko'rinadi: Gradient Boosting |
Siz hozir bitta mexanizmni o'rgandingiz, va u kitobning yarmida qayta uchraydi. Daraxtlar (17-bob) bundan mustasno — ular butunlay boshqa yo'l bilan ishlaydi.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Cost funksiya", "Bitta jumla": "Xatoni bitta son bilan o'lchaydi (MSE)"},
    {"Tushuncha": "Nega kvadrat", "Bitta jumla": "Ishorani yo'qotadi, katta xatoni jazolaydi, hosilasi oson"},
    {"Tushuncha": "Cost — kosa", "Bitta jumla": "Vazifa: kosaning tubini topish"},
    {"Tushuncha": "Gradient", "Bitta jumla": "Qiyalik: belgisi yo'nalishni, kattaligi tiklikni aytadi"},
    {"Tushuncha": "GD qoidasi", "Bitta jumla": "w := w - alpha * gradient"},
    {"Tushuncha": "Learning rate", "Bitta jumla": "Kichik - sekin, katta - portlaydi; oraliq tor"},
    {"Tushuncha": "Nega scaling kerak", "Bitta jumla": "Kosani dumaloq qiladi, bitta alpha hammasiga yetadi"},
    {"Tushuncha": "Mini-batch", "Bitta jumla": "Amalda eng ko'p ishlatiladigan variant"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Cost funksiya | Xatoni bitta son bilan o'lchaydi (MSE) |
| Nega kvadrat | Ishorani yo'qotadi, katta xatoni jazolaydi, hosilasi oson |
| Cost — kosa | Vazifa: kosaning tubini topish |
| Gradient | Qiyalik: belgisi yo'nalishni, kattaligi tiklikni aytadi |
| GD qoidasi | w := w - alpha * gradient |
| Learning rate | Kichik - sekin, katta - portlaydi; oraliq tor |
| Nega scaling kerak | Kosani dumaloq qiladi, bitta alpha hammasiga yetadi |
| Mini-batch | Amalda eng ko'p ishlatiladigan variant |
Keyingi bobda: chiziqli regressiya uchun gradient descent kerak emas ekan. Javobni bitta formula bilan ham topish mumkin — va qachon qaysi birini tanlash kerakligini ko'ramiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.