ML nima va qachon kerak
Sahna: qoida o'sib ketdi
Siz ijara agentligida dasturchisiz. Direktor so'radi: "Qaysi kvartira tez ijaraga ketishini oldindan ayta olasanmi?"
Siz o'ylaysiz. Oson — qoida yozaman.
if narx < 500:
    return "tez ketadi"
Ishladi, lekin yaxshi emas. Mebelni ham qo'shasiz:
if narx < 500 and mebel:
    return "tez ketadi"
Keyin tumanni. Keyin metroga masofani. Keyin qavatni. Ikki haftadan keyin kodingiz uzun if zanjiriga aylanadi, hech kim uni tushunmaydi, va yangi tuman qo'shilsa hammasini qaytadan yozish kerak.
Mana shu nuqtada ML kerak bo'ladi.
An'anaviy dasturlash va ML — farqi bitta narsada
import pandas as pd
show(pd.DataFrame([
    {"": "An'anaviy dasturlash", "Siz berasiz": "Ma'lumot + QOIDA", "Kompyuter beradi": "Javob"},
    {"": "Machine Learning", "Siz berasiz": "Ma'lumot + JAVOB", "Kompyuter beradi": "QOIDA"},
]))
| Siz berasiz | Kompyuter beradi | |
|---|---|---|
| An'anaviy dasturlash | Ma'lumot + QOIDA | Javob |
| Machine Learning | Ma'lumot + JAVOB | QOIDA |
Shu ikki qatorda butun ML bor.
An'anaviy dasturlashda qoidani siz yozasiz. ML da siz kompyuterga minglab misol berasiz ("bu kvartira tez ketdi, bu ketmadi") va u qoidani o'zi topadi.
diagramma(
    {
        "Ma'lumot\n(kvartira xususiyatlari)": (0, 0, 3.2, 1.1, "manba"),
        "QOIDA\n(siz yozasiz: if/else)": (0, 1.6, 3.2, 1.1, "qayta"),
        "Javob\n(tez ketadi / ketmaydi)": (0, 3.2, 3.2, 1.1, "saqlash"),
        "Ma'lumot\n(kvartira xususiyatlari) ": (5.2, 0, 3.2, 1.1, "manba"),
        "Javob\n(tarixdan: ketdi / ketmadi)": (5.2, 1.6, 3.2, 1.1, "manba"),
        "QOIDA\n(model o'zi topadi)": (5.2, 3.2, 3.2, 1.1, "xizmat"),
    },
    [
        ("Ma'lumot\n(kvartira xususiyatlari)", "QOIDA\n(siz yozasiz: if/else)"),
        ("QOIDA\n(siz yozasiz: if/else)", "Javob\n(tez ketadi / ketmaydi)"),
        ("Ma'lumot\n(kvartira xususiyatlari) ", "QOIDA\n(model o'zi topadi)"),
        ("Javob\n(tarixdan: ketdi / ketmadi)", "QOIDA\n(model o'zi topadi)"),
    ],
    nom="an_vs_ml.png",
    izoh="Chapda: an'anaviy dasturlash. O'ngda: machine learning. Qoida va javobning o'rni almashgan.",
)
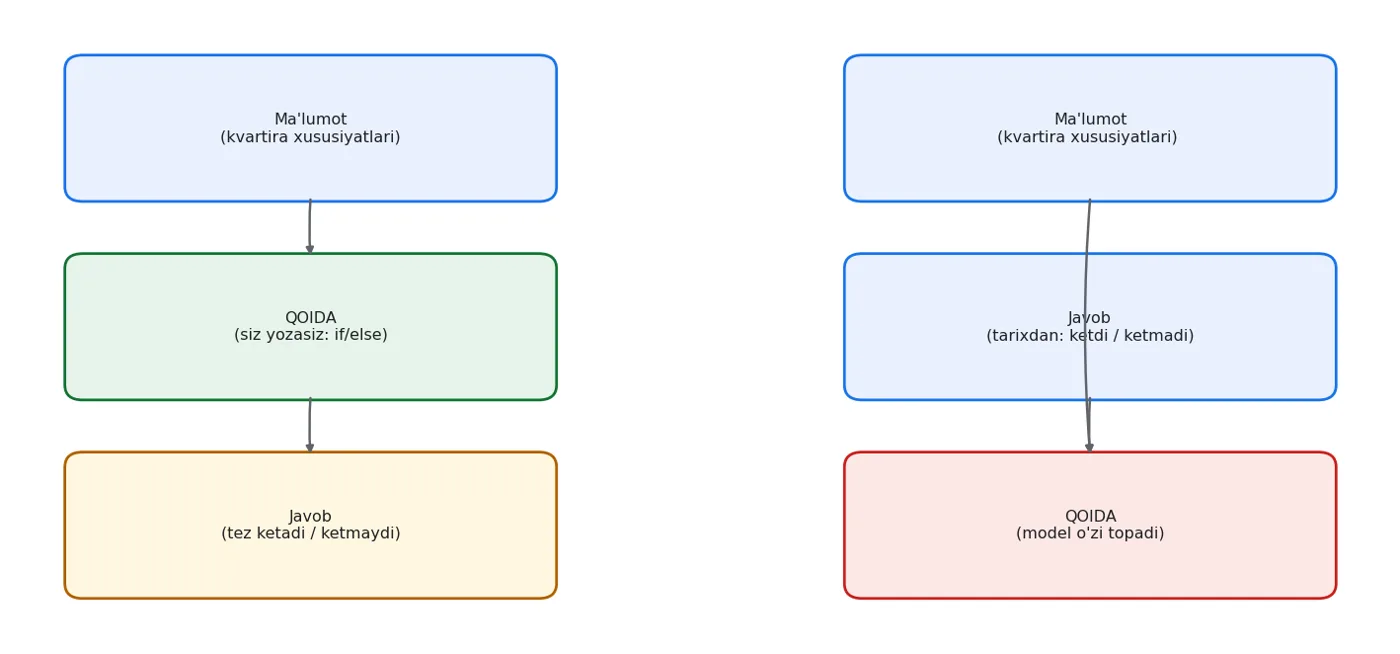
Chapda: an'anaviy dasturlash. O'ngda: machine learning. Qoida va javobning o'rni almashgan.
Har bir algoritm ortidagi yagona g'oya
Butun kitobda o'nlab algoritm ko'rasiz. Ularning hammasi bitta narsani qiladi:
Y = f(X)
- X — bilganingiz (xonalar soni, maydon, tuman, metroga masofa)
- Y — bilmoqchi bo'lganingiz (tez ketadimi)
- f — ularni bog'laydigan qoida
Linear regression, decision tree, neyron tarmoq — ular faqat f ni qanday shaklda izlashi bilan farq qiladi. Vazifa bir xil.
df = pd.read_csv(DATA / "uy_ijara.csv")
X_misol = df[["xonalar", "maydon_m2", "metro_km", "mebel"]].head(5)
y_misol = df["ijaraga_berildi_30k"].head(5)
print("X — model KO'RADIGAN narsa:")
print(X_misol.to_string(index=False))
print()
print("y — model TOPISHI kerak bo'lgan javob:")
print(y_misol.to_string(index=False))
X — model KO'RADIGAN narsa:
 xonalar  maydon_m2  metro_km  mebel
       2       40.6      1.43      1
       2       55.5      4.18      1
       5      114.0      3.84      1
       3       72.1      2.99      1
       2       46.4      4.58      0

y — model TOPISHI kerak bo'lgan javob:
0
0
0
0
1
Qachon ML kerak — va qachon kerak EMAS
Bu — eng ko'p o'tkazib yuboriladigan savol. Ko'p loyiha shu yerda o'ladi.
show(pd.DataFrame([
    {"Holat": "Qoida oddiy va o'zgarmaydi", "ML kerakmi": "YO'Q",
     "Nega": "`if yosh < 18` — buni model bilan qilish ahmoqlik"},
    {"Holat": "Qoida bor, lekin juda murakkab", "ML kerakmi": "HA",
     "Nega": "Yuzni tanish, matnni tushunish — qo'lda yozilmaydi"},
    {"Holat": "Qoida vaqt o'tib o'zgaradi", "ML kerakmi": "HA",
     "Nega": "Bozor narxi, moda, foydalanuvchi xatti-harakati"},
    {"Holat": "Ma'lumot YO'Q yoki juda kam", "ML kerakmi": "YO'Q",
     "Nega": "100 qator bilan model qurilmaydi — avval ma'lumot yig'ing"},
    {"Holat": "Xato juda qimmat, 100% aniqlik kerak", "ML kerakmi": "EHTIYOT",
     "Nega": "ML hech qachon 100% bermaydi. Odam nazorati kerak"},
    {"Holat": "Nega shunday javob berdi — tushuntirish shart", "ML kerakmi": "EHTIYOT",
     "Nega": "Bank krediti, tibbiyot. Oddiy model tanlang (25-bob SHAP)"},
]))
| Holat | ML kerakmi | Nega |
|---|---|---|
| Qoida oddiy va o'zgarmaydi | YO'Q | `if yosh < 18` — buni model bilan qilish ahmoqlik |
| Qoida bor, lekin juda murakkab | HA | Yuzni tanish, matnni tushunish — qo'lda yozilmaydi |
| Qoida vaqt o'tib o'zgaradi | HA | Bozor narxi, moda, foydalanuvchi xatti-harakati |
| Ma'lumot YO'Q yoki juda kam | YO'Q | 100 qator bilan model qurilmaydi — avval ma'lumot yig'ing |
| Xato juda qimmat, 100% aniqlik kerak | EHTIYOT | ML hech qachon 100% bermaydi. Odam nazorati kerak |
| Nega shunday javob berdi — tushuntirish shart | EHTIYOT | Bank krediti, tibbiyot. Oddiy model tanlang (25-bob SHAP) |
Birinchi savol "qaysi algoritm" emas
Yangi loyihada birinchi savol: "buni oddiy qoida bilan hal qilsa bo'ladimi?"
Agar ha — qoida yozing. U tezroq, arzonroq, tushunarli va buzilmaydi.
6-bobda biz aynan shuni o'lchaymiz: oddiy qoida ML dan qanchalik orqada.
ML turlari
show(pd.DataFrame([
    {"Turi": "Supervised (nazorat ostida)", "Ma'lumot": "X va y — javoblar BOR",
     "Misol": "Kvartira tez ketadimi; narx qancha", "Kitobda": "4-21-bob"},
    {"Turi": "Unsupervised (nazoratsiz)", "Ma'lumot": "Faqat X — javob YO'Q",
     "Misol": "Mijozlarni guruhlarga bo'lish", "Kitobda": "26-28-bob"},
    {"Turi": "Reinforcement (mustahkamlash)", "Ma'lumot": "Harakat va mukofot",
     "Misol": "O'yin, robot boshqaruvi", "Kitobda": "yo'q (alohida soha)"},
]))
| Turi | Ma'lumot | Misol | Kitobda |
|---|---|---|---|
| Supervised (nazorat ostida) | X va y — javoblar BOR | Kvartira tez ketadimi; narx qancha | 4-21-bob |
| Unsupervised (nazoratsiz) | Faqat X — javob YO'Q | Mijozlarni guruhlarga bo'lish | 26-28-bob |
| Reinforcement (mustahkamlash) | Harakat va mukofot | O'yin, robot boshqaruvi | yo'q (alohida soha) |
Bu kitobning asosiy qismi — supervised. Chunki amaliyotdagi ishlarning ko'pi shunday.
Classification va regression
Supervised ikkiga bo'linadi. Farq faqat y ning turida.
print("Bizning faylda IKKITA target bor — ikki xil vazifa:")
print()
print(f"ijaraga_berildi_30k : {sorted(df.ijaraga_berildi_30k.unique().tolist())}  -> {df.ijaraga_berildi_30k.nunique()} xil qiymat")
print("  => CLASSIFICATION (yorliq bashorat qilish)")
print()
print(f"narx_usd            : {df.narx_usd.min()} .. {df.narx_usd.max()}  -> {df.narx_usd.nunique()} xil qiymat")
print("  => REGRESSION (son bashorat qilish)")
Bizning faylda IKKITA target bor — ikki xil vazifa:

ijaraga_berildi_30k : [0, 1]  -> 2 xil qiymat
  => CLASSIFICATION (yorliq bashorat qilish)

narx_usd            : 225 .. 1515  -> 207 xil qiymat
  => REGRESSION (son bashorat qilish)
show(pd.DataFrame([
    {"": "Classification", "y nima": "Yorliq (toifa)", "Misol": "spam/spam emas, 3 tur gul",
     "Metrika": "accuracy, F1, recall", "Kitobda": "7-9-bob"},
    {"": "Regression", "y nima": "Uzluksiz son", "Misol": "narx, harorat, vaqt",
     "Metrika": "RMSE, MAE, R2", "Kitobda": "14-bob"},
]))
| y nima | Misol | Metrika | Kitobda | |
|---|---|---|---|---|
| Classification | Yorliq (toifa) | spam/spam emas, 3 tur gul | accuracy, F1, recall | 7-9-bob |
| Regression | Uzluksiz son | narx, harorat, vaqt | RMSE, MAE, R2 | 14-bob |
"Yulduzlar soni 1-5" — bu classification mi, regression mi?
Ikkisi ham bo'lishi mumkin, va bu sizning qaroringiz.
Classification deb olsangiz: model 3 va 4 ni "ikki xil toifa" deb ko'radi, ularning yaqinligini bilmaydi. Regression deb olsangiz: model 3.7 chiqarishi mumkin, va 1 bilan 5 orasidagi masofani tushunadi.
Amalda reyting uchun ko'pincha regression yaxshiroq ishlaydi. Lekin sinab ko'rish kerak — taxmin qilmang, o'lchang.
ML ishining uchta buyrug'i
sklearn dagi hamma model bir xil uch buyruqni tushunadi. Algoritmni almashtirsangiz ham, bu uchta o'zgarmaydi.
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

son = ["xonalar", "maydon_m2", "metro_km", "mebel"]
X, y = df[son], df["ijaraga_berildi_30k"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

model = DecisionTreeClassifier(max_depth=4, random_state=42)

model.fit(X_tr, y_tr)                       # 1. O'RGAN
bashorat = model.predict(X_te)              # 2. BASHORAT QIL
ball = model.score(X_te, y_te)              # 3. BAHOLA

print(f"fit()     -> model o'rgandi, {len(X_tr)} qatordan")
print(f"predict() -> {len(bashorat)} ta bashorat, masalan: {bashorat[:8].tolist()}")
print(f"score()   -> {ball:.4f}")
fit()     -> model o'rgandi, 840 qatordan
predict() -> 360 ta bashorat, masalan: [0, 1, 0, 0, 1, 1, 1, 1]
score()   -> 0.7417
Modelni almashtiramiz — faqat bitta qator o'zgaradi:
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier

for nom, m in [("DecisionTree", DecisionTreeClassifier(max_depth=4, random_state=42)),
               ("LogisticRegression", LogisticRegression(max_iter=2000)),
               ("RandomForest", RandomForestClassifier(n_estimators=100, random_state=42)),
               ("KNN", KNeighborsClassifier())]:
    m.fit(X_tr, y_tr)
    print(f"  {nom:20s} score = {m.score(X_te, y_te):.4f}")
  DecisionTree         score = 0.7417
  LogisticRegression   score = 0.7639
  RandomForest         score = 0.6806
  KNN                  score = 0.6917
Bu kitobni o'qishning kaliti
fit / predict / score — bu uchta so'z 20 ta algoritm uchun bir xil. Shuning uchun yangi algoritmni o'rganish oson: siz faqat u qanday ishlaydi va qachon mos keladi degan savolga javob izlaysiz. Kod naqshi o'zgarmaydi.
Overfitting: yodlash va tushunish
Yuqoridagi jadvalda DecisionTree da max_depth=4 yozilgan. Nega chegara qo'ydim? Chegarani olib tashlasam nima bo'ladi?
print(f"{'max_depth':>10} {'train ball':>12} {'test ball':>11} {'farq':>8}")
print("-" * 44)
for d in [2, 4, 8, 15, None]:
    m = DecisionTreeClassifier(max_depth=d, random_state=42).fit(X_tr, y_tr)
    tr_b, te_b = m.score(X_tr, y_tr), m.score(X_te, y_te)
    belgi = "   <-- YODLADI" if tr_b - te_b > 0.15 else ""
    print(f"{str(d):>10} {tr_b:>12.4f} {te_b:>11.4f} {tr_b-te_b:>8.4f}{belgi}")
 max_depth   train ball   test ball     farq
--------------------------------------------
         2       0.6952      0.7611  -0.0659
         4       0.7048      0.7417  -0.0369
         8       0.7869      0.7139   0.0730
        15       0.9143      0.6778   0.2365   <-- YODLADI
      None       1.0000      0.6583   0.3417   <-- YODLADI
Chegara olib tashlanganda daraxt train da deyarli mukammal bo'ladi — va test da yomonlashadi.
Bu overfitting: model qoidani o'rganmagan, u javoblarni yodlagan.
show(pd.DataFrame([
    {"Holat": "Underfitting", "Train ball": "PAST", "Test ball": "PAST",
     "Sabab": "Model juda oddiy", "Yechim": "Kuchliroq model, ko'proq xususiyat"},
    {"Holat": "Yaxshi", "Train ball": "Yaxshi", "Test ball": "Yaxshi, yaqin",
     "Sabab": "Muvozanat topilgan", "Yechim": "Shu yerda to'xtaysiz"},
    {"Holat": "Overfitting", "Train ball": "JUDA BALAND", "Test ball": "PAST",
     "Sabab": "Model yodlagan", "Yechim": "Soddalashtirish, regularizatsiya, ko'proq ma'lumot"},
]))
| Holat | Train ball | Test ball | Sabab | Yechim |
|---|---|---|---|---|
| Underfitting | PAST | PAST | Model juda oddiy | Kuchliroq model, ko'proq xususiyat |
| Yaxshi | Yaxshi | Yaxshi, yaqin | Muvozanat topilgan | Shu yerda to'xtaysiz |
| Overfitting | JUDA BALAND | PAST | Model yodlagan | Soddalashtirish, regularizatsiya, ko'proq ma'lumot |
Bu — bias-variance tradeoff, va u 11-13-boblarda matematik tomondan ochiladi. Hozir bitta narsani eslab qolsangiz yetarli: train balli test ballidan ancha baland bo'lsa — ishonmang.
Imtihonga o'xshatma
Talaba imtihonga tayyorlanadi. Ikki yo'l bor:
- Mavzuni tushunadi -> yangi savolga ham javob beradi
- Javoblarni yodlaydi -> aynan o'sha savollarga javob beradi, boshqasiga yo'q
Ikkinchi talaba uyda ishlagan masalalarda 100% oladi (train ball baland), imtihonda yiqiladi (test ball past).
Model ham xuddi shunday. Shuning uchun biz uni ko'rmagan ma'lumotda sinaymiz (5-bob).
Asosiy atamalar
show(pd.DataFrame([
    {"Atama": "Feature (xususiyat)", "Ma'nosi": "Kirish ustuni — X", "Bizda": "xonalar, maydon_m2, tuman"},
    {"Atama": "Target (nishon)", "Ma'nosi": "Bashorat qilinadigan ustun — y", "Bizda": "ijaraga_berildi_30k"},
    {"Atama": "Namuna (sample)", "Ma'nosi": "Bitta qator", "Bizda": "Bitta e'lon"},
    {"Atama": "Label (yorliq)", "Ma'nosi": "Classification dagi target qiymati", "Bizda": "0 yoki 1"},
    {"Atama": "Train", "Ma'nosi": "Model o'rganadigan qism", "Bizda": "840 qator"},
    {"Atama": "Test", "Ma'nosi": "Model ko'rmagan qism", "Bizda": "360 qator"},
    {"Atama": "Hyperparameter", "Ma'nosi": "SIZ qo'yadigan sozlama", "Bizda": "max_depth=4"},
    {"Atama": "Parametr (weight)", "Ma'nosi": "Model O'ZI o'rganadigan son", "Bizda": "koeffitsiyentlar"},
]))
| Atama | Ma'nosi | Bizda |
|---|---|---|
| Feature (xususiyat) | Kirish ustuni — X | xonalar, maydon_m2, tuman |
| Target (nishon) | Bashorat qilinadigan ustun — y | ijaraga_berildi_30k |
| Namuna (sample) | Bitta qator | Bitta e'lon |
| Label (yorliq) | Classification dagi target qiymati | 0 yoki 1 |
| Train | Model o'rganadigan qism | 840 qator |
| Test | Model ko'rmagan qism | 360 qator |
| Hyperparameter | SIZ qo'yadigan sozlama | max_depth=4 |
| Parametr (weight) | Model O'ZI o'rganadigan son | koeffitsiyentlar |
Hyperparameter va parametr — chalkashtirmang
Parametr — modelning o'zi fit() paytida topadigan son (chiziq koeffitsiyenti, daraxt bo'linish chegarasi).
Hyperparameter — siz fit() dan OLDIN qo'yadigan sozlama (max_depth, n_estimators, C).
Intervyuda eng ko'p so'raladigan juftliklardan biri. 23-bob hyperparameter larni tanlashga bag'ishlangan.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "ML ning mohiyati", "Bitta jumla": "Qoidani siz yozmaysiz, model ma'lumotdan topadi"},
    {"Tushuncha": "Y = f(X)", "Bitta jumla": "Hamma algoritm shuni qiladi, faqat f ni boshqacha izlaydi"},
    {"Tushuncha": "Qachon ML kerak emas", "Bitta jumla": "Qoida oddiy bo'lsa yoki ma'lumot kam bo'lsa"},
    {"Tushuncha": "Classification / regression", "Bitta jumla": "Farq faqat y ning turida — yorliq yoki son"},
    {"Tushuncha": "fit / predict / score", "Bitta jumla": "20 ta algoritm uchun bir xil uch buyruq"},
    {"Tushuncha": "Overfitting", "Bitta jumla": "Train baland, test past — model yodlagan"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| ML ning mohiyati | Qoidani siz yozmaysiz, model ma'lumotdan topadi |
| Y = f(X) | Hamma algoritm shuni qiladi, faqat f ni boshqacha izlaydi |
| Qachon ML kerak emas | Qoida oddiy bo'lsa yoki ma'lumot kam bo'lsa |
| Classification / regression | Farq faqat y ning turida — yorliq yoki son |
| fit / predict / score | 20 ta algoritm uchun bir xil uch buyruq |
| Overfitting | Train baland, test past — model yodlagan |
Keyingi bobda: ma'lumot ko'pincha CSV da emas, ma'lumotlar bazasida bo'ladi. Uni qanday olamiz?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.