Yangi dataset: 12 qadam
Kitob to'liq — 48 bob
Barcha boblar yozilgan: 0–47. Har bir raqam build.py tomonidan bajarilgan koddan olingan — qo'lda yozilgan yoki taxmin qilingan raqam yo'q.
| Qism | Boblar | Mavzu |
|---|---|---|
| 0 | 0 | Yangi dataset: 12 qadam protokoli |
| 1 | 1–4 | ML nima · SQL · vizualizatsiya · ma'lumot tayyorlash |
| 2 | 5–10 | Split va leakage · baza · metrikalar · ROC/PR · CV · xato tahlili |
| 3 | 11–13 | Vektor va matritsa · gradient descent · normal tenglama |
| 4 | 14–21 | Linear · logistic · regularizatsiya · daraxt · forest · boosting · KNN/Bayes · SVM |
| 5 | 22–25 | Feature engineering · tuning · stacking · SHAP |
| 6 | 26–28 | PCA · klasterlash · LDA |
| 7 | 29–35 | Neyron tarmoq · backprop · Keras · PyTorch · CNN · RNN/LSTM · attention |
| 8 | 36–40 | Zanjir: ma'lumot yig'ish → dataset → fine-tuning → saqlash → Django API |
| 9 | 41–44 | Tahrirsiz yurish · uchta mustaqil mashq |
| Ilova | 45–47 | Chalkashlik-yechgich · intervyu savollari · cheat sheet |
Qayerdan boshlash kerak:
- Yangi dataset qo'lingizda bo'lsa — shu bob (0), keyin 41-bob.
- Nazariyani mustahkamlamoqchi bo'lsangiz — 1-bobdan ketma-ket.
- Biror tushuncha chalkash bo'lsa — 45-bob.
- Loyihani ishga tushirmoqchi bo'lsangiz — 8-qism (36–40).
Ma'lumot to'plamlari: qaysi biri haqiqiy, qaysi biri sun'iy
Bu halol bo'lishi kerak, chunki butun kitob o'lchangan raqamlarga asoslangan.
| Fayl | Turi | Izoh |
|---|---|---|
uy_ijara.csv |
sun'iy | datasets/generate.py qat'iy seed bilan quradi. Ichiga tuzoqlar ATAYLAB qo'yilgan |
talaba_bitirdi.csv |
sun'iy | Shu generatordan; yashirin leakage bilan (44-bob) |
titanic.csv |
haqiqiy | Kaggle/seaborn dataseti |
penguins.csv |
haqiqiy | Palmer Penguins |
iflos_savdo.csv |
haqiqiy iflos | Data Analytics kursidan, tozalanmagan holida |
Sun'iy ma'lumot — yomon narsa emas. U takrorlanadigan bo'ladi: siz ham, men ham, talabangiz ham aynan bir xil raqamni ko'radi. Haqiqiy datasetlarda esa tuzoqlar o'ylab topilmagan — ular o'z-o'zidan bor.
Kodni ko'chirganda: `DATA` nima
Kitobdagi hamma blokda shunday yozilgan:
df = pd.read_csv(DATA / "uy_ijara.csv")
DATA — bu kitob qurilganda avtomatik beriladigan papka yo'li. Siz kodni ko'chirsangiz, u sizda bo'lmaydi va NameError olasiz.
Yechimi — faylingizning boshiga bitta qator qo'shish:
from pathlib import Path

DATA = Path("datasets")      # CSV fayllar `datasets` papkasida bo'lsa
# DATA = Path(".")           # CSV fayllar kod bilan BIR papkada bo'lsa

ISH = Path("ish")            # 36-40-boblarda loyiha fayllari shu yerga yoziladi
ISH.mkdir(exist_ok=True)
ISH — 8-qismdagi (36-40-bob) loyiha papkasi. Kitob u yerga scraper, tozalash va API fayllarini yozadi. Boshqa boblarda u kerak emas.
Shundan keyin kitobdagi har qanday blok o'zgartirmasdan ishlaydi.
Kerakli kutubxonalar:
pip install pandas numpy scikit-learn matplotlib seaborn
Tanish holat
Soat 21:00. Kompyuter oldida o'tirasiz. Kaggle dan yangi fayl yuklab oldingiz: uy_ijara.csv.
Ochasiz. 1200 qator, 13 ustun. Ekranga qaraysiz.
Va... to'xtaysiz.
Nimadan boshlash kerak? Qaysi ustun muhim? LogisticRegression ni chaqirsam bo'ladimi? Qaysi ustunni bashorat qilaman? Natija chiqsa, u yaxshi ekanini qaydan bilaman?
Bu holat sizning aybingiz emas. Darslarda sizga har doim tayyor X va y berilgan. Hech kim sizga bitta CSV fayl berib, "mana, ishla" demagan. Siz algoritmlarni o'rgandingiz — lekin ishni o'rganmadingiz.
Bu bob shuni tuzatadi.
Nega dasturchi ham to'xtaydi
Taqqoslash qilaylik.
Mashina haydashni o'rganayotgan odam ikki xil narsani o'rganadi:
- Mexanika: gaz, tormoz, uzatma, rul.
- Tartib: mashinaga o'tirdingiz — avval nima? Kamar. Keyin oyna. Keyin orqa ko'rinish. Keyin dvigatel. Keyin uzatma.
Mexanikani biladigan, lekin tartibni bilmaydigan odam mashinada o'tiradi va qotib qoladi. U gazni ham, tormozni ham biladi — lekin birinchi nima qilishni bilmaydi.
ML da ham aynan shunday. Siz fit() va predict() ni bilasiz. Bu — gaz va tormoz. Lekin tartib yo'q.
Quyida — tartib. O'n ikki qadam. Har bir qadam bitta savolga javob beradi va bitta qarorni chiqaradi.
Bu bobni qanday ishlatish
Bu bobni bir marta o'qing. Keyin oxirgi sahifadagi kartani chiqarib, stolingizga qo'ying. Yangi dataset ko'rganingizda — kartani o'qing, o'ylamang. Bir-ikki oydan keyin karta kerak bo'lmaydi.
Protokol: 12 qadam
import pandas as pd
show(pd.DataFrame([
    {"Qadam": 1,  "Nima qilaman": "Faylni ochaman", "Chiqadigan qaror": "Nechta qator, nechta ustun — yozib qo'yaman"},
    {"Qadam": 2,  "Nima qilaman": "Target ni nomlayman", "Chiqadigan qaror": "Bitta jumla: nimani nimadan bashorat qilaman"},
    {"Qadam": 3,  "Nima qilaman": "Target turini ko'raman", "Chiqadigan qaror": "Regression / classification / clustering"},
    {"Qadam": 4,  "Nima qilaman": "Target ni SANAYMAN", "Chiqadigan qaror": "Nomutanosibmi? Bazam qanday?"},
    {"Qadam": 5,  "Nima qilaman": "HOZIR split qilaman", "Chiqadigan qaror": "Test to'plami qulflanadi"},
    {"Qadam": 6,  "Nima qilaman": "Dummy model", "Chiqadigan qaror": "O'tish chegarasi — bitta raqam"},
    {"Qadam": 7,  "Nima qilaman": "Zaharli ustunlarni topaman", "Chiqadigan qaror": "Tashlanadigan ustunlar ro'yxati"},
    {"Qadam": 8,  "Nima qilaman": "Missing va turlar", "Chiqadigan qaror": "Har ustun uchun: to'ldirish yoki tashlash"},
    {"Qadam": 9,  "Nima qilaman": "Pipeline da bitta oddiy model", "Chiqadigan qaror": "Dummy dan yaxshimi?"},
    {"Qadam": 10, "Nima qilaman": "Metrikani tanlayman", "Chiqadigan qaror": "Qaysi raqamga qarab hukm chiqaraman"},
    {"Qadam": 11, "Nima qilaman": "Xato qatorlarni O'QIYMAN", "Chiqadigan qaror": "Model nimani tushunmayapti"},
    {"Qadam": 12, "Nima qilaman": "Qaror qabul qilaman", "Chiqadigan qaror": "Bitta o'zgarish — va 9-qadamga qaytaman"},
]))
| Qadam | Nima qilaman | Chiqadigan qaror |
|---|---|---|
| 1 | Faylni ochaman | Nechta qator, nechta ustun — yozib qo'yaman |
| 2 | Target ni nomlayman | Bitta jumla: nimani nimadan bashorat qilaman |
| 3 | Target turini ko'raman | Regression / classification / clustering |
| 4 | Target ni SANAYMAN | Nomutanosibmi? Bazam qanday? |
| 5 | HOZIR split qilaman | Test to'plami qulflanadi |
| 6 | Dummy model | O'tish chegarasi — bitta raqam |
| 7 | Zaharli ustunlarni topaman | Tashlanadigan ustunlar ro'yxati |
| 8 | Missing va turlar | Har ustun uchun: to'ldirish yoki tashlash |
| 9 | Pipeline da bitta oddiy model | Dummy dan yaxshimi? |
| 10 | Metrikani tanlayman | Qaysi raqamga qarab hukm chiqaraman |
| 11 | Xato qatorlarni O'QIYMAN | Model nimani tushunmayapti |
| 12 | Qaror qabul qilaman | Bitta o'zgarish — va 9-qadamga qaytaman |
Endi shu o'n ikki qadamni haqiqiy faylda bosqichma-bosqich yuramiz. Har bir raqam — bajarilgan koddan.
1-qadam. Faylni ochaman
Birinchi uchta buyruq. Har doim shu uchtasi.
import pandas as pd

df = pd.read_csv(DATA / "uy_ijara.csv")

print("shakli:", df.shape)
print()
print(df.dtypes.to_string())
shakli: (1200, 13)

elon_id                 object
tuman                   object
xonalar                  int64
maydon_m2              float64
qavat                    int64
qavatlar_soni            int64
metro_km               float64
mebel                    int64
qurilgan_yil           float64
narx_matn               object
agent_komissiyasi        int64
narx_usd                 int64
ijaraga_berildi_30k      int64
Nimani ko'rdik:
- 1200 qator, 13 ustun. Kichik fayl. Bu yaxshi — tez ishlaydi, tez xato topamiz.
tuman,elon_id,narx_matn— object. Ya'ni matn.- Qolganlari — son.
E'tibor bering: narx_matn matn. Lekin nomida "narx" bor. Demak u son bo'lishi kerak edi. Birinchi shubha. 7-qadamda qaytamiz.
Endi qatorlarning o'ziga qaraymiz. Jadvalni ko'rmasdan ishlash — ko'zni yumib haydash bilan bir xil.
show(df.head(6))
| elon_id | tuman | xonalar | maydon_m2 | qavat | qavatlar_soni | metro_km | mebel | qurilgan_yil | narx_matn | agent_komissiyasi | narx_usd | ijaraga_berildi_30k |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| UZ-100000 | Chilonzor | 2 | 40.6 | 2 | 14 | 1.43 | 1 | 2 016 | 9 500 000 so'm | 0 | 760 | 0 |
| UZ-100001 | Yakkasaroy | 2 | 55.5 | 1 | 2 | 4.18 | 1 | 1 977 | 6 875 000 so'm | 0 | 550 | 0 |
| UZ-100002 | Mirzo Ulug'bek | 5 | 114 | 2 | 4 | 3.84 | 1 | 2 010 | 17 687 500 so'm | 0 | 1 415 | 0 |
| UZ-100003 | Mirzo Ulug'bek | 3 | 72.1 | 3 | 4 | 2.99 | 1 | 2 007 | 12 312 500 so'm | 0 | 985 | 0 |
| UZ-100004 | Chilonzor | 2 | 46.4 | 2 | 2 | 4.58 | 0 | 1 989 | 6 875 000 so'm | 275 | 550 | 1 |
| UZ-100005 | Olmazor | 3 | 61 | 9 | 11 | 1.9 | 0 | 1 987 | 7 750 000 so'm | 310 | 620 | 1 |
`df.head()` ni o'tkazib yubormang
Men ko'p talabani ko'rganman: read_csv dan keyin to'g'ridan-to'g'ri fit() ga o'tadi. Keyin bir soat xato izlaydi. head() bitta qarashda narx_matn ning matn ekanini, elon_id ning foydasizligini ko'rsatadi. Bir sekund — bir soatni tejaydi.
2-qadam. Target ni nomlayman
Bu qadamda kod yo'q. Bitta jumla yozasiz.
"Men ijaraga 30 kun ichida berilishini kvartiraning xususiyatlaridan bashorat qilaman."
Shu jumlani yozmasdan oldinga o'tmang. Agar jumlani yozolmasangiz — demak muammoni tushunmadingiz, va hech qanday model yordam bermaydi.
Bu faylda ikkita target bor:
| Ustun | Ma'nosi | Vazifa |
|---|---|---|
narx_usd |
Oyiga ijara narxi | son bashorat qilish |
ijaraga_berildi_30k |
30 kun ichida berildimi | ha/yo'q bashorat qilish |
Biz ikkinchisini olamiz. Birinchisi 14-bobda.
Nega aynan shu savol
"Bu kvartira tez ijaraga beriladimi?" — bu haqiqiy biznes savoli. Agentlik buni bilsa, narxni oldindan tuzatadi. Agar savolingiz hech kimga foyda keltirmasa, model qurish — vaqtni behuda sarflash.
3-qadam. Target turini ko'raman
print("ijaraga_berildi_30k:")
print("  turi             :", df.ijaraga_berildi_30k.dtype)
print("  unikal qiymatlar :", sorted(df.ijaraga_berildi_30k.unique().tolist()))
print()
print("narx_usd:")
print("  turi             :", df.narx_usd.dtype)
print("  unikal qiymatlar :", df.narx_usd.nunique(), "ta")
ijaraga_berildi_30k:
  turi             : int64
  unikal qiymatlar : [0, 1]

narx_usd:
  turi             : int64
  unikal qiymatlar : 207 ta
Qoida juda oddiy:
show(pd.DataFrame([
    {"Target qanday": "Ikki qiymat (0/1, ha/yo'q)", "Vazifa": "Binary classification"},
    {"Target qanday": "Bir nechta yorliq (3-10 xil)", "Vazifa": "Multiclass classification"},
    {"Target qanday": "Uzluksiz son (narx, harorat, vaqt)", "Vazifa": "Regression"},
    {"Target qanday": "Target YO'Q", "Vazifa": "Clustering yoki PCA"},
]))
| Target qanday | Vazifa |
|---|---|
| Ikki qiymat (0/1, ha/yo'q) | Binary classification |
| Bir nechta yorliq (3-10 xil) | Multiclass classification |
| Uzluksiz son (narx, harorat, vaqt) | Regression |
| Target YO'Q | Clustering yoki PCA |
Bizda [0, 1] — ikki qiymat. Demak binary classification. Qaror qabul qilindi.
narx_usd da 207 xil qiymat — u uzluksiz son, demak regression bo'lardi.
4-qadam. Target ni SANAYMAN
Bu — eng ko'p o'tkazib yuboriladigan qadam. Va eng qimmatga tushadigani.
nisbat = df.ijaraga_berildi_30k.value_counts(normalize=True).sort_index()
print("0 (berilmadi):", f"{nisbat[0]:.1%}")
print("1 (berildi)  :", f"{nisbat[1]:.1%}")
print()
print("Agar model HAMMAGA '1' desa, accuracy =", f"{nisbat[1]:.1%}")
0 (berilmadi): 49.3%
1 (berildi)  : 50.7%

Agar model HAMMAGA '1' desa, accuracy = 50.7%
Mana shu raqam — 50.7% — sizning dushmaningiz. Nega?
Chunki hech narsa o'rganmagan model ham shuncha oladi. "Hamma kvartira ijaraga beriladi" degan model 50.7% accuracy ko'rsatadi. Agar siz 52% olsangiz va xursand bo'lsangiz — siz o'zingizni aldadingiz.
Bu dataset mehribon. Haqiqiy ma'lumot unday emas.
Bizda 50/50 — bu qulay holat. Haqiqiy loyihalarda ko'pincha 95/5 yoki 99/1 bo'ladi. Fraud aniqlashda 0.1% fraud bo'ladi. O'sha yerda "hammaga yo'q" deydigan model 99.9% accuracy oladi va butunlay foydasiz bo'ladi. 8-bobda shu holatni alohida ko'ramiz.
Shuning uchun qoida: accuracy ni ko'rishdan oldin target ni sanang.
5-qadam. HOZIR split qilaman
Diqqat: bu qadam hozir bajariladi. Tozalashdan oldin. Scaling dan oldin. Grafik chizishdan oldin.
from sklearn.model_selection import train_test_split

X = df.drop(columns=["ijaraga_berildi_30k", "narx_usd"])
y = df["ijaraga_berildi_30k"]

X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

print(f"train: {len(X_tr)} qator, berildi {y_tr.mean():.1%}")
print(f"test : {len(X_te)} qator, berildi {y_te.mean():.1%}")
train: 840 qator, berildi 50.7%
test : 360 qator, berildi 50.6%
stratify=y nima qildi? Train va test da bir xil nisbat saqladi — ikkisida ham ~50.7%. Busiz tasodifan test da 60% chiqib qolishi va natijalaringiz yolg'on bo'lishi mumkin edi.
Nega hozir? Chunki keyin StandardScaler ishlatasiz. Agar scaler ni butun ma'lumotda o'rgatsangiz, u test to'plamining o'rtachasini va standart og'ishini "ko'radi". Model imtihon savollarini oldindan ko'rgan bo'ladi. Natija chiroyli chiqadi — va serverda yiqiladi.
Bu kitobdagi eng qimmat xato
Bu — data leakage. Eng xavfli tomoni: u xato bermaydi. Kod ishlaydi, raqam yaxshi chiqadi, siz xursand bo'lasiz. Muammo bir oydan keyin, modelni ishga tushirganingizda ko'rinadi.
Qoida: test to'plami seyfga qulflanadi. Unga faqat bir marta, eng oxirida qaraysiz.
6-qadam. Dummy model — o'tish chegarasi
Hozir siz birinchi "model" ni qurasiz. U hech narsa o'rganmaydi. U shunchaki eng ko'p uchraydigan javobni aytadi.
Nega bu kerak? Chunki sizga taqqoslash nuqtasi kerak. Termometrsiz "issiq" degan so'z ma'nosiz.
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score

dummy = DummyClassifier(strategy="most_frequent").fit(X_tr[["xonalar"]], y_tr)
baza = accuracy_score(y_te, dummy.predict(X_te[["xonalar"]]))

print(f"BAZA (hech narsa o'rganmagan model): {baza:.4f}")
print()
print("Shu raqamni yozib qo'ying. Modelingiz shundan YUQORI bo'lishi SHART.")
BAZA (hech narsa o'rganmagan model): 0.5056

Shu raqamni yozib qo'ying. Modelingiz shundan YUQORI bo'lishi SHART.
0.5056. Yozib qo'ydik. Endi bizda chegara bor.
Bu qadam bir qator kod. Lekin u sizni eng ko'p uchraydigan o'z-o'zini aldashdan saqlaydi: "accuracy 85% — zo'r!" degan xulosadan, target 85% bir sinfdan iborat bo'lganda.
7-qadam. Zaharli ustunlarni topaman
Endi ustunlarni birma-bir tekshiramiz. Uch xil zahar bor.
Zahar 1: har qatorda boshqa qiymat
print("Har ustunda nechta unikal qiymat (1200 qatordan):")
for ustun in X_tr.columns:
    n = X_tr[ustun].nunique()
    belgi = "   <-- SHUBHALI: deyarli har qatorda boshqa" if n > len(X_tr) * 0.9 else ""
    print(f"  {ustun:22s} {n:5d}{belgi}")
Har ustunda nechta unikal qiymat (1200 qatordan):
  elon_id                  840   <-- SHUBHALI: deyarli har qatorda boshqa
  tuman                      8
  xonalar                    5
  maydon_m2                521
  qavat                     16
  qavatlar_soni             15
  metro_km                 440
  mebel                      2
  qurilgan_yil              50
  narx_matn                193
  agent_komissiyasi         83
elon_id — 840 qatordan 840 xil qiymat. Bu identifikator, xususiyat emas. U hech narsani tushuntirmaydi.
Nega xavfli? Daraxt modeli har bir ID ni yodlab oladi va train da 100% beradi. Yangi e'lon kelganda — uning ID si daraxtda yo'q, model nima qilishni bilmaydi.
Qoida: ID, kod, telefon raqam, pasport raqami — tashlanadi.
Zahar 2: son bo'lishi kerak, lekin matn
print("narx_matn ning birinchi 3 qiymati:")
for v in X_tr.narx_matn.head(3):
    print("  ", repr(v))
print()
print("turi:", X_tr.narx_matn.dtype, "<-- object = matn")
narx_matn ning birinchi 3 qiymati:
   "12 125 000 so'm"
   "10 625 000 so'm"
   "11 687 500 so'm"

turi: object <-- object = matn
"9 500 000 so'm" — bu son, lekin pandas uni matn deb o'qidi: ichida bo'shliq va "so'm" bor.
Ikki yo'l bor: tozalab songa aylantirish, yoki tashlash. Lekin diqqat — narx_matn aslida narx_usd ning boshqa ko'rinishi, ya'ni ikkinchi target. Uni xususiyat sifatida ishlatish mumkin emas.
Zahar 3: eng xavflisi — leakage
tekshir = X_tr.assign(berildi=y_tr).groupby("berildi").agent_komissiyasi.agg(["mean", "min", "max"])
show(tekshir.reset_index())
| berildi | mean | min | max |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 1 | 335.775 | 110 | 610 |
Qarang. berildi = 0 bo'lganda komissiya har doim 0. berildi = 1 bo'lganda — har doim noldan katta.
Sababi oddiy: agent komissiyasini kvartira ijaraga berilgandan KEYIN oladi. Bashorat qilish paytida bu ustun hali mavjud bo'lmaydi.
Buni modelga bersak nima bo'ladi? Ko'rsataman.
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

halol = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel"]

m_halol = LogisticRegression(max_iter=2000).fit(X_tr[halol], y_tr)
m_zahar = LogisticRegression(max_iter=2000).fit(X_tr[halol + ["agent_komissiyasi"]], y_tr)

a_halol = accuracy_score(y_te, m_halol.predict(X_te[halol]))
a_zahar = accuracy_score(y_te, m_zahar.predict(X_te[halol + ["agent_komissiyasi"]]))

print(f"Halol xususiyatlar      : {a_halol:.4f}")
print(f"+ agent_komissiyasi     : {a_zahar:.4f}   <-- MUKAMMAL")
Halol xususiyatlar      : 0.7778
+ agent_komissiyasi     : 1.0000   <-- MUKAMMAL
1.0000. Yuz foiz. Hech qachon xato qilmaydigan model.
Agar siz buni ko'rib xursand bo'lsangiz — siz hozir o'zingizni aldadingiz. Model hech narsa o'rganmagan. U shunchaki javobni ko'rib turgan: "komissiya bor ekan, demak berilgan."
Bu modelni serverga qo'ysangiz, birinchi haqiqiy so'rovda yiqiladi — chunki yangi e'londa komissiya ustuni bo'lmaydi.
Mukammal natija — bayram emas, signal
Agar accuracy 0.99 dan oshsa, birinchi fikr "zo'r model" bo'lmasin. Birinchi fikr shu bo'lsin: "qaysi ustun javobni aytib turibdi?"
Tekshirish usuli: har bir xususiyatni target bilan guruhlab ko'ring (yuqoridagi groupby kabi). Agar bitta ustun target ni to'liq ajratsa — u leakage.
Savol: "bu ustun bashorat qilish paytida menda bo'ladimi?" Agar yo'q — tashlang.
Demak tashlanadigan ustunlar:
tashlanadi = {
    "elon_id": "identifikator — har qatorda boshqa",
    "narx_matn": "ikkinchi target ning matn ko'rinishi",
    "agent_komissiyasi": "LEAKAGE — ijaradan keyin ma'lum bo'ladi",
}
show(pd.DataFrame([{"Ustun": k, "Nega tashlanadi": v} for k, v in tashlanadi.items()]))
| Ustun | Nega tashlanadi |
|---|---|
| elon_id | identifikator — har qatorda boshqa |
| narx_matn | ikkinchi target ning matn ko'rinishi |
| agent_komissiyasi | LEAKAGE — ijaradan keyin ma'lum bo'ladi |
8-qadam. Missing va turlar
yoq = X_tr.isna().sum()
yoq = yoq[yoq > 0]
if len(yoq):
    print("Bo'sh qiymatlar bor:")
    for ustun, n in yoq.items():
        print(f"  {ustun:16s} {n:3d} ta ({n/len(X_tr):.1%})")
else:
    print("Bo'sh qiymat yo'q")
print()
print("Matn ustunlar (encoding kerak):")
for u in X_tr.select_dtypes("object").columns:
    print(f"  {u:16s} {X_tr[u].nunique()} xil qiymat")
Bo'sh qiymatlar bor:
  qurilgan_yil       5 ta (0.6%)

Matn ustunlar (encoding kerak):
  elon_id          840 xil qiymat
  tuman            8 xil qiymat
  narx_matn        193 xil qiymat
qurilgan_yil — train to'plamida 5 qatorda yo'q (0.6%). Kam. Uch yo'l bor:
| Yo'l | Qachon |
|---|---|
| Qatorni tashlash | Juda kam bo'lsa (< 1%) va ma'lumot ko'p bo'lsa |
| O'rtacha / medianaga to'ldirish | Son ustun, 5–30% yo'q bo'lsa |
| "Yo'q" degan alohida kategoriya | Yo'qligining o'zi ma'noga ega bo'lsa |
Biz medianaga to'ldiramiz — va buni Pipeline ichida qilamiz, chunki mediana faqat train dan olinishi kerak.
tuman — 8 xil matn qiymat. Model matnni tushunmaydi, raqamga aylantirish kerak. Lekin tuman da tartib yo'q (Chilonzor > Sergeli demaymiz), shuning uchun OneHotEncoder.
9-qadam. Pipeline da bitta oddiy model
Endi birinchi haqiqiy model. Diqqat: Pipeline ishlatamiz — bu tanlov emas, himoya.
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer

son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
matn = ["tuman"]

tayyorla = ColumnTransformer([
    ("son", Pipeline([
        ("toldir", SimpleImputer(strategy="median")),
        ("shkala", StandardScaler()),
    ]), son),
    ("matn", OneHotEncoder(handle_unknown="ignore"), matn),
])

quvur = Pipeline([
    ("tayyorla", tayyorla),
    ("model", LogisticRegression(max_iter=2000)),
])

quvur.fit(X_tr, y_tr)
aniqlik = accuracy_score(y_te, quvur.predict(X_te))

print(f"BAZA          : {baza:.4f}")
print(f"Birinchi model: {aniqlik:.4f}")
print(f"Farq          : {aniqlik - baza:+.4f}")
BAZA          : 0.5056
Birinchi model: 0.7778
Farq          : +0.2722
0.7778 — bazadan 0.27 ga yuqori. Model haqiqatan nimanidir o'rgandi.
Nega Pipeline muhim? Uchta sabab:
- Leakage dan himoya.
fit()chaqirilganda imputer va scaler faqat train dan o'rganadi. Siz adashishingiz mumkin emas — tuzilma ruxsat bermaydi. - Bitta obyekt. Modelni saqlaganingizda tozalash ham birga saqlanadi (39-bob).
- Cross-validation to'g'ri ishlaydi. Har bir fold da tozalash qaytadan bajariladi (9-bob).
Bitta eslab qolish kerak bo'lgan naqsh
Butun kitobda shu naqsh takrorlanadi:
ColumnTransformer (son uchun to'ldirish+shkala, matn uchun OneHot) → Pipeline → fit.
Modelni almashtirsangiz — faqat oxirgi qatorni o'zgartirasiz. Qolgani o'zgarmaydi.
10-qadam. Metrikani tanlayman
accuracy = 0.7778. Yetarlimi? Hali emas. Accuracy nimani yashiradi?
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score

bashorat = quvur.predict(X_te)
tn, fp, fn, tp = confusion_matrix(y_te, bashorat).ravel()

print(f"TN={tn}  FP={fp}  FN={fn}  TP={tp}")
print()
print(f"Accuracy : {aniqlik:.4f}")
print(f"Precision: {precision_score(y_te, bashorat):.4f}  = TP/(TP+FP) = {tp}/({tp}+{fp})")
print(f"Recall   : {recall_score(y_te, bashorat):.4f}  = TP/(TP+FN) = {tp}/({tp}+{fn})")
print(f"F1       : {f1_score(y_te, bashorat):.4f}")
TN=126  FP=52  FN=28  TP=154

Accuracy : 0.7778
Precision: 0.7476  = TP/(TP+FP) = 154/(154+52)
Recall   : 0.8462  = TP/(TP+FN) = 154/(154+28)
F1       : 0.7938
Endi batafsil ko'rinadi. Model 206 ta kvartirani "tez ijaraga beriladi" dedi (154 + 52) va 154 tasida to'g'ri chiqdi. 28 ta tez ketadigan kvartirani esa o'tkazib yubordi — bu FN.
Qaysi raqam muhim? Bu — biznes qarori, matematik emas:
| Agar sizning muammoyingiz | Muhim metrika | Nega |
|---|---|---|
| Reklamaga pul sarflaysiz | Precision | Bo'sh e'longa pul ketmasin |
| Birorta imkoniyatni qo'ldan chiqarmaslik | Recall | Tez ketadigan kvartirani o'tkazib yubormaylik |
| Ikkisi ham muhim | F1 | Muvozanat |
| Sinflar juda nomutanosib | PR-AUC yoki macro F1 | Accuracy aldaydi (8-bob) |
7-bob va 8-bob to'liq shu mavzuga bag'ishlangan.
11-qadam. Xato qatorlarni O'QIYMAN
Mana bu qadam — talabalarni eng ko'p to'xtatadigan joy. Raqam chiqdi, keyin nima?
Javob: model xato qilgan qatorlarni ochib o'qiysiz. Qo'lda. Ko'zingiz bilan.
ehtimol = quvur.predict_proba(X_te)[:, 1]
tahlil = X_te.assign(haqiqat=y_te, bashorat=bashorat, ishonch=ehtimol.round(3))

xato = tahlil[tahlil.haqiqat != tahlil.bashorat]
print(f"Xato qilgan qatorlar: {len(xato)} ta ({len(xato)/len(X_te):.1%})")
print()
print("Model ENG ISHONCH bilan xato qilgan 5 qator:")
eng = xato.assign(xatolik=(xato.ishonch - xato.haqiqat).abs()).nlargest(5, "xatolik")
show(eng[["tuman", "xonalar", "maydon_m2", "metro_km", "mebel", "haqiqat", "bashorat", "ishonch"]])
Xato qilgan qatorlar: 80 ta (22.2%)

Model ENG ISHONCH bilan xato qilgan 5 qator:
| tuman | xonalar | maydon_m2 | metro_km | mebel | haqiqat | bashorat | ishonch |
|---|---|---|---|---|---|---|---|
| Shayxontohur | 1 | 29 | 2.78 | 0 | 0 | 1 | 0.855 |
| Sergeli | 2 | 34.7 | 4.45 | 1 | 0 | 1 | 0.85 |
| Chilonzor | 4 | 84.5 | 1.59 | 1 | 1 | 0 | 0.186 |
| Bektemir | 1 | 25.8 | 1.89 | 0 | 0 | 1 | 0.808 |
| Yakkasaroy | 4 | 75 | 1.62 | 1 | 1 | 0 | 0.205 |
Bu jadvalga qarab o'zingizdan so'rang:
- Xatolar bitta tumanda to'planganmi? Demak tuman haqida yetarli ma'lumot yo'q.
- Katta kvartiralardami? Demak modelda ularning namunasi kam.
- Mebelsizlardami? Demak
mebelustuni yetarli emas.
Keling, xatolar qayerda to'planganini sanaymiz:
jami = tahlil.groupby("tuman").size()
xatolar = xato.groupby("tuman").size()
natija = pd.DataFrame({"jami": jami, "xato": xatolar}).fillna(0)
natija["xato_ulushi"] = (natija.xato / natija.jami).round(3)
show(natija.sort_values("xato_ulushi", ascending=False).reset_index())
| tuman | jami | xato | xato_ulushi |
|---|---|---|---|
| Shayxontohur | 38 | 12 | 0.316 |
| Mirzo Ulug'bek | 49 | 13 | 0.265 |
| Olmazor | 46 | 11 | 0.239 |
| Yakkasaroy | 27 | 6 | 0.222 |
| Yunusobod | 59 | 13 | 0.22 |
| Bektemir | 27 | 5 | 0.185 |
| Chilonzor | 67 | 12 | 0.179 |
| Sergeli | 47 | 8 | 0.17 |
"Keyin nima qilaman?" savolining javobi shu yerda
Ko'p talaba 10-qadamda to'xtaydi: raqam bor, lekin keyingi harakat yo'q. Shuning uchun ular tasodifiy narsa qiladi — boshqa modelni sinaydi, hyperparameter larni aylantiradi, Google qiladi.
To'g'ri harakat: xato qatorlarni o'qish. Model nimani tushunmayotganini ma'lumotning o'zi aytadi. 10-bob to'liq shu haqda.
12-qadam. Qaror qabul qilaman
Endi sizda ma'lumot bor. Beshta yo'ldan bittasini tanlaysiz:
show(pd.DataFrame([
    {"Yo'l": "Yangi xususiyat qo'shish", "Qachon": "Xatolar bitta guruhda to'plangan",
     "Misol": "narx/maydon nisbati, metroga yaqinlik darajasi"},
    {"Yo'l": "Boshqa model", "Qachon": "Bog'lanish chiziqli emasga o'xshaydi",
     "Misol": "Decision tree, Random Forest (17-18-bob)"},
    {"Yo'l": "Ko'proq ma'lumot", "Qachon": "Train va test natijasi ikkisi ham past",
     "Misol": "Yana e'lonlar yig'ish (36-bob)"},
    {"Yo'l": "Hyperparameter tuning", "Qachon": "Model yaxshi, lekin sozlanmagan",
     "Misol": "GridSearchCV (23-bob)"},
    {"Yo'l": "Tugatish", "Qachon": "Baza dan yetarlicha yuqori, biznesga yetarli",
     "Misol": "Saqlash va xizmatga chiqarish (39-40-bob)"},
]))
| Yo'l | Qachon | Misol |
|---|---|---|
| Yangi xususiyat qo'shish | Xatolar bitta guruhda to'plangan | narx/maydon nisbati, metroga yaqinlik darajasi |
| Boshqa model | Bog'lanish chiziqli emasga o'xshaydi | Decision tree, Random Forest (17-18-bob) |
| Ko'proq ma'lumot | Train va test natijasi ikkisi ham past | Yana e'lonlar yig'ish (36-bob) |
| Hyperparameter tuning | Model yaxshi, lekin sozlanmagan | GridSearchCV (23-bob) |
| Tugatish | Baza dan yetarlicha yuqori, biznesga yetarli | Saqlash va xizmatga chiqarish (39-40-bob) |
Bir vaqtda faqat bittasini o'zgartiring. Agar ikkitasini birga o'zgartirsangiz va natija yaxshilansa — qaysi biri yordam berganini bilmaysiz.
O'zgartirdingiz — 9-qadamga qaytasiz. Shunday aylanib yurasiz.
Keling, bitta aylanishni ko'rsataman. Yangi xususiyat qo'shamiz: bitta xonaga qancha maydon to'g'ri keladi.
def xususiyat_qosh(d):
    d = d.copy()
    d["maydon_har_xona"] = d.maydon_m2 / d.xonalar
    d["yuqori_qavat"] = (d.qavat > d.qavatlar_soni * 0.7).astype(int)
    return d

son2 = son + ["maydon_har_xona", "yuqori_qavat"]
tayyorla2 = ColumnTransformer([
    ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                      ("shkala", StandardScaler())]), son2),
    ("matn", OneHotEncoder(handle_unknown="ignore"), matn),
])
quvur2 = Pipeline([("tayyorla", tayyorla2), ("model", LogisticRegression(max_iter=2000))])
quvur2.fit(xususiyat_qosh(X_tr), y_tr)

yangi = accuracy_score(y_te, quvur2.predict(xususiyat_qosh(X_te)))
print(f"BAZA              : {baza:.4f}")
print(f"1-urinish         : {aniqlik:.4f}")
print(f"2-urinish (+2 xus.): {yangi:.4f}")
print(f"O'zgarish         : {yangi - aniqlik:+.4f}")
BAZA              : 0.5056
1-urinish         : 0.7778
2-urinish (+2 xus.): 0.7833
O'zgarish         : +0.0056
Natijaga qarang. O'zgarish juda kichik: +0.0056 — ya'ni 360 qatordan ikkitasi.
Bu muvaffaqiyatsizlik emas, ma'lumot. Bu bizga aytadi: maydon_har_xona yangi narsa qo'shmadi, chunki u maydon_m2 va xonalar dan hisoblanadi — model allaqachon ikkisini ham ko'rgan.
Men bu bobni yozganda shu yerda adashdim
Men maydon_har_xona sezilarli yaxshilanish beradi deb o'yladim. O'lchadim — +0.0056, ya'ni 360 qatordan ikkitasi. Deyarli nol.
Buni kitobdan olib tashlamadim, chunki bu eng foydali dars: xususiyat muhandisligi ko'pincha ishlamaydi. Mavjud ustunlardan hisoblangan yangi ustun modelga yangi ma'lumot bermaydi. Haqiqiy yaxshilanish yangi manba dan keladi — masalan, e'lon qancha vaqt saytda turgani, yoki rasmlar soni.
Agar kitobda hamma urinish muvaffaqiyatli chiqsa — bu kitob o'lchanmagan bo'ladi.
Butun yo'l bitta rasmda
diagramma(
    {
        "1. Fayl\nshape, dtypes, head":        (0, 0, 3, 1.1, "manba"),
        "2. Target ni nomlash\nbitta jumla":    (3.4, 0, 3, 1.1, "manba"),
        "3-4. Tur va sanoq\nvazifa + nomutanosiblik": (6.8, 0, 3.4, 1.1, "manba"),
        "5. SPLIT\ntest qulflanadi":            (0, 1.6, 3, 1.1, "saqlash"),
        "6. Dummy\nchegara raqami":             (3.4, 1.6, 3, 1.1, "saqlash"),
        "7-8. Zahar va missing\nustunlar qarori": (6.8, 1.6, 3.4, 1.1, "saqlash"),
        "9. Pipeline + model":                  (0, 3.2, 3, 1.1, "qayta"),
        "10. Metrika":                          (3.4, 3.2, 3, 1.1, "qayta"),
        "11. Xatolarni o'qish":                 (6.8, 3.2, 3.4, 1.1, "qayta"),
        "12. BITTA o'zgarish":                  (3.4, 4.8, 3, 1.1, "xizmat"),
    },
    [
        ("1. Fayl\nshape, dtypes, head", "2. Target ni nomlash\nbitta jumla"),
        ("2. Target ni nomlash\nbitta jumla", "3-4. Tur va sanoq\nvazifa + nomutanosiblik"),
        ("3-4. Tur va sanoq\nvazifa + nomutanosiblik", "5. SPLIT\ntest qulflanadi"),
        ("5. SPLIT\ntest qulflanadi", "6. Dummy\nchegara raqami"),
        ("6. Dummy\nchegara raqami", "7-8. Zahar va missing\nustunlar qarori"),
        ("7-8. Zahar va missing\nustunlar qarori", "9. Pipeline + model"),
        ("9. Pipeline + model", "10. Metrika"),
        ("10. Metrika", "11. Xatolarni o'qish"),
        ("11. Xatolarni o'qish", "12. BITTA o'zgarish"),
        ("12. BITTA o'zgarish", "9. Pipeline + model"),
    ],
    nom="protokol.png",
    izoh="12 qadam. Oxirgi strelka 9-qadamga qaytadi — bu aylanma, to'g'ri chiziq emas.",
)
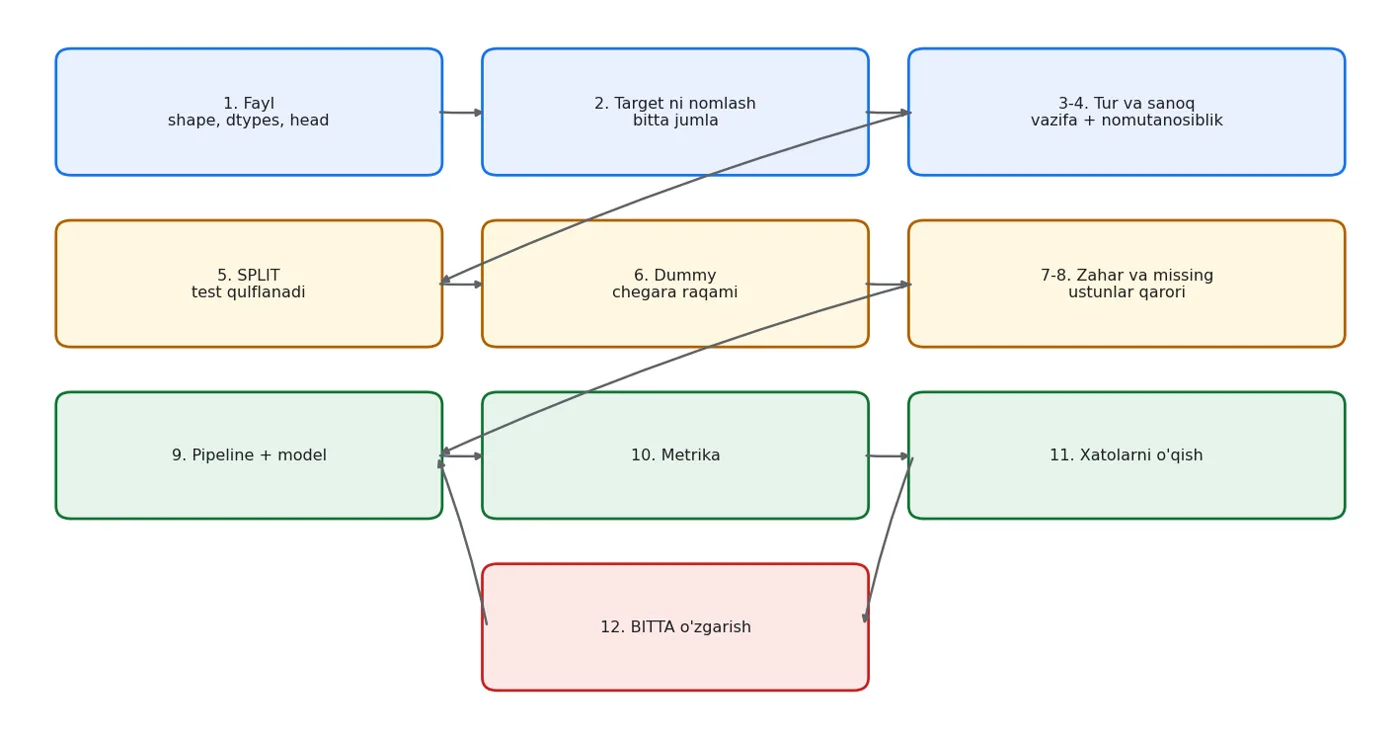
12 qadam. Oxirgi strelka 9-qadamga qaytadi — bu aylanma, to'g'ri chiziq emas.
E'tibor bering: oxirgi strelka orqaga qaytadi. ML — aylanma ish, bir marta bajariladigan ro'yxat emas. Siz 9→12 ni o'nlab marta aylanasiz.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Qadam": "1-4", "Bitta jumla bilan": "Ma'lumotni tushunish — modelga tegmasdan"},
    {"Qadam": "5", "Bitta jumla bilan": "Test to'plamini qulflash (leakage shu yerda to'xtaydi)"},
    {"Qadam": "6", "Bitta jumla bilan": "Chegara raqamini olish — busiz hukm chiqarib bo'lmaydi"},
    {"Qadam": "7-8", "Bitta jumla bilan": "Zaharli ustunlarni tashlash, missing ni hal qilish"},
    {"Qadam": "9", "Bitta jumla bilan": "Pipeline da BITTA oddiy model"},
    {"Qadam": "10", "Bitta jumla bilan": "Vazifaga mos metrikani tanlash"},
    {"Qadam": "11", "Bitta jumla bilan": "Xato qatorlarni o'qish — keyingi qadam shundan chiqadi"},
    {"Qadam": "12", "Bitta jumla bilan": "BITTA o'zgarish va 9-qadamga qaytish"},
]))
| Qadam | Bitta jumla bilan |
|---|---|
| 1-4 | Ma'lumotni tushunish — modelga tegmasdan |
| 5 | Test to'plamini qulflash (leakage shu yerda to'xtaydi) |
| 6 | Chegara raqamini olish — busiz hukm chiqarib bo'lmaydi |
| 7-8 | Zaharli ustunlarni tashlash, missing ni hal qilish |
| 9 | Pipeline da BITTA oddiy model |
| 10 | Vazifaga mos metrikani tanlash |
| 11 | Xato qatorlarni o'qish — keyingi qadam shundan chiqadi |
| 12 | BITTA o'zgarish va 9-qadamga qaytish |
Bizning natijalarimiz:
show(pd.DataFrame([
    {"Model": "Dummy (baza)", "Accuracy": f"{baza:.4f}", "Izoh": "Hech narsa o'rganmagan"},
    {"Model": "Logistic + Pipeline", "Accuracy": f"{aniqlik:.4f}", "Izoh": "Bazadan +0.27"},
    {"Model": "+ 2 yangi xususiyat", "Accuracy": f"{yangi:.4f}", "Izoh": "Deyarli o'zgarish yo'q — halol natija"},
    {"Model": "+ agent_komissiyasi", "Accuracy": f"{a_zahar:.4f}", "Izoh": "LEAKAGE — yolg'on natija"},
]))
| Model | Accuracy | Izoh |
|---|---|---|
| Dummy (baza) | 0.5056 | Hech narsa o'rganmagan |
| Logistic + Pipeline | 0.7778 | Bazadan +0.27 |
| + 2 yangi xususiyat | 0.7833 | Deyarli o'zgarish yo'q — halol natija |
| + agent_komissiyasi | 1.0000 | LEAKAGE — yolg'on natija |
Stolingizga qo'yadigan karta
karta = """
+--------------------------------------------------------------+
|  YANGI DATASET — 12 QADAM                                    |
+--------------------------------------------------------------+
|   1  shape, dtypes, head()                                   |
|   2  "Men ___ ni ___ dan bashorat qilaman"                   |
|   3  target turi -> regression / classification              |
|   4  value_counts(normalize=True)  <- BAZANGIZ               |
|   5  train_test_split(..., stratify=y)   HOZIR!              |
|   6  DummyClassifier -> chegara raqamini yozib qo'ying       |
|   7  nunique() -> ID lar;  "bu menda bo'ladimi?" -> leakage  |
|   8  isna().sum();  object ustunlar -> OneHot                |
|   9  ColumnTransformer -> Pipeline -> fit                    |
|  10  confusion_matrix, precision, recall, F1                 |
|  11  xato qatorlarni O'QING (nlargest ishonch bo'yicha)      |
|  12  BITTA o'zgarish -> 9-qadamga qayt                       |
+--------------------------------------------------------------+
|  Mukammal natija (>0.99) = leakage signali, bayram emas      |
|  Bazani bilmasang, accuracy ma'nosiz                         |
|  Test to'plami seyfda — bir marta ochiladi                   |
+--------------------------------------------------------------+
"""
print(karta)
+--------------------------------------------------------------+
|  YANGI DATASET — 12 QADAM                                    |
+--------------------------------------------------------------+
|   1  shape, dtypes, head()                                   |
|   2  "Men ___ ni ___ dan bashorat qilaman"                   |
|   3  target turi -> regression / classification              |
|   4  value_counts(normalize=True)  <- BAZANGIZ               |
|   5  train_test_split(..., stratify=y)   HOZIR!              |
|   6  DummyClassifier -> chegara raqamini yozib qo'ying       |
|   7  nunique() -> ID lar;  "bu menda bo'ladimi?" -> leakage  |
|   8  isna().sum();  object ustunlar -> OneHot                |
|   9  ColumnTransformer -> Pipeline -> fit                    |
|  10  confusion_matrix, precision, recall, F1                 |
|  11  xato qatorlarni O'QING (nlargest ishonch bo'yicha)      |
|  12  BITTA o'zgarish -> 9-qadamga qayt                       |
+--------------------------------------------------------------+
|  Mukammal natija (>0.99) = leakage signali, bayram emas      |
|  Bazani bilmasang, accuracy ma'nosiz                         |
|  Test to'plami seyfda — bir marta ochiladi                   |
+--------------------------------------------------------------+
Keyingi bob
Siz hozir butun yo'lni bir marta yurib chiqdingiz. Hamma narsani tushunmagan bo'lsangiz — normal. Kitobning qolgan qismi shu o'n ikki qadamning har birini chuqurlashtiradi:
| Qadam | Qaysi bob |
|---|---|
| 1–4 (ma'lumotni ko'rish) | 2-bob SQL, 3-bob vizualizatsiya |
| 5 (split, leakage) | 5-bob |
| 6 (baza) | 6-bob |
| 7–8 (tozalash) | 4-bob |
| 9 (modellar) | 14–21-bob |
| 10 (metrikalar) | 7, 8, 9-bob |
| 11 (xato tahlili) | 10-bob |
| 12 (qaror) | 22–25-bob |
Va 41-bobda men haqiqiy Kaggle datasetini birinchi marta ochib, hamma xatolarim bilan birga yurib chiqaman.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.