Apparat: bitta kompyuter nechta kamerani ko'taradi
Bu bobning kodi: kod/18_apparat.py — kitob papkasidan ishga tushiring: python kod/18_apparat.py
Savol: qancha kompyuter kerak
Mijoz 40 ta kamera bilan keladi. Bitta kompyuter yetadimi, ikkitami? Qanday GPU? Bu savolga "YOLO 1.5 ms da ishlaydi" degan javob yetmaydi: har bir kadr avval dekodlanadi (siqilgan videodan rasmga), keyin modelga tayyorlanadi, model ishlaydi, natija tozalanadi va tracker ga beriladi. Qaysi bosqich birinchi bo'lib to'lsa, tizim o'sha yerda to'xtaydi. Bu bobda har bir bosqichni alohida o'lchaymiz, keyin hammasini birga — N ta kamerada.
Hamma o'lchovlar bitta kompyuterda: NVIDIA RTX 5070 Ti (16 GB), WSL da 8 ta protsessor ipi. Kompyuterda boshqa dasturlar ham ishlab turgan — real serverdagi kabi.
Test videolari
Kamera ikki oqim beradi: asosiy (masalan, 1080p, 4 Mbit/s — yozib olish uchun) va ikkinchi (sub-stream, masalan, 640x360, 0.5 Mbit/s — ko'rish uchun). MOT17-09 dan shunday videolar tayyorlaymiz: 30 fps (dekodlash tezligi uchun) va 15 fps (real vaqt sinovi uchun).
import json
import re
import subprocess
import sys
import time
from pathlib import Path

import cv2
import numpy as np
import pandas as pd
import torch
import torchvision
import matplotlib.pyplot as plt
from scipy.optimize import linear_sum_assignment
from ultralytics import YOLO
from ultralytics.utils import LOGGER

LOGGER.setLevel("ERROR")
MANBA = "datasets/MOT17/train/MOT17-09-FRCNN/img1/%06d.jpg"
OUT = Path("out/apparat")
OUT.mkdir(parents=True, exist_ok=True)
KLIPLAR = {"1080p_h264_30fps": ("1920:1080", 30, ["-c:v", "libx264", "-b:v", "4000k", "-maxrate", "4000k", "-bufsize", "8000k"]),
           "1080p_h265_30fps": ("1920:1080", 30, ["-c:v", "libx265", "-b:v", "2000k", "-maxrate", "2000k", "-bufsize", "4000k",
                                                  "-x265-params", "log-level=error"]),
           "360p_h264_30fps": ("640:360", 30, ["-c:v", "libx264", "-b:v", "512k", "-maxrate", "512k", "-bufsize", "1024k"]),
           "1080p_h264_15fps": ("1920:1080", 15, ["-c:v", "libx264", "-b:v", "4000k", "-maxrate", "4000k", "-bufsize", "8000k"]),
           "360p_h264_15fps": ("640:360", 15, ["-c:v", "libx264", "-b:v", "512k", "-maxrate", "512k", "-bufsize", "1024k"])}
klip = {}
for nom, (olcham, fps, kod) in KLIPLAR.items():
    klip[nom] = OUT / f"MOT17-09_{nom}.mp4"
    if not klip[nom].exists():
        filtr = f"select=not(mod(n\\,2)),setpts=N/15/TB,scale={olcham}" if fps == 15 else f"scale={olcham}"
        subprocess.run(["ffmpeg", "-y", "-loglevel", "error", "-framerate", "30", "-i", MANBA, "-vf", filtr, "-r", str(fps), *kod,
                        "-g", str(2 * fps), "-pix_fmt", "yuv420p", str(klip[nom])], check=True)
show(pd.DataFrame([{"klip": n, "fayl, KB": f.stat().st_size // 1024} for n, f in klip.items()]))
| klip | fayl, KB |
|---|---|
| 1080p_h264_30fps | 8 552 |
| 1080p_h265_30fps | 4 244 |
| 360p_h264_30fps | 1 078 |
| 1080p_h264_15fps | 8 498 |
| 360p_h264_15fps | 1 083 |
1-bosqich: dekodlash
ffmpeg videoni uch usulda dekodlaydi: protsessorda bitta ip bilan, protsessorning hamma iplari bilan va GPU dagi alohida video blokda — NVDEC (NVIDIA ning apparat dekoderi, h264_cuvid, hevc_cuvid). -f null natijani hech qayerga yozmaydi — sof dekodlash tezligi. -benchmark qancha protsessor vaqti ketganini ham aytadi: "CPU yadro" — shu vaqt ichida o'rtacha nechta yadro band bo'lgani.
def ffmpeg_dekod(fayl, dekoder=None, iplar=None, takror=4):
    buyruq = ["ffmpeg", "-hide_banner", "-benchmark", *(["-threads", str(iplar)] if iplar else []), *(["-c:v", dekoder] if dekoder else []),
              "-stream_loop", str(takror - 1), "-i", str(fayl), "-f", "null", "-"]
    r = subprocess.run(buyruq, capture_output=True, text=True, check=True)
    kadr = int(re.findall(r"frame=\s*(\d+)", r.stderr)[-1])
    cpu_vaqt, soat = map(float, re.search(r"utime=([\d.]+)s.*rtime=([\d.]+)s", r.stderr).groups())
    return kadr / soat, cpu_vaqt / soat

qatorlar = []
for nom in ("1080p_h264_30fps", "1080p_h265_30fps", "360p_h264_30fps"):
    kodek = "hevc" if "h265" in nom else "h264"
    for usul, dekoder, iplar in (("CPU, 1 ip", None, 1), ("CPU, hamma ip", None, None), ("GPU, NVDEC", f"{kodek}_cuvid", None)):
        kadr_s, yadro = ffmpeg_dekod(klip[nom], dekoder, iplar)
        qatorlar.append({"video": nom, "usul": usul, "kadr/s": kadr_s, "CPU yadro": yadro, "1 yadroga kadr/s": kadr_s / yadro})
show(pd.DataFrame(qatorlar).round(2))
| video | usul | kadr/s | CPU yadro | 1 yadroga kadr/s |
|---|---|---|---|---|
| 1080p_h264_30fps | CPU, 1 ip | 342.47 | 0.94 | 363.76 |
| 1080p_h264_30fps | CPU, hamma ip | 1 460.36 | 4.61 | 316.46 |
| 1080p_h264_30fps | GPU, NVDEC | 843.03 | 0.32 | 2 654.87 |
| 1080p_h265_30fps | CPU, 1 ip | 295.48 | 0.96 | 309.14 |
| 1080p_h265_30fps | CPU, hamma ip | 1 070.34 | 3.66 | 292.68 |
| 1080p_h265_30fps | GPU, NVDEC | 975.38 | 0.34 | 2 841.68 |
| 360p_h264_30fps | CPU, 1 ip | 2 755.91 | 0.86 | 3 215.93 |
| 360p_h264_30fps | CPU, hamma ip | 8 203.12 | 3.08 | 2 664.97 |
| 360p_h264_30fps | GPU, NVDEC | 1 433.45 | 0.22 | 6 402.44 |
Bitta protsessor yadrosi 1080p H.264 ni sekundiga bir necha yuz kadr dekodlaydi — 15 fps li kameradan yigirmatacha. NVDEC tezligi bitta oqimda protsessorning hamma iplaridan past, lekin u deyarli protsessor vaqti olmaydi — boshqa ishlarga yadrolar bo'shaydi. 360p ikkinchi oqimni dekodlash 1080p dan 8 barobarga yaqin arzon.
Lekin dekodlangan kadr hali Python ga yetib kelmadi. Uni uch xil yo'l bilan olamiz: OpenCV (cv2.VideoCapture, protsessorda), NVDEC dan to'liq 1080p kadr (quvur orqali), va NVDEC ning o'zida 640x360 ga kichraytirilgan kadr.
def pythonga(fayl, usul, takror=4):
    t0, n = time.perf_counter(), 0
    if usul == "OpenCV (CPU)":
        for _ in range(takror):
            cap = cv2.VideoCapture(str(fayl))
            while cap.read()[0]:
                n += 1
        return n / (time.perf_counter() - t0)
    w, h, qoshimcha = (1920, 1080, []) if usul == "NVDEC, 1080p" else (640, 360, ["-resize", "640x360"])
    p = subprocess.Popen(["ffmpeg", "-loglevel", "error", "-c:v", "h264_cuvid", *qoshimcha, "-stream_loop", str(takror - 1), "-i", str(fayl),
                          "-f", "rawvideo", "-pix_fmt", "bgr24", "-"], stdout=subprocess.PIPE, bufsize=w * h * 3 * 4)
    while len(p.stdout.read(w * h * 3)) == w * h * 3:                      # har kadr: w*h*3 bayt BGR
        n += 1
    p.wait()
    return n / (time.perf_counter() - t0)

show(pd.DataFrame([{"Python ga kadr olish": u, "kadr/s": pythonga(klip["1080p_h264_30fps"], u)}
                   for u in ("OpenCV (CPU)", "NVDEC, 1080p", "NVDEC, 640x360 ga kichraytirib")]).round(0))
| Python ga kadr olish | kadr/s |
|---|---|
| OpenCV (CPU) | 939 |
| NVDEC, 1080p | 157 |
| NVDEC, 640x360 ga kichraytirib | 521 |
Kutilmagan natija: NVDEC dan to'liq 1080p kadrni Python ga olish OpenCV dan ancha sekin. Sabab — quvur: har bir 1080p kadr 6 MB, uni GPU dan protsessor xotirasiga ko'chirish va rang formatini (NV12 → BGR) protsessorda o'zgartirish dekodlashning o'zidan qimmat. Kadrni NVDEC ning o'zida 640x360 ga kichraytirsak (model baribir 640 da ishlaydi — 17-bob), ko'chiriladigan ma'lumot 9 marta kamayadi va tezlik bir necha barobar oshadi.
2-bosqich: model
YOLO11n ni turli rejimlarda o'lchaymiz, har safar 1080p kadrlar bilan va ultralytics ning to'liq predict i bilan (tayyorlash, model, natijani tozalash — hammasi). 8-bobda TensorRT eksportini ko'rgan edik; endi uni kamera kadrining shakliga (16:9 → 384x640) va bir nechta kadrni birdan (batch, 16 tagacha) qabul qiladigan qilib eksport qilamiz.
dvigatel = Path("weights/yolo11n_384x640_b16.engine")
if not dvigatel.exists():
    Path(YOLO("weights/yolo11n.pt").export(format="engine", imgsz=(384, 640), half=True, dynamic=True, batch=16, device=0)).rename(dvigatel)
    Path("weights/yolo11n.onnx").unlink(missing_ok=True)                  # eksportning oraliq fayli
kadrlar = [cv2.imread(str(p)) for p in sorted(Path("datasets/MOT17/train/MOT17-09-FRCNN/img1").iterdir())[:64]]

def ms_kadr(model, batch, **kw):
    for _ in range(3):
        model.predict(kadrlar[:batch], verbose=False, **kw)              # qizdirish
    n, t0 = 0, time.perf_counter()
    while time.perf_counter() - t0 < 4:
        for i in range(0, 64, batch):
            model.predict(kadrlar[i:i + batch], verbose=False, **kw)
            n += batch
    return (time.perf_counter() - t0) / n * 1000

pt, trt = YOLO("weights/yolo11n.pt"), YOLO(str(dvigatel), task="detect")
pt_cpu = YOLO("weights/yolo11n.pt")                                       # alohida nusxa: model birinchi chaqiruvdagi qurilmada qoladi
sinovlar = [("PyTorch FP16, GPU", pt, 640, b, dict(half=True, device=0)) for b in (1, 8)] + \
           [("PyTorch FP16, GPU", pt, 1280, b, dict(half=True, device=0)) for b in (1, 8)] + \
           [("TensorRT FP16, GPU", trt, (384, 640), b, dict(device=0)) for b in (1, 8, 16)] + \
           [("PyTorch, faqat CPU", pt_cpu, 640, 1, dict(device="cpu"))]
qatorlar = []
for nom, model, imgsz, batch, kw in sinovlar:
    ms = ms_kadr(model, batch, imgsz=imgsz, classes=[0], **kw)
    qatorlar.append({"rejim": nom, "imgsz": str(imgsz), "batch": batch, "ms/kadr": ms, "kadr/s": 1000 / ms})
model_jadval = pd.DataFrame(qatorlar)
show(model_jadval.round(2))
| rejim | imgsz | batch | ms/kadr | kadr/s |
|---|---|---|---|---|
| PyTorch FP16, GPU | 640 | 1 | 6.01 | 166.41 |
| PyTorch FP16, GPU | 640 | 8 | 1.99 | 503.2 |
| PyTorch FP16, GPU | 1280 | 1 | 7.53 | 132.77 |
| PyTorch FP16, GPU | 1280 | 8 | 4.93 | 202.9 |
| TensorRT FP16, GPU | (384, 640) | 1 | 3.08 | 324.61 |
| TensorRT FP16, GPU | (384, 640) | 8 | 1.46 | 684.11 |
| TensorRT FP16, GPU | (384, 640) | 16 | 1.38 | 723.28 |
| PyTorch, faqat CPU | 640 | 1 | 15.74 | 63.53 |
- Batch eng katta yutuq: GPU bitta kadrda deyarli bo'sh turadi, 8–16 kadrni birdan olsa, har kadr bir necha barobar arzonlashadi. Ko'p kamerali tizimda batch tabiiy: har bir aylanishda hamma kameralarning oxirgi kadrlari birga yuboriladi.
- TensorRT PyTorch dan tez, ayniqsa batch 1 da.
- imgsz 1280 batch bilan 640 dan taxminan 2.5 barobar qimmat (17-bobda "to'rt barobar piksel" degan edik — piksel to'rt barobar, vaqt esa kamroq oshadi, chunki kichik modelda vaqtning bir qismi tayyorlash va natijani tozalashga ketadi).
- Faqat CPU: bir kadrga ~16 millisekund — 8 ipda bir necha kamera. GPU siz tizim mumkin, lekin kichik (pastda o'lchaymiz).
Ikkinchi oqim yetadimi
imgsz=640 da model 1080p kadrni baribir 640x360 ga kichraytiradi. Unda kameraning 360p ikkinchi oqimini to'g'ridan-to'g'ri olsak-chi — dekodlash 1080p dan ancha arzon? Farq faqat siqish sifatida: ikkinchi oqim 0.5 Mbit/s bilan keladi. 17-bobdagi usul bilan tekshiramiz.
gt = np.loadtxt("datasets/MOT17/train/MOT17-09-FRCNN/gt/gt.txt", delimiter=",")
gt = gt[gt[:, 7] == 1]
yaxshi = (gt[:, 8] >= 0.8) & (gt[:, 2] >= 0) & (gt[:, 3] >= 0) & (gt[:, 2] + gt[:, 4] <= 1920) & (gt[:, 3] + gt[:, 5] <= 1080)

def recall(fayl):
    cap, k, tp, jami = cv2.VideoCapture(str(fayl)), 0, 0, 0
    while True:
        ok, rasm = cap.read()
        if not ok:
            return 100 * tp / jami
        k += 1
        s = 1920 / rasm.shape[1]                                          # 360p box larini 1080p koordinataga qaytaramiz
        D = pt.predict(rasm, imgsz=640, conf=0.25, classes=[0], device=0, verbose=False)[0].boxes.xyxy.cpu().numpy() * s
        m = gt[:, 0] == k
        G = np.c_[gt[m, 2:4], gt[m, 2:4] + gt[m, 4:6]]
        t = np.zeros(len(G), bool)
        if len(G) and len(D):
            M = torchvision.ops.box_iou(torch.tensor(G), torch.tensor(D, dtype=torch.float64)).numpy()
            r, c = linear_sum_assignment(-M)
            t[r[M[r, c] >= 0.5]] = True
        tp, jami = tp + t[yaxshi[m]].sum(), jami + yaxshi[m].sum()

show(pd.DataFrame([{"oqim (imgsz 640)": n, "recall, %": recall(klip[n])} for n in ("1080p_h264_30fps", "360p_h264_30fps")]).round(1))
| oqim (imgsz 640) | recall, % |
|---|---|
| 1080p_h264_30fps | 96.2 |
| 360p_h264_30fps | 93.4 |
imgsz=640 bilan ikkinchi oqim biroz past natija beradi (96.2% o'rniga 93.4%) — past bitreyt ning narxi. Evaziga dekodlash 8 barobarga yaqin arzon. Ko'p kamerali tizimda bu yaxshi murosa; aniqlik muhim hududlar uchun asosiy oqimni qoldiring. Asosiy oqim baribir yozib olish va yaqinlashtirilgan qirqimlar (yuz, kaska — 17-bob) uchun kerak.
Hammasi birga: N ta kamera
Endi haqiqiy sinov. Har bir soxta kamera — alohida ip, u videoni real vaqtda, sekundiga 15 kadr bilan beradi va faqat oxirgi kadrni saqlaydi. Asosiy sikl hamma kameralardan yangi kadrlarni yig'adi, 16 talik batch larda TensorRT ga beradi va har bir kameraning o'z ByteTrack iga uzatadi. Tizim ulgurmasa, kamera kadrni yangisi bilan almashtiradi — bu "tashlangan kadr". Bu kod keyingi bobdagi real oqimning soddalashtirilgan ko'rinishi; uni alohida faylga yozamiz, chunki bir nechta nusxasini parallel ishga tushiramiz.
# Bitta ishchi jarayon: N ta soxta kamera (real vaqtda 15 kadr/s), YOLO11n va har kameraga ByteTrack.
# Natija — bitta JSON qator. Misol: python kod/18_kamera_ishchisi.py --usul sub --kameralar 32
import argparse
import json
import os
import subprocess
import threading
import time

import numpy as np
import cv2
import psutil
from ultralytics import YOLO
from ultralytics.trackers import BYTETracker
from ultralytics.utils import LOGGER, YAML, IterableSimpleNamespace
from ultralytics.utils.checks import check_yaml

LOGGER.setLevel("ERROR")
FPS = 15
KLIP = {"cpu": "out/apparat/MOT17-09_1080p_h264_15fps.mp4",              # asosiy oqim, OpenCV dekodlaydi
        "gpu": "out/apparat/MOT17-09_1080p_h264_15fps.mp4",              # asosiy oqim, NVDEC dekodlaydi va 640x360 ga kichraytiradi
        "sub": "out/apparat/MOT17-09_360p_h264_15fps.mp4"}               # ikkinchi oqim, OpenCV dekodlaydi


class Kamera(threading.Thread):
    """Real vaqtda kadr beradigan soxta kamera. Faqat oxirgi kadr saqlanadi: olinmay almashtirilgani — tashlangan kadr."""
    def __init__(self, usul):
        super().__init__(daemon=True)
        self.usul, self.kadr, self.berildi, self.olindi, self.ish = usul, None, 0, 0, True
        self.qulf = threading.Lock()

    def run(self):
        if self.usul == "gpu":
            p = subprocess.Popen(["ffmpeg", "-loglevel", "error", "-re", "-c:v", "h264_cuvid", "-resize", "640x360", "-stream_loop", "-1",
                                  "-i", KLIP["gpu"], "-f", "rawvideo", "-pix_fmt", "bgr24", "-"], stdout=subprocess.PIPE)
            while self.ish:                                              # -re: ffmpeg o'zi real vaqtda beradi
                b = p.stdout.read(640 * 360 * 3)
                if len(b) < 640 * 360 * 3:
                    break
                self.qoy(np.frombuffer(b, np.uint8).reshape(360, 640, 3))
            p.kill()
            return
        cap, keyingi = cv2.VideoCapture(KLIP[self.usul]), time.perf_counter()
        while self.ish:
            ok, rasm = cap.read()
            if not ok:                                                   # video tugadi — boshidan
                cap = cv2.VideoCapture(KLIP[self.usul])
                continue
            keyingi += 1 / FPS
            time.sleep(max(0.0, keyingi - time.perf_counter()))
            self.qoy(rasm)

    def qoy(self, rasm):
        with self.qulf:
            self.kadr, self.berildi = rasm, self.berildi + 1

    def ol(self):
        with self.qulf:
            rasm, self.kadr = self.kadr, None
        self.olindi += rasm is not None
        return rasm


def main():
    p = argparse.ArgumentParser()
    p.add_argument("--usul", choices=list(KLIP), default="sub")
    p.add_argument("--kameralar", type=int, default=16)
    p.add_argument("--soniya", type=float, default=20)
    p.add_argument("--model", default="weights/yolo11n_384x640_b16.engine")
    p.add_argument("--qurilma", default="0")
    a = p.parse_args()

    model = YOLO(a.model, task="detect")
    qurilma = "cpu" if a.qurilma == "cpu" else int(a.qurilma)
    for b in range(1, 17):                                               # har batch o'lchami uchun qizdiramiz
        model.predict([np.zeros((360, 640, 3), np.uint8)] * b, imgsz=(384, 640), device=qurilma, verbose=False)
    bt = IterableSimpleNamespace(**YAML.load(check_yaml("bytetrack.yaml")))
    kameralar = [Kamera(a.usul) for _ in range(a.kameralar)]
    trackerlar = [BYTETracker(bt, frame_rate=FPS) for _ in kameralar]
    for k in kameralar:
        k.start()
    time.sleep(2)
    for k in kameralar:
        k.berildi = k.olindi = 0
    smi = subprocess.Popen(["nvidia-smi", "--query-gpu=utilization.gpu,utilization.decoder,memory.used",
                            "--format=csv,noheader,nounits", "-lms", "500"], stdout=subprocess.PIPE, text=True)
    psutil.cpu_percent(None)
    t0 = time.perf_counter()
    while time.perf_counter() - t0 < a.soniya:
        tayyor = [(i, r) for i, k in enumerate(kameralar) if (r := k.ol()) is not None]
        if not tayyor:
            time.sleep(0.001)
            continue
        for j in range(0, len(tayyor), 16):                              # dvigatel 16 tagacha batch qabul qiladi
            qism = tayyor[j:j + 16]
            natija = model.predict([r for _, r in qism], imgsz=(384, 640), device=qurilma, verbose=False, classes=[0])
            for (i, rasm), r in zip(qism, natija):
                trackerlar[i].update(r.boxes.cpu().numpy(), rasm)
    vaqt = time.perf_counter() - t0
    cpu = psutil.cpu_percent(None)
    smi.terminate()
    gpu = np.array([[float(x) for x in q.split(",")] for q in smi.stdout.read().split("\n") if q.strip()])
    for k in kameralar:
        k.ish = False
    for k in kameralar:
        k.join(timeout=2)                                                # ffmpeg jarayonlari ham yopiladi
    berildi = sum(k.berildi for k in kameralar) / vaqt / len(kameralar)
    ishlandi = sum(k.olindi for k in kameralar) / vaqt / len(kameralar)
    print(json.dumps({"berildi": berildi, "ishlandi": ishlandi, "tashlandi": 100 * (1 - ishlandi / berildi), "cpu": cpu,
                      "gpu": gpu[:, 0].mean(), "nvdec": gpu[:, 1].mean(), "gpu_xotira": gpu[:, 2].max(),
                      "ram": psutil.Process(os.getpid()).memory_info().rss / 2**20}))


if __name__ == "__main__":
    main()
Uch xil kirish yo'lini 1 dan 64 tagacha kamera bilan sinaymiz. Har bir sinov 20 soniya.
def gpu_xotira():
    return float(subprocess.run(["nvidia-smi", "--query-gpu=memory.used", "--format=csv,noheader,nounits"],
                                capture_output=True, text=True).stdout)

def ishchilar(usul, kameralar, nusxa=1, **kw):
    """nusxa ta ishchi jarayonni parallel ishga tushiradi, har biri `kameralar` ta kamera bilan."""
    buyruq = [sys.executable, "kod/18_kamera_ishchisi.py", "--usul", usul, "--kameralar", str(kameralar),
              *[x for k, v in kw.items() for x in (f"--{k}", str(v))]]
    jarayonlar = [subprocess.Popen(buyruq, stdout=subprocess.PIPE, stderr=subprocess.DEVNULL, text=True) for _ in range(nusxa)]
    return [json.loads(p.communicate()[0].strip().splitlines()[-1]) for p in jarayonlar]

asos = gpu_xotira()
print(f"sinovdan oldin GPU xotirasi band: {asos:.0f} MB (16 GB dan)")
NOMI = {"cpu": "1080p, OpenCV (CPU)", "gpu": "1080p, NVDEC + kichraytirish", "sub": "360p ikkinchi oqim, OpenCV"}
qatorlar = []
for usul in NOMI:
    for n in (1, 16, 32, 48, 64):
        r = ishchilar(usul, n)[0]
        qatorlar.append({"kirish": NOMI[usul], "kameralar": n, "kameraga ishlangan kadr/s": r["ishlandi"], "tashlandi, %": r["tashlandi"],
                         "CPU, %": r["cpu"], "GPU, %": r["gpu"], "NVDEC, %": r["nvdec"], "GPU xotirasi, MB": r["gpu_xotira"]})
sigim = pd.DataFrame(qatorlar)
show(sigim.round(1))

_, ax = plt.subplots(figsize=(8, 4.5))
for usul, nom in NOMI.items():
    q = sigim[sigim["kirish"] == nom]
    ax.plot(q["kameralar"], q["kameraga ishlangan kadr/s"], marker="o", label=nom)
ax.axhline(15, color="gray", ls="--", lw=0.8)
ax.set_xlabel("kameralar soni (bitta jarayon)")
ax.set_ylabel("har kameraga ishlangan kadr/s")
ax.legend(fontsize=8)
fig("sigim.png", "Bitta Python jarayoni: kameralar ko'paygan sari har kameraga qancha kadr yetadi (kameralar sekundiga 15 kadr beradi).")
sinovdan oldin GPU xotirasi band: 1954 MB (16 GB dan)
| kirish | kameralar | kameraga ishlangan kadr/s | tashlandi, % | CPU, % | GPU, % | NVDEC, % | GPU xotirasi, MB |
|---|---|---|---|---|---|---|---|
| 1080p, OpenCV (CPU) | 1 | 15 | 0.7 | 2.8 | 4.9 | 0 | 3 381 |
| 1080p, OpenCV (CPU) | 16 | 15 | 0.6 | 32.9 | 17.2 | 0 | 3 598 |
| 1080p, OpenCV (CPU) | 32 | 11.9 | 21.3 | 51.3 | 11.8 | 0 | 3 330 |
| 1080p, OpenCV (CPU) | 48 | 5.8 | 62.1 | 68.4 | 8.8 | 0 | 3 345 |
| 1080p, OpenCV (CPU) | 64 | 1.3 | 91.2 | 82.8 | 9.4 | 0 | 3 538 |
| 1080p, NVDEC + kichraytirish | 1 | 15 | 0.7 | 2.4 | 3.9 | 2.2 | 3 693 |
| 1080p, NVDEC + kichraytirish | 16 | 15 | 0.9 | 16.8 | 18.3 | 9.4 | 8 826 |
| 1080p, NVDEC + kichraytirish | 32 | 14.7 | 2.6 | 25.5 | 19.6 | 21.2 | 14 494 |
| 1080p, NVDEC + kichraytirish | 48 | 4 | 74.7 | 39.7 | 63 | 47.8 | 15 839 |
| 1080p, NVDEC + kichraytirish | 64 | 2.3 | 85.3 | 52.1 | 63.9 | 64.8 | 15 800 |
| 360p ikkinchi oqim, OpenCV | 1 | 15 | 1 | 2 | 2.2 | 0 | 3 002 |
| 360p ikkinchi oqim, OpenCV | 16 | 15 | 1 | 12.4 | 20.2 | 0 | 2 809 |
| 360p ikkinchi oqim, OpenCV | 32 | 15 | 1 | 19.1 | 19 | 0 | 2 809 |
| 360p ikkinchi oqim, OpenCV | 48 | 11 | 27 | 20.5 | 15.2 | 0 | 2 985 |
| 360p ikkinchi oqim, OpenCV | 64 | 7.9 | 49 | 22.7 | 15 | 0 | 2 791 |
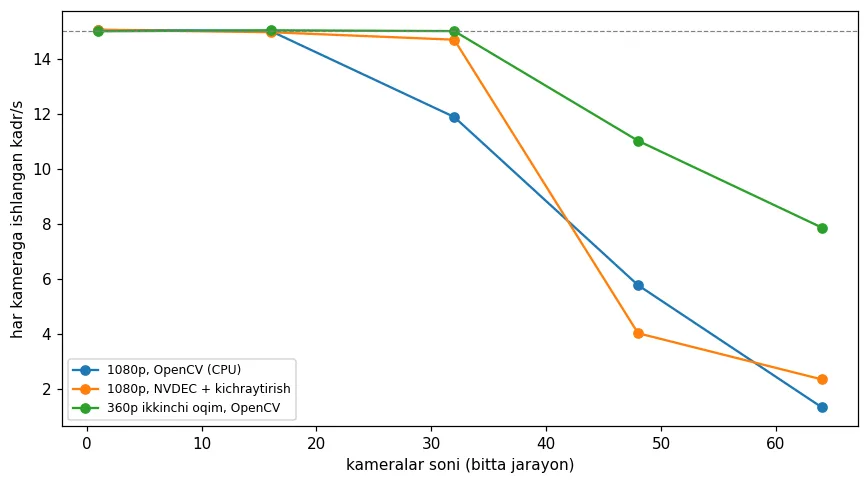
Bitta Python jarayoni: kameralar ko'paygan sari har kameraga qancha kadr yetadi (kameralar sekundiga 15 kadr beradi).
Bitta jarayon 1080p asosiy oqim bilan 16 kamerani, 360p ikkinchi oqim bilan 32 kamerani to'liq ko'taradi. Undan keyin kadrlar tashlana boshlaydi — lekin GPU ning yuklanishiga qarang: u hech qachon to'lmaydi. Protsessor ham to'liq band emas. Unda nima to'lyapti? Bitta Python jarayonining asosiy sikli: har bir kadr uchun predict ning tayyorlash va tozalash qismi, tracker, natijalarni ko'chirish — hammasi bitta ipda (Python GIL). Sikl sekundiga bir necha yuz kadrdan ko'pini ulgurmaydi.
NVDEC yo'li 48 kamerada boshqa sabab bilan qulaydi — oxirgi ustunga qarang. Har bir ffmpeg jarayoni GPU da o'z CUDA kontekstini ochadi va ~350 MB xotira oladi (16 dan 32 kameragacha xotira 5.7 GB ga oshdi); 48 kamerada 16 GB karta to'ladi. NVDEC ni o'nlab kamerada ishlatish uchun hamma dekoderlarni bitta jarayonda ushlab turadigan vosita kerak — masalan, NVIDIA DeepStream yoki PyNvVideoCodec (bu kitobda o'lchanmagan).
Buni tekshirish oson: bitta jarayon o'rniga bir nechtasini ishga tushiramiz, har biriga 32 kamera.
qatorlar = []
for nusxa in (1, 2, 3):
    natija = ishchilar("sub", 32, nusxa)
    qatorlar.append({"jarayonlar": nusxa, "jami kameralar": 32 * nusxa, "kameraga ishlangan kadr/s": np.mean([r["ishlandi"] for r in natija]),
                     "jami ishlangan kadr/s": sum(r["ishlandi"] for r in natija) * 32, "GPU, %": natija[0]["gpu"], "CPU, %": natija[0]["cpu"],
                     "GPU xotirasi, MB (jarayonga)": (max(r["gpu_xotira"] for r in natija) - asos) / nusxa,
                     "RAM, MB (jarayonga)": np.mean([r["ram"] for r in natija])})
show(pd.DataFrame(qatorlar).round(1))
| jarayonlar | jami kameralar | kameraga ishlangan kadr/s | jami ishlangan kadr/s | GPU, % | CPU, % | GPU xotirasi, MB (jarayonga) | RAM, MB (jarayonga) |
|---|---|---|---|---|---|---|---|
| 1 | 32 | 15 | 479.7 | 18.8 | 18.8 | 837 | 2 603.4 |
| 2 | 64 | 13.2 | 841.8 | 41 | 37.9 | 1 175.5 | 2 615.4 |
| 3 | 96 | 10.9 | 1 048.8 | 52 | 54.5 | 1 147 | 2 616.9 |
Jarayonlar qo'shilgan sari tizimning umumiy o'tkazuvchanligi oshadi (sekundiga ~480 dan ~1050 kadrgacha) va GPU yuklanishi ko'tariladi — cheklov haqiqatan Python siklida edi. O'sish chiziqli emas: jarayonlar bir GPU ni navbat bilan ishlatadi va 8 ta protsessor ipini bo'lishadi. Uchta jarayon bilan bizning kompyuter sekundiga ~1050 kadrga ulgurdi — bu taxminan 70 kamera × 15 kadr/s. Har bir ishchi jarayon ~2.6 GB operativ xotira va ~1 GB GPU xotirasi oladi. Amaliy xulosa: kameralarni guruhlarga bo'lib, har guruhga alohida ishchi jarayon bering.
Va GPU siz — faqat protsessorda:
show(pd.DataFrame([{"kameralar": n, **{k: v for k, v in ishchilar("sub", n, model="weights/yolo11n.pt", qurilma="cpu", soniya=15)[0].items()
                                          if k in ("ishlandi", "tashlandi", "cpu")}} for n in (1, 2, 4)]).round(1))
| kameralar | ishlandi | tashlandi | cpu |
|---|---|---|---|
| 1 | 15.1 | 1.3 | 35.8 |
| 2 | 15 | 0.9 | 55.9 |
| 4 | 15 | 1.3 | 86.9 |
Protsessorning o'zida (8 ip) YOLO11n to'rtta kamerani sekundiga 15 kadr bilan ko'taradi — batch bu yerda ham yordam beradi — lekin protsessor deyarli to'liq band bo'ladi va boshqa ishlarga joy qolmaydi. Kichik do'kon uchun bu yetishi mumkin; odam sanash uchun sekundiga 5 kadr ham yetadi — unda bir necha barobar ko'p kamera sig'adi.
Hisob-kitob qoidalari
O'lchovlardan loyihalash uchun qoidalar:
- Birinchi to'ladigan narsa — GPU emas. Kichik modelda (YOLO11n) tizimni dekodlash, tayyorlash va Python sikli cheklaydi. Kameralarni bir nechta ishchi jarayonga bo'ling.
- Ikkinchi oqimni ishlating.
imgsz=640bilan detection uchun kameraning 360p oqimi deyarli bir xil natija beradi va dekodlash bir necha barobar arzon. Asosiy oqim — yozib olish va qirqimlar uchun. - Batch. Bir necha kameraning kadrlarini birga yuboring; TensorRT dvigatelini kerakli batch bilan eksport qiling.
- fps ni vazifaga moslang. Odam sanash va zonalar uchun sekundiga 5–10 kadr ko'pincha yetadi; tracker uchun past fps da ByteTrack ning
track_bufferi va Kalman tezlik modeli muhimroq bo'ladi (15-bob). 15 fps o'rniga 10 fps — sig'im bir yarim barobar ko'p. - Zaxira qoldiring. Sinovlarimiz faqat detection va tracker; real tizimda hodisalarni yozish, video saqlash va web-panel ham resurs oladi. O'lchangan sig'imning 60–70% i bilan loyihalang.
- Xotira. Har bir ishchi jarayon ~2.6 GB operativ xotira va ~1 GB GPU xotirasi (bizning o'lchov). NVDEC ni har kameraga alohida ffmpeg bilan ishlatsangiz, har biriga yana ~350 MB GPU xotirasi qo'shing.
- Tarmoq va disk (17-bob): kameralar soni × bitreyt. Yozib olish asosiy oqimda bo'lsa, disk hajmi — shu.
Bizning kompyuterning sig'imi — yuqoridagi jadvallarda. Boshqa kompyuterda bu sonlar boshqacha bo'ladi: bu bobning kodini (kod/18_kamera_ishchisi.py) o'sha kompyuterda ishga tushiring — bir necha daqiqada o'z sonlaringiz bo'ladi. Mijozga taklif shu o'lchovga tayanadi, taxminga emas.
Asosiy fikr
- Tizim zanjir: dekodlash → tayyorlash → model → tozalash → tracker. Eng sekin bo'g'in sig'imni belgilaydi, va kichik modelda bu odatda model emas.
- NVDEC protsessorni bo'shatadi, lekin 1080p kadrni Python ga ko'chirish qimmat: NVDEC ning o'zida kichraytiring yoki kameraning ikkinchi oqimini oling.
- Batch va TensorRT modelni bir necha barobar tezlashtiradi; bitta Python jarayoni esa sekundiga bir necha yuz kadrdan ko'pini ulgurmaydi — bir nechta ishchi jarayon kerak.
- Sig'imni o'z apparatingizda o'lchang: bu bobning ishchi skripti N ta kamerani real vaqtda soxtalashtiradi.
Mashqlar
--usul subbilan 32 kamerani 10 fps da sinang (skriptdaFPSni o'zgartiring). Sig'im qanchaga oshadi?- Ishchi skriptga YOLO11n o'rniga YOLO11s dvigatelini bering (xuddi shunday eksport qiling). Endi birinchi bo'lib nima to'ladi — GPU mi yoki Python sikli?
- Asosiy siklda tracker ni o'chirib (faqat detection), bitta jarayonning sig'imini qayta o'lchang. Tracker qancha vaqt olayotgan ekan?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.