Tajribalarni kuzatish: MLflow
Payshanba kuni topilgan 0.87
Seshanba kuni model ustida ishladingiz. Parametrlarni o'zgartirdingiz, xususiyat qo'shdingiz, qayta o'qitdingiz. Yana. Yana.
Kunning bir payti ekranda 0.87 chiqdi. Eng yaxshi natija. "Zo'r!" dedingiz va ishni davom ettirdingiz — yana bir necha variant sinab ko'rish uchun.
Kechqurun 0.84 da to'xtadingiz.
Payshanba kuni boshliq so'radi: — Eng yaxshi natijangiz qancha edi?
— 0.87, dedingiz.
— Zo'r. O'shani chiqaraylik.
Va shu payda qorningizda sovuq bir narsa paydo bo'ladi. Chunki siz qaysi sozlama 0.87 berganini eslay olmaysiz.
Daraxtlar soni 200 mi, 400 mi edi? Barg chuqurligi qancha? Xususiyat qo'shgandim — qaysi biri? Jupyter katakchasini qayta ishga tushirgansiz, eski natija ustidan yozilgan.
Ikki kun ish. Natija yo'q. Qaytadan boshlaysiz.
Bu kimningdir aybi emas
Bu hikoyani deyarli har bir ML muhandisi boshidan kechirgan. Va diqqat qiling: bu yerda hech kim beparvolik qilmadi.
Siz yozib borishingiz kerak edi — lekin tajriba paytida odam yozib bormaydi. Fikr ketma-ket keladi: "buni sinab ko'ray... endi buni... voy, qiziq..." Har safar to'xtab, jadvalga o'tib, parametrlarni ko'chirish — fikr oqimini uzadi.
Shuning uchun yechim "ehtiyotkor bo'ling" emas. Yechim — yozib borishni odamdan olib qo'yish.
Kutubxonachini eslang (23-bobda batafsil ko'ramiz): u har kitobni qo'lda daftarga yozmaydi, skaner bor. Bu yerda ham shunday kerak — kod ishga tushganda o'zi yozib qo'ysin.
MLflow aynan shuni qiladi.
Nega qo'lda usullar ishlamaydi
Avval mavjud usullarni ko'rib chiqamiz — ularning har biri sizga tanish bo'lishi mumkin:
import pandas as pd
show(pd.DataFrame([
    {"usul": "Jupyter katakchalari", "muammo": "Oldingi natija ustidan yozib ketiladi"},
    {"usul": "Excel jadvali", "muammo": "Qo'lda to'ldiriladi — unutiladi, xato yoziladi"},
    {"usul": "Fayl nomlari (model_v3_final2)", "muammo": "Qaysi parametr bilan — noma'lum"},
    {"usul": "Jurnal fayllari", "muammo": "Taqqoslash uchun qidirish kerak"},
]))
| usul | muammo |
|---|---|
| Jupyter katakchalari | Oldingi natija ustidan yozib ketiladi |
| Excel jadvali | Qo'lda to'ldiriladi — unutiladi, xato yoziladi |
| Fayl nomlari (model_v3_final2) | Qaysi parametr bilan — noma'lum |
| Jurnal fayllari | Taqqoslash uchun qidirish kerak |
Kerak bo'lgan narsa: har tajriba avtomatik yozilsin — parametrlar, metrikalar, artefaktlar va 2-bobdagi pasport ma'lumotlari.
MLflow nima qiladi
diagramma(
    {
        "O'qitish skripti": (0, 1.4, 2.6, 1.1, "qayta"),
        "mlflow.log_param\nlog_metric, log_artifact": (3.4, 1.4, 3.0, 1.1, "manba"),
        "Kuzatuv ombori\n(fayl yoki server)": (7.2, 1.4, 2.8, 1.1, "saqlash"),
        "Taqqoslash UI\nva API": (7.2, 3.6, 2.8, 1.1, "kuzatuv"),
    },
    [
        ("O'qitish skripti", "mlflow.log_param\nlog_metric, log_artifact"),
        ("mlflow.log_param\nlog_metric, log_artifact", "Kuzatuv ombori\n(fayl yoki server)"),
        ("Kuzatuv ombori\n(fayl yoki server)", "Taqqoslash UI\nva API"),
    ],
    nom="mlflow_oqimi.png", kenglik=12,
    izoh="Skript uch xil narsani yozadi: parametr (kirish), metrika (natija), artefakt (model va fayllar).",
)
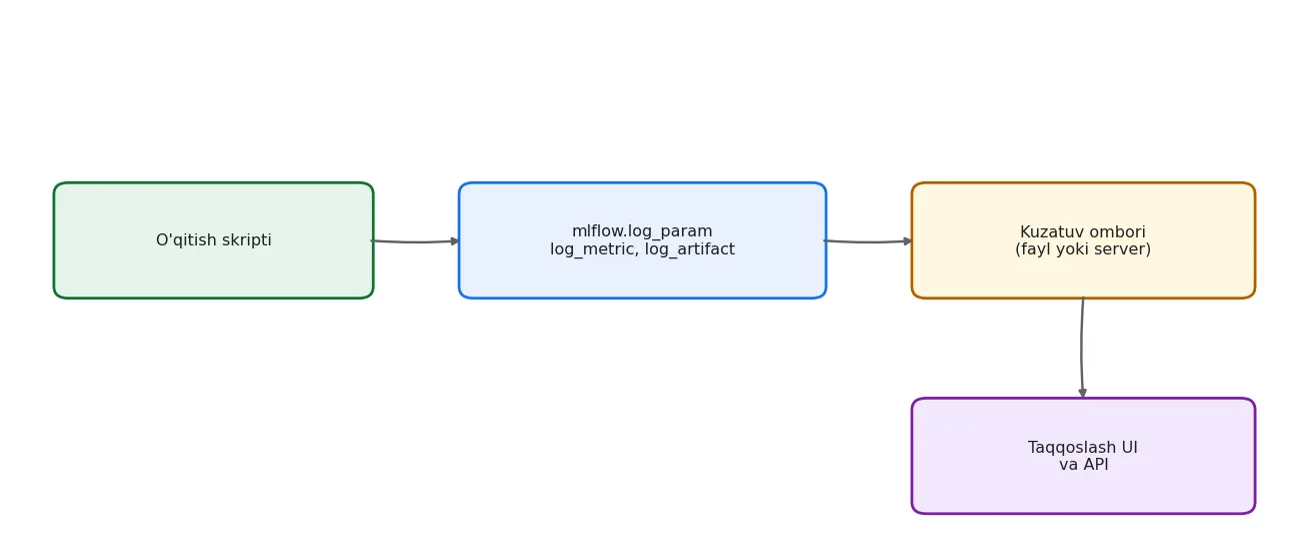
Skript uch xil narsani yozadi: parametr (kirish), metrika (natija), artefakt (model va fayllar).
MLflow da hammasi uchta tushunchaga bo'linadi. Ularni ajratish muhim, chunki har biri boshqa vaqtda paydo bo'ladi.
Ovqat pishirishga o'xshating:
- Parametr — retseptdagi miqdorlar. Ularni boshlashdan oldin bilasiz: 200 gramm un, 180 daraja, 40 daqiqa.
- Metrika — tayyor taomning bahosi. Uni oxirida olasiz: mazasi 8/10.
- Artefakt — taomning o'zi va surati. Fayl.
| Tushuncha | Nima | Qachon ma'lum | Misol |
|---|---|---|---|
| Parametr | Kirish sozlamasi | O'qitishdan oldin | n_estimators=150 |
| Metrika | Natija, o'lchov | O'qitishdan keyin | f1=0.8603 |
| Artefakt | Fayl: model, grafik | O'qitishdan keyin | model/ |
Nega bu ajratish muhim? Chunki savollaringiz shu bo'yicha tuziladi:
"F1 eng yuqori (metrika) bo'lgan tajribada daraxtlar soni (parametr) qancha edi?"
Agar hammasi bitta qopga tashlansa, bunday savol berib bo'lmaydi. Ajratilgan bo'lsa — bu oddiy so'rov.
Parametrni metrika deb yozib yubormang
Eng ko'p uchraydigan chalkashlik: train_size=0.75 ni metrika sifatida yozish.
U son, lekin u natija emas — siz uni o'zingiz tanlagansiz. Metrika deb yozsangiz, "eng yaxshi natija" ro'yxatida u ham paydo bo'ladi va jadvalni chalkashtiradi.
Oddiy qoida: men tanladimmi — parametr. Model menga berdimi — metrika.
python3 -c "import mlflow; print('MLflow', mlflow.__version__)" 2>/dev/null
MLflow 3.16.1
Fayl ombori (`./mlruns`) endi eskirgan
Ko'p darslikda mlflow.set_tracking_uri("file:./mlruns") yoziladi. MLflow 3.x da bu
xato beradi:
The filesystem tracking backend is in maintenance mode and will not receive
further updates. Please migrate to a database backend (e.g. 'sqlite:///mlflow.db')
Shuning uchun biz boshidanoq SQLite ishlatamiz. Foydasi ikki tomonlama: eskirgan yo'lga kirmaymiz va lokal ombor serverdagi Postgres bilan bir xil turda bo'ladi — faqat manzil farq qiladi.
Birinchi tajriba
shu faylni yaratingsrc/quvur/kuzatuv.py
"""MLflow bilan tajriba kuzatuvi.

Kitobda kuzatuv ombori LOKAL SQLite faylida — server kerak emas, lekin
ma'lumotlar bazasi imkoniyatlari bor. Ishlab chiqarishda `MLFLOW_TRACKING_URI`
ni Postgres li serverga yo'naltiriladi va KOD O'ZGARMAYDI.
"""
import os
from contextlib import contextmanager
from pathlib import Path
from typing import Any, Iterator

import mlflow


def omborni_sozla(db: str | Path = "mlflow.db",
                  artefakt: str | Path = "mlartefaktlar") -> str:
    """Kuzatuv omborini belgilaydi. Muhit o'zgaruvchisi ustun turadi (11-bob qoidasi)."""
    uri = os.environ.get("MLFLOW_TRACKING_URI")
    if not uri:
        uri = f"sqlite:///{Path(db).absolute()}"
    Path(artefakt).mkdir(parents=True, exist_ok=True)
    mlflow.set_tracking_uri(uri)
    return uri


@contextmanager
def tajriba(nom: str, yugurish: str | None = None,
            teglar: dict[str, str] | None = None) -> Iterator[Any]:
    """Tajriba konteksti. Xato bo'lsa ham yugurish yopiladi va holati yoziladi."""
    mlflow.set_experiment(nom)
    with mlflow.start_run(run_name=yugurish) as r:
        if teglar:
            mlflow.set_tags(teglar)
        try:
            yield r
        except Exception as e:
            mlflow.set_tag("xato", f"{type(e).__name__}: {e}"[:250])
            raise
shu faylni yaratingoqit_mlflow.py
"""MLflow bilan o'qitish: parametr, metrika va artefakt yoziladi."""
import sys
from pathlib import Path

sys.path.insert(0, "src")

import joblib
import mlflow
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import f1_score, precision_score, recall_score, roc_auc_score

from quvur.kuzatuv import omborni_sozla, tajriba
from quvur.manifest import fayl_hash
from quvur.takrorlanish import seedni_qulfla

MALUMOT = "../datasets/ijara.csv"
XUS = ["xonalar", "maydon", "qavat", "jami_qavat", "narx_mln", "tavsif_uzunligi",
       "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar", "egasi_tasdiqlangan"]
SEED = 42


def bitta_yugurish(param: dict, nom: str) -> dict:
    seedni_qulfla(SEED)
    d = pd.read_csv(MALUMOT)
    Xtr, Xte, ytr, yte = train_test_split(d[XUS], d["broker"], test_size=0.25,
                                          stratify=d["broker"], random_state=SEED)
    with tajriba("broker-aniqlash", nom, teglar={"model_turi": "random_forest"}):
        mlflow.log_params({**param, "seed": SEED, "oqitish_qatorlari": len(Xtr)})
        # 2-bobdagi pasport: ma'lumot qaysi versiya edi
        mlflow.set_tag("malumot_sha256", fayl_hash(MALUMOT)[:16])

        m = RandomForestClassifier(**param, random_state=SEED, n_jobs=1).fit(Xtr, ytr)
        p, e = m.predict(Xte), m.predict_proba(Xte)[:, 1]
        metrikalar = {
            "f1": float(f1_score(yte, p)),
            "aniqlik": float(precision_score(yte, p)),
            "toliqlik": float(recall_score(yte, p)),
            "auc": float(roc_auc_score(yte, e)),
        }
        mlflow.log_metrics(metrikalar)

        # MUHIM: log_artifact EMAS, log_model.
        # log_artifact oddiy fayl saqlaydi; log_model esa MLmodel tavsifi bilan
        # to'liq model artefaktini yasaydi — 23-bobdagi registr faqat shuni qabul qiladi.
        mlflow.sklearn.log_model(
            m, name="model", input_example=Xtr.head(3),
            # MLflow 3.x sklearn modelini `skops` bilan saqlaydi va daraxt turlarini
            # XAVFSIZLIK sababli rad etadi. Nega — quyidagi izohda.
            skops_trusted_types=["sklearn.tree._tree.Tree"],
        )
        return metrikalar


if __name__ == "__main__":
    print("ombor:", omborni_sozla())
    n = bitta_yugurish({"n_estimators": 150, "min_samples_leaf": 3}, "asosiy")
    print("metrikalar:", {k: round(v, 4) for k, v in n.items()})
python3 oqit_mlflow.py
ombor: sqlite:////mnt/c/Users/Admin/Desktop/Course Material/MLOps_Kitob/ish/mlflow.db
metrikalar: {'f1': 0.8603, 'aniqlik': 0.8947, 'toliqlik': 0.8285, 'auc': 0.9148}
/home/abulqosim/.local/lib/python3.10/site-packages/requests/__init__.py:113: RequestsDependencyWarning: urllib3 (2.6.3) or chardet (6.0.0.post1)/charset_normalizer (3.4.4) doesn't match a supported version!
  warnings.warn(
2026/09/29 18:24:57 INFO mlflow.agent.hint: Load the `instrumenting-with-mlflow-tracing` skill at /home/abulqosim/.local/lib/python3.10/site-packages/mlflow/assistant/skills/instrumenting-with-mlflow-tracing/SKILL.md before writing any tracing code; it ships with this MLflow install. Set MLFLOW_DISABLE_AGENT_HINT=1 to silence this.
2026/09/29 18:24:58 INFO mlflow.store.db.utils: Creating initial MLflow database tables...
2026/09/29 18:24:58 INFO mlflow.store.db.utils: Updating database tables
2026/09/29 18:25:02 INFO mlflow.tracking.fluent: Experiment with name 'broker-aniqlash' does not exist. Creating a new experiment.
/home/abulqosim/.local/lib/python3.10/site-packages/mlflow/types/utils.py:440: UserWarning: Hint: Inferred schema contains integer column(s). Integer columns in Python cannot represent missing values. If your input data contains missing values at inference time, it will be encoded as floats and will cause a schema enforcement error. The best way to avoid this problem is to infer the model schema based on a realistic data sample (training dataset) that includes missing values. Alternatively, you can declare integer columns as doubles (float64) whenever these columns may have missing values. See `Handling Integers With Missing Values <https://www.mlflow.org/docs/latest/models.html#handling-integers-with-missing-values>`_ for more details.
  warnings.warn(
2026/09/29 18:25:10 WARNING mlflow.utils.requirements_utils: Found torch version (2.9.1+cu128) contains a local version label (+cu128). MLflow logged a pip requirement for this package as 'torch==2.9.1' without the local version label to make it installable from PyPI. To specify pip requirements containing local version labels, please use `conda_env` or `pip_requirements`.
Yozilganini tekshiramiz — MLflow ning o'z API si orqali:
python3 -c "
import sys; sys.path.insert(0, 'src')
import mlflow
from quvur.kuzatuv import omborni_sozla
omborni_sozla()
y = mlflow.search_runs(experiment_names=['broker-aniqlash'])
print('yugurishlar:', len(y))
ustunlar = [c for c in y.columns if c.startswith(('params.','metrics.','tags.malumot'))]
print()
for c in sorted(ustunlar):
    print(f'  {c:36} {y.iloc[0][c]}')
"
yugurishlar: 1

  metrics.aniqlik                      0.8947368421052632
  metrics.auc                          0.9147708787977373
  metrics.f1                           0.8603406326034063
  metrics.toliqlik                     0.8284910965323337
  params.min_samples_leaf              3
  params.n_estimators                  150
  params.oqitish_qatorlari             9000
  params.seed                          42
  tags.malumot_sha256                  03dbeed95e47e74c
/home/abulqosim/.local/lib/python3.10/site-packages/requests/__init__.py:113: RequestsDependencyWarning: urllib3 (2.6.3) or chardet (6.0.0.post1)/charset_normalizer (3.4.4) doesn't match a supported version!
  warnings.warn(
2026/09/29 18:25:12 INFO mlflow.agent.hint: Load the `instrumenting-with-mlflow-tracing` skill at /home/abulqosim/.local/lib/python3.10/site-packages/mlflow/assistant/skills/instrumenting-with-mlflow-tracing/SKILL.md before writing any tracing code; it ships with this MLflow install. Set MLFLOW_DISABLE_AGENT_HINT=1 to silence this.
Bitta chaqiruv bilan hamma narsa saqlandi: parametrlar, to'rt metrika, ma'lumot hash i va model.
Daraxt modellari uchun `skops_trusted_types` kerak
MLflow 3.x sklearn modellarini skops formatida saqlaydi va daraxtga asoslangan modellarni
sukut bo'yicha rad etadi:
The saved sklearn model references untrusted types...
Untrusted types found in the file: ['sklearn.tree._tree.Tree']
Bu bezorilik emas, xavfsizlik chorasi. sklearn.tree._tree.Tree tugun indekslarini xom
massivda saqlaydi va sklearn ularni chegara tekshiruvisiz ishlatadi. Buzib yozilgan fayl
.predict() chaqirilganda jarayonni yiqitishi yoki begona xotirani o'qishi mumkin.
Shuning uchun o'zingiz yaratgan modelga skops_trusted_types=["sklearn.tree._tree.Tree"]
beriladi. Tashqaridan kelgan model fayliga esa bu ishonchni bermang — bu 26-bobdagi
pickle xavfining aynan o'sha turdagi muammosi.
`log_artifact` va `log_model` — bir xil emas
mlflow.log_artifact("model.joblib") shunchaki faylni yuklaydi. MLflow uning ichida nima
borligini bilmaydi.
mlflow.sklearn.log_model(m, name="model") esa MLmodel tavsifini yasaydi: qaysi kutubxona,
qanday kirish shakli, qanday muhit kerak. 23-bobdagi registr faqat shunday artefaktni qabul
qiladi — log_artifact bilan saqlangan modelni ro'yxatga olib bo'lmaydi.
Bir necha tajribani taqqoslash
Endi bob boshidagi hikoyaga qaytamiz. Seshanba kuni siz to'rt variantni sinab ko'rgan edingiz va payshanbaga qadar qaysi biri 0.87 berganini unutdingiz.
Bu safar boshqacha bo'ladi. To'rt variantni ishga tushiramiz — lekin hech narsani yozib olmaymiz, hech qayerga ko'chirmaymiz. Faqat ishga tushiramiz:
python3 -c "
import sys; sys.path.insert(0, 'src')
sys.argv = ['x']
exec(open('oqit_mlflow.py').read().split('if __name__')[0])
omborni_sozla()
VARIANTLAR = [
    ({'n_estimators': 30,  'min_samples_leaf': 1},  'kichik-30'),
    ({'n_estimators': 150, 'min_samples_leaf': 3},  'asosiy'),
    ({'n_estimators': 400, 'min_samples_leaf': 3},  'katta-400'),
    ({'n_estimators': 150, 'min_samples_leaf': 20}, 'sodda-barg20'),
]
for p, nom in VARIANTLAR:
    m = bitta_yugurish(p, nom)
    print(f\"  {nom:14} F1={m['f1']:.4f}  AUC={m['auc']:.4f}\")
"
  kichik-30      F1=0.8585  AUC=0.9156
  asosiy         F1=0.8603  AUC=0.9148
  katta-400      F1=0.8583  AUC=0.9152
  sodda-barg20   F1=0.8630  AUC=0.9139
/home/abulqosim/.local/lib/python3.10/site-packages/requests/__init__.py:113: RequestsDependencyWarning: urllib3 (2.6.3) or chardet (6.0.0.post1)/charset_normalizer (3.4.4) doesn't match a supported version!
  warnings.warn(
2026/09/29 18:25:15 INFO mlflow.agent.hint: Load the `instrumenting-with-mlflow-tracing` skill at /home/abulqosim/.local/lib/python3.10/site-packages/mlflow/assistant/skills/instrumenting-with-mlflow-tracing/SKILL.md before writing any tracing code; it ships with this MLflow install. Set MLFLOW_DISABLE_AGENT_HINT=1 to silence this.
/home/abulqosim/.local/lib/python3.10/site-packages/mlflow/types/utils.py:440: UserWarning: Hint: Inferred schema contains integer column(s). Integer columns in Python cannot represent missing values. If your input data contains missing values at inference time, it will be encoded as floats and will cause a schema enforcement error. The best way to avoid this problem is to infer the model schema based on a realistic data sample (training dataset) that includes missing values. Alternatively, you can declare integer columns as doubles (float64) whenever these columns may have missing values. See `Handling Integers With Missing Values <https://www.mlflow.org/docs/latest/models.html#handling-integers-with-missing-values>`_ for more details.
  warnings.warn(
2026/09/29 18:25:24 WARNING mlflow.utils.requirements_utils: Found torch version (2.9.1+cu128) contains a local version label (+cu128). MLflow logged a pip requirement for this package as 'torch==2.9.1' without the local version label to make it installable from PyPI. To specify pip requirements containing local version labels, please use `conda_env` or `pip_requirements`.
/home/abulqosim/.local/lib/python3.10/site-packages/mlflow/types/utils.py:440: UserWarning: Hint: Inferred schema contains integer column(s). Integer columns in Python cannot represent missing values. If your input data contains missing values at inference time, it will be encoded as floats and will cause a schema enforcement error. The best way to avoid this problem is to infer the model schema based on a realistic data sample (training dataset) that includes missing values. Alternatively, you can declare integer columns as doubles (float64) whenever these columns may have missing values. See `Handling Integers With Missing Values <https://www.mlflow.org/docs/latest/models.html#handling-integers-with-missing-values>`_ for more details.
  warnings.warn(
2026/09/29 18:25:31 WARNING mlflow.utils.requirements_utils: Found torch version (2.9.1+cu128) contains a local version label (+cu128). MLflow logged a pip requirement for this package as 'torch==2.9.1' without the local version label to make it installable from PyPI. To specify pip requirements containing local version labels, please use `conda_env` or `pip_requirements`.
/home/abulqosim/.local/lib/python3.10/site-packages/mlflow/types/utils.py:440: UserWarning: Hint: Inferred schema contains integer column(s). Integer columns in Python cannot represent missing values. If your input data contains missing values at inference time, it will be encoded as floats and will cause a schema enforcement error. The best way to avoid this problem is to infer the model schema based on a realistic data sample (training dataset) that includes missing values. Alternatively, you can declare integer columns as doubles (float64) whenever these columns may have missing values. See `Handling Integers With Missing Values <https://www.mlflow.org/docs/latest/models.html#handling-integers-with-missing-values>`_ for more details.
  warnings.warn(
2026/09/29 18:25:41 WARNING mlflow.utils.requirements_utils: Found torch version (2.9.1+cu128) contains a local version label (+cu128). MLflow logged a pip requirement for this package as 'torch==2.9.1' without the local version label to make it installable from PyPI. To specify pip requirements containing local version labels, please use `conda_env` or `pip_requirements`.
/home/abulqosim/.local/lib/python3.10/site-packages/mlflow/types/utils.py:440: UserWarning: Hint: Inferred schema contains integer column(s). Integer columns in Python cannot represent missing values. If your input data contains missing values at inference time, it will be encoded as floats and will cause a schema enforcement error. The best way to avoid this problem is to infer the model schema based on a realistic data sample (training dataset) that includes missing values. Alternatively, you can declare integer columns as doubles (float64) whenever these columns m
... (qisqartirildi)
python3 -c "
import sys; sys.path.insert(0, 'src')
import mlflow, pandas as pd
from quvur.kuzatuv import omborni_sozla
omborni_sozla()
y = mlflow.search_runs(experiment_names=['broker-aniqlash'], order_by=['metrics.f1 DESC'])
j = y[['tags.mlflow.runName','params.n_estimators','params.min_samples_leaf',
       'metrics.f1','metrics.auc','metrics.toliqlik']].copy()
j.columns = ['nom','daraxtlar','barg','F1','AUC','toliqlik']
for c in ['F1','AUC','toliqlik']:
    j[c] = j[c].astype(float).round(4)
print(j.to_string(index=False))
"
         nom daraxtlar barg     F1    AUC  toliqlik
sodda-barg20       150   20 0.8630 0.9139    0.8266
      asosiy       150    3 0.8603 0.9148    0.8285
      asosiy       150    3 0.8603 0.9148    0.8285
   kichik-30        30    1 0.8585 0.9156    0.8276
   katta-400       400    3 0.8583 0.9152    0.8257
/home/abulqosim/.local/lib/python3.10/site-packages/requests/__init__.py:113: RequestsDependencyWarning: urllib3 (2.6.3) or chardet (6.0.0.post1)/charset_normalizer (3.4.4) doesn't match a supported version!
  warnings.warn(
2026/09/29 18:25:51 INFO mlflow.agent.hint: Load the `instrumenting-with-mlflow-tracing` skill at /home/abulqosim/.local/lib/python3.10/site-packages/mlflow/assistant/skills/instrumenting-with-mlflow-tracing/SKILL.md before writing any tracing code; it ships with this MLflow install. Set MLFLOW_DISABLE_AGENT_HINT=1 to silence this.
Mana shu jadval — bobning butun sababi.
Uni hech kim qo'lda to'ldirmadi. Hech kim parametrlarni ko'chirmadi. search_runs chaqiruvi
omborga so'rov yubordi va javob qaytardi — xuddi ma'lumotlar bazasidagidek, chunki u
haqiqatan ham ma'lumotlar bazasi (SQLite).
Endi payshanba kuni boshliq so'rasa, javob bir buyruqda. Jadval F1 bo'yicha tartiblangan, va har qatorda o'sha natijani bergan aniq sozlama turibdi.
Natija qiziq: eng yaxshi F1 ni sodda-barg20 berdi (0.8630) — eng sodda barglarga ega
variant. katta-400 esa 400 ta daraxt bilan eng pastda (0.8583).
Ya'ni murakkabroq model har doim yaxshiroq emas.
Buni aytish oson, lekin kuzatuvsiz buni bilib bo'lmasdi. Siz 400 ta daraxtli variantni sinab ko'rasiz, natija yomonroq chiqadi, va "nimadir xato qildim" deb o'ylab qaytadan urinasiz. Jadval esa aniq ko'rsatadi: xato qilmadingiz, model shunchaki ortiqcha murakkab.
Yana bir muhim narsa bor va u ko'zga darhol tashlanmaydi. AUC bo'yicha tartib boshqacha —
u yerda kichik-30 yetakchi.
Demak "eng yaxshi model" degan savolning javobi qaysi ustunga qaraganingizga bog'liq. F1 bo'yicha bitta g'olib, AUC bo'yicha boshqasi. Agar siz faqat bitta metrikani yozib borgan bo'lsangiz, bu haqiqatni umuman ko'rmas edingiz.
1-bobdagi saboq shu yerda takrorlanadi: model o'zi haqida sizga hech narsa aytmaydi. Siz nimani o'lchasangiz — shuni ko'rasiz, va o'lchamagan narsangiz yashirin qoladi.
Xato bo'lganda ham yoziladi
python3 -c "
import sys; sys.path.insert(0, 'src')
import mlflow
from quvur.kuzatuv import omborni_sozla, tajriba
omborni_sozla()
try:
    with tajriba('broker-aniqlash', 'ataylab-yiqiladi'):
        mlflow.log_param('n_estimators', 99)
        raise MemoryError('xotira yetmadi')
except MemoryError:
    pass

y = mlflow.search_runs(experiment_names=['broker-aniqlash'],
                       filter_string=\"tags.mlflow.runName = 'ataylab-yiqiladi'\")
r = y.iloc[0]
print('holat      :', r['status'])
print('parametr   :', r['params.n_estimators'])
print('xato tegi  :', r['tags.xato'])
"
holat      : FAILED
parametr   : 99
xato tegi  : MemoryError: xotira yetmadi
/home/abulqosim/.local/lib/python3.10/site-packages/requests/__init__.py:113: RequestsDependencyWarning: urllib3 (2.6.3) or chardet (6.0.0.post1)/charset_normalizer (3.4.4) doesn't match a supported version!
  warnings.warn(
2026/09/29 18:25:53 INFO mlflow.agent.hint: Load the `instrumenting-with-mlflow-tracing` skill at /home/abulqosim/.local/lib/python3.10/site-packages/mlflow/assistant/skills/instrumenting-with-mlflow-tracing/SKILL.md before writing any tracing code; it ships with this MLflow install. Set MLFLOW_DISABLE_AGENT_HINT=1 to silence this.
Yiqilgan tajriba ham yozildi — holati FAILED, sababi teg sifatida saqlandi. Bu muhim: "nega
o'sha tajriba natija bermagan edi?" degan savolga javob qoladi.
Ombor ichida nima bor
ls -la mlflow.db 2>/dev/null | awk '{print "kuzatuv bazasi:", $NF, $5, "bayt"}'
echo "--- bazadagi jadvallar ---"
python3 -c "
import sqlite3
con = sqlite3.connect('mlflow.db')
t = [r[0] for r in con.execute(\"SELECT name FROM sqlite_master WHERE type='table'\")]
print(' ', ', '.join(sorted(t)[:8]))
print('  yugurishlar:', con.execute('SELECT COUNT(*) FROM runs').fetchone()[0])
print('  metrikalar :', con.execute('SELECT COUNT(*) FROM metrics').fetchone()[0])
con.close()
"
echo "--- artefaktlar ---"
find mlartefaktlar -name "*.joblib" 2>/dev/null | head -3
du -sh mlartefaktlar 2>/dev/null | cut -f1 | xargs -I{} echo "artefakt hajmi: {}"
kuzatuv bazasi: mlflow.db 876544 bayt
--- bazadagi jadvallar ---
  alembic_version, assessments, budget_policies, datasets, endpoint_bindings, endpoint_model_mappings, endpoint_tags, endpoints
  yugurishlar: 6
  metrikalar : 20
--- artefaktlar ---
artefakt hajmi: 0
Metrikalar, parametrlar va teglar SQLite jadvallarida yotadi — yuqorida runs va metrics
jadvallaridagi yozuvlar soni ko'rinib turibdi. Artefaktlar (model fayllari) esa alohida
papkada saqlanadi.
Hech qanday server kerak emas — bu bitta odam yoki kichik jamoa uchun yetarli.
Fayl ombori va server
import pandas as pd
show(pd.DataFrame([
    {"usul": "SQLite (mlflow.db)", "qachon": "Bitta odam, lokal ish",
     "kamchiligi": "Bo'lishib bo'lmaydi, bir vaqtda yozish cheklangan"},
    {"usul": "MLflow server + Postgres", "qachon": "Jamoa, umumiy tarix",
     "kamchiligi": "Server saqlash kerak"},
    {"usul": "Server + S3/MinIO artefakt", "qachon": "Katta modellar (GB)",
     "kamchiligi": "Ombor xarajati"},
    {"usul": "Boshqariladigan (Databricks, W&B)", "qachon": "Infratuzilma bilan shug'ullanmaslik",
     "kamchiligi": "Narx, vendor bog'liqligi"},
]))
| usul | qachon | kamchiligi |
|---|---|---|
| SQLite (mlflow.db) | Bitta odam, lokal ish | Bo'lishib bo'lmaydi, bir vaqtda yozish cheklangan |
| MLflow server + Postgres | Jamoa, umumiy tarix | Server saqlash kerak |
| Server + S3/MinIO artefakt | Katta modellar (GB) | Ombor xarajati |
| Boshqariladigan (Databricks, W&B) | Infratuzilma bilan shug'ullanmaslik | Narx, vendor bog'liqligi |
Serverga o'tish bitta o'zgaruvchi bilan bo'ladi — kod o'zgarmaydi:
export MLFLOW_TRACKING_URI=http://mlflow.ichki:5000
python3 oqit_mlflow.py          # endi serverga yozadi
Bu 11-bobdagi qoidaning to'g'ridan-to'g'ri qo'llanishi: manzil konfiguratsiyada, kodda emas.
Hamma narsani log qilmang
MLflow ga har qadamni yozish vasvasasi bor. Lekin:
- Artefakt hajmi tez o'sadi — har yugurishda 15 MB model 100 tajribada 1.5 GB bo'ladi
- Maxfiy ma'lumot tasodifan tushishi mumkin (11-bob: parol, token)
- Shovqin — 50 ta metrika orasidan muhimini topish qiyin
Qoida: qaror qabul qilish uchun kerak bo'lgan narsani yozing. Qolgani jurnalga.
Pasport bilan bog'lash
2-bobdagi pasport va MLflow bir-birini takrorlamaydi — ular bir-birini to'ldiradi:
import pandas as pd
show(pd.DataFrame([
    {"savol": "Qaysi ma'lumot?", "javob": "MLflow tegi: malumot_sha256 (2- va 5-boblar)"},
    {"savol": "Qaysi kod?", "javob": "MLflow git commit ni O'ZI yozadi (mlflow.source.git.commit)"},
    {"savol": "Qanday parametr?", "javob": "log_params"},
    {"savol": "Qanday natija?", "javob": "log_metrics"},
    {"savol": "Model qayerda?", "javob": "log_artifact -> keyingi bobda registr"},
]))
| savol | javob |
|---|---|
| Qaysi ma'lumot? | MLflow tegi: malumot_sha256 (2- va 5-boblar) |
| Qaysi kod? | MLflow git commit ni O'ZI yozadi (mlflow.source.git.commit) |
| Qanday parametr? | log_params |
| Qanday natija? | log_metrics |
| Model qayerda? | log_artifact -> keyingi bobda registr |
MLflow git commit ni avtomatik yozadi — agar skript git omborida ishga tushirilsa. Kitobdagi vaqtinchalik papkada git yo'q, shuning uchun bu teg bo'sh bo'ladi.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Uch tur | Parametr (kirish), metrika (natija), artefakt (fayl) |
| Avtomatik yozuv | Qo'lda jadval yuritish ishlamaydi — unutiladi |
| Taqqoslash | search_runs bilan bitta so'rov, F1 bo'yicha tartiblash |
| Yiqilgan tajriba | U ham yoziladi — sababi teg sifatida qoladi |
| SQLite ombori | Server kerak emas; jamoa uchun server + Postgres |
MLFLOW_TRACKING_URI |
Manzil konfiguratsiyada — kod o'zgarmaydi |
| Ortiqcha yozmang | Artefakt hajmi, maxfiylik va shovqin |
| Faqat F1 emas | Soddaroq model tezroq va barqarorroq bo'lishi mumkin |
Talaba ishi
bitta_yugurishga o'qitish vaqtini metrika sifatida qo'shing. Eng yaxshi F1 va eng tez model bir xilmi?mlflow.log_figurebilan ROC egri chizig'ini artefakt qilib saqlang.search_runsga filtr qo'shing: faqatf1 > 0.85bo'lganlarini ko'rsating (filter_string="metrics.f1 > 0.85").- Bir xil parametr bilan ikki marta ishga tushiring. Metrikalar bir xilmi? Agar ha — 2-bobdagi qaysi qoida ishladi?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.